Topic / Trend Rising

AI agentica e orchestrazione

Agenti, orchestrazione di strumenti e cicli di feedback in produzione stanno spostando l'AI dall'inference singola a flussi multi-step, esponendo sfide di affidabilità e integrazione.

Detected: 2026-08-13 · Updated: 2026-09-25

Articoli Correlati

2026-09-25 • AI News

Come aggiungere AI al software legacy senza riscriverlo

La convinzione che l’intelligenza artificiale imponga di riscrivere i sistemi legacy è spesso sbagliata. Esistono pattern di integrazione che trattano l’AI come un nuovo strato, non come una nuova fondazione: middleware, RAG, integrazione event-drive...

#LLM On-Premise #Fine-Tuning #DevOps
2026-09-25 • ArXiv cs.AI

Agenti di previsione, il ragionamento non è sempre la scelta giusta

Un gruppo di ricerca ha sottoposto gli agenti di previsione a stress test comportamentali per capire quando retrieval, ragionamento, prior di mercato o analoghi storici meritano fiducia. La scelta del meccanismo dipende dalla fonte. ReliabilityRoute ...

#LLM On-Premise #DevOps
2026-09-24 • DigiTimes

Intel: il coordinamento CPU-GPU al centro dell'AI agentica

Intel sposta il focus sull'AI agentica: il coordinamento tra CPU e GPU diventa il fulcro. La mossa segnala una rilettura dell'hardware per workload che non si esauriscono in una singola inference, ma concatenano ragionamento, tool calling e memoria. ...

#Hardware #LLM On-Premise #DevOps
2026-09-22 • LocalLLaMA

LLM locale e vLLM: automatizzare le modifiche senza perdere il controllo

Un utente self-hosted racconta di aver chiesto al suo LLM locale di modificare vLLM per ridurre i consumi in idle con CUDA_DISABLE_PERF_BOOST=1. La scena mostra potenzialità e rischi dell'automazione operativa: risparmio energetico reale, ma anche ne...

#Hardware #LLM On-Premise #DevOps
2026-09-22 • PyTorch Blog

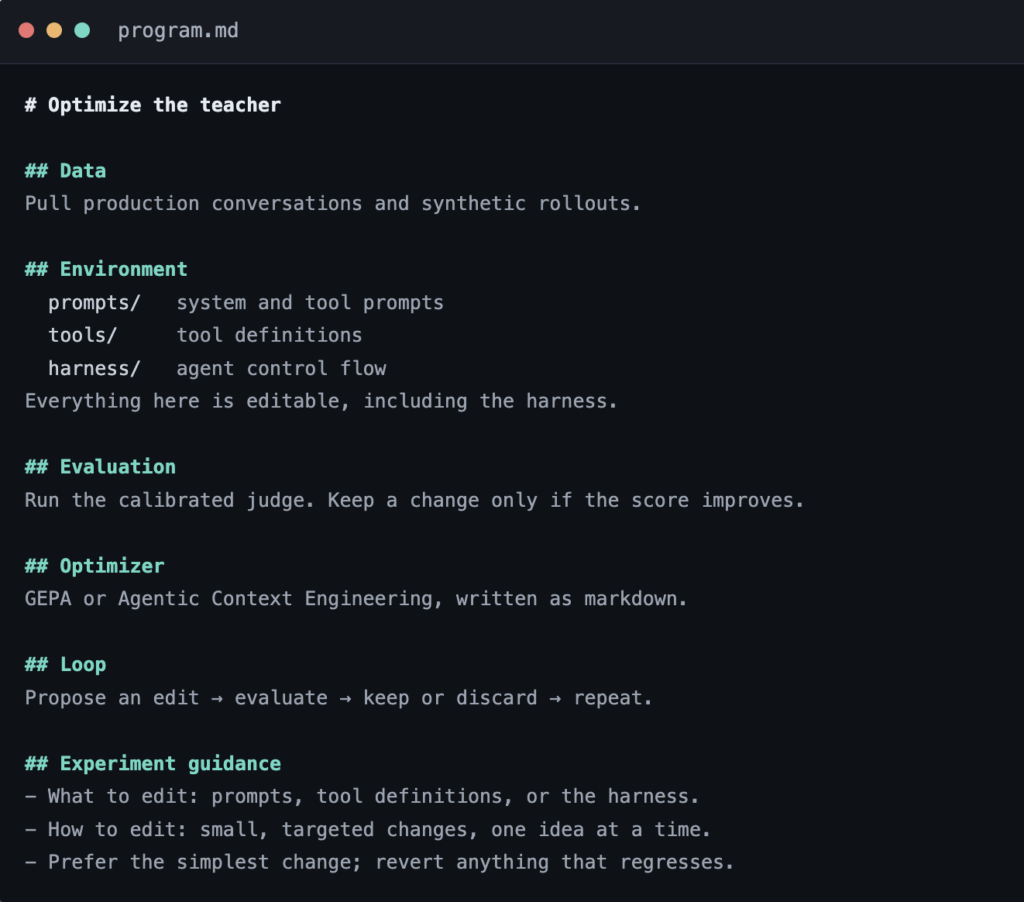
Shopify ha chiuso il loop: gli errori di produzione diventano pesi del modello

Shopify descrive un loop di apprendimento continuo basato su PyTorch e vLLM: gli errori di produzione diventano aggiornamenti dei pesi del modello. L'agente GraphQL supera la qualità del modello frontier e taglia il costo di serving del 96%, passando...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-21 • ArXiv cs.LG

BI-Bench e BI-Agent: il vero divario è nell'orchestrazione dei dati

La BI end-to-end rivela un limite strutturale dei LLM: sotto il 50% di accuratezza senza guida umana. Il guadagno vero arriva da architetture che orchestrano strumenti e da post-training su dati proprietari. Per chi valuta on-premise e self-hosted, i...

2026-09-21 • ArXiv cs.LG

BI-Bench e BI-Agent: il divario dei LLM nella BI end-to-end

Il benchmark BI-Bench, costruito su progetti reali e dashboard pubbliche, mostra che anche i LLM frontier restano sotto il 50% di accuratezza nella business intelligence end-to-end. BI-Agent, un agente tool-augmented che scompone ricerca, join e tras...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-17 • LocalLLaMA

63 ore di inference autonoma su una RTX 3090 per Riemann

Un ricercatore ha lasciato un Qwen 3.8 da 27B in quantization a 4 bit e con 100K token di contesto lavorare per 63 ore su una singola RTX 3090. Ha generato oltre 50 milioni di token senza risolvere la congettura di Riemann, ma mostrando memoria organ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-16 • Tom's Hardware

Un bot con GPT-6 Astra domina Balatro a Gold Stake: il ruolo di Python

La notizia è essenziale: un appassionato avrebbe usato un bot basato su GPT-6 Astra e Python per battere ripetutamente la difficoltà più alta di Balatro, Gold Stake con Black Deck. Pochi dettagli tecnici, ma il caso apre una riflessione su LLM, ragio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-16 • DigiTimes

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

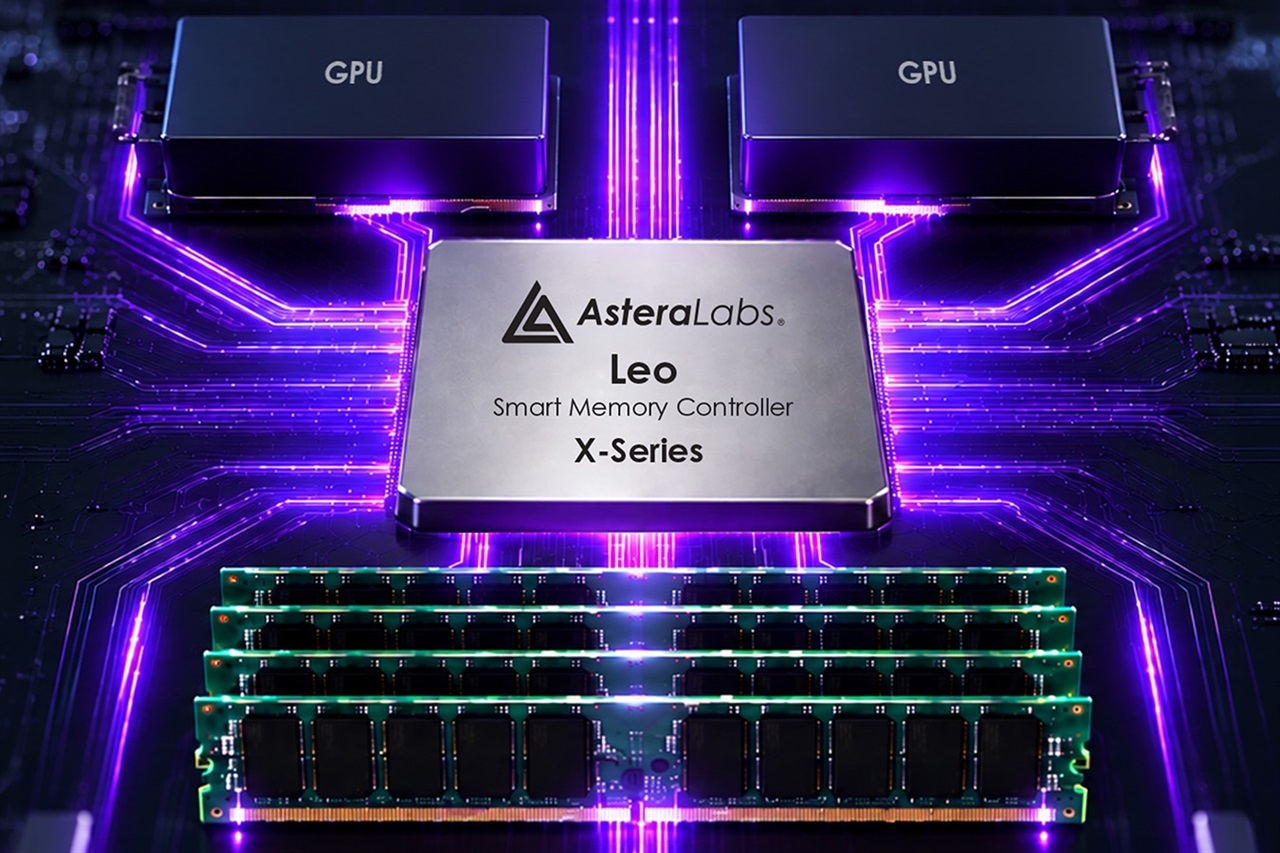
La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria ...

2026-09-15 • DigiTimes

Astera Labs affronta il collo di bottiglia della cache KV nell'AI agentica

Quando i sistemi agentici moltiplicano i token di contesto, la cache KV cresce fino a saturare la VRAM delle GPU. Astera Labs punta a questo limite strutturale, segnalando uno spostamento dell'attenzione dal calcolo alla memoria e alle interconnessio...

#Hardware #LLM On-Premise #DevOps
2026-09-15 • TechWire Asia

Ant nomina 10 wallet asiatici per AMP, ma nessuna data di lancio

Ant International ha elencato 10 wallet Alipay+ e 7 acquirer per la Fase I dell’Agentic Mobile Protocol nel 2026. Nessun partner ha indicato una data di go-live e Ant non comunica volumi transati da aprile. Gli impegni dichiarati riguardano identità ...

2026-09-15 • ArXiv cs.CL

PhysMent: il benchmark che trasforma gli LLM in sperimentatori attivi

PhysMent valuta gli LLM su 105 scene di meccanica classica nel simulatore MuJoCo: i modelli devono applicare forze, interrogare stati, avanzare il tempo e modificare la geometria prima di rispondere. Nei compiti quantitativi multi-step la maggior par...

#LLM On-Premise #Fine-Tuning #DevOps

2026-09-15 • ArXiv cs.LG

Il budget di token diventa la variabile chiave per gli agenti LLM locali

BudgetBench propone un protocollo e un harness per confrontare strategie di memoria negli agenti LLM locali, trattando il budget di token per chiamata come variabile indipendente. I test pilota su qwen2.5:1.5b, Qwen3 30B-A3B e LongMemEval mostrano vi...

#Hardware #LLM On-Premise #DevOps
2026-09-14 • OpenAI Blog

Fyxer e l'assistente AI che impara la voce di chi lo usa

Fyxer usa modelli OpenAI, fine-tuning, memoria e feedback reale per organizzare le caselle email e redigere messaggi nella voce di ogni utente. La notizia segnala uno spostamento del valore: non è il modello a fare la differenza, ma il ciclo di calib...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-13 • LocalLLaMA

Claude Code verso il self-hosted: serve un harness, non un miracolo

Un utente abituato a Claude Code chiede quale harness locale open source possa sostituirlo su una RTX 3090 da 24 GB di VRAM. Non cerca un LLM più potente, ma un ambiente agente che replichi il loop di modifica ed esecuzione. La richiesta anticipa tim...

#LLM On-Premise #DevOps
2026-08-13 • ArXiv cs.AI

Governare LLM in conflitto: il controllo che evita il collasso del dialogo

Due agenti LLM con obiettivi opposti non competono: collassano. Experience Orchestrator, testato in 60.000 simulazioni in servizi finanziari, aggiunge un livello di controllo con Contextual Bandit, PID e POMDP. Il tasso di contatto ad alto intento sa...

#Hardware #LLM On-Premise #DevOps
2026-08-12 • ArXiv cs.CL

LLM Agents Factory: la fabbrica di agenti che riduce i costi di inference

Un framework basato su retrieval e distillazione consente di costruire agenti LLM specializzati senza generazione al volo, riducendo drasticamente i costi computazionali e migliorando la stabilità. I test mostrano accuratezza paragonabile ad AutoGen ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-08-08 • LocalLLaMA

Minimalismo radicale: un agente di coding in 9 righe Python e zero dipendenze

Un esperimento open source mostra un agente di coding essenziale: 9 righe di Python, solo standard library, nessuna dipendenza esterna. Funziona con qualsiasi API compatibile OpenAI Responses, usa un singolo tool sh, cache via session_id e mostra l’u...

#Hardware #LLM On-Premise #DevOps
2026-08-07 • ArXiv cs.LG

CRAFTER: l'agente che raddoppia i miglioramenti senza toccare il modello

Un sistema a due generatori scandaglia i residui di un previsore frozen per estrarre feature correttive interpretabili. Un LLM suggerisce combinazioni, flag e codice breve; un gate di validazione decide se applicarle. Su sei dataset e sei backbone, C...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic