Topic / Trend Rising

Mercato degli acceleratori AI e pressioni sull’offerta GPU

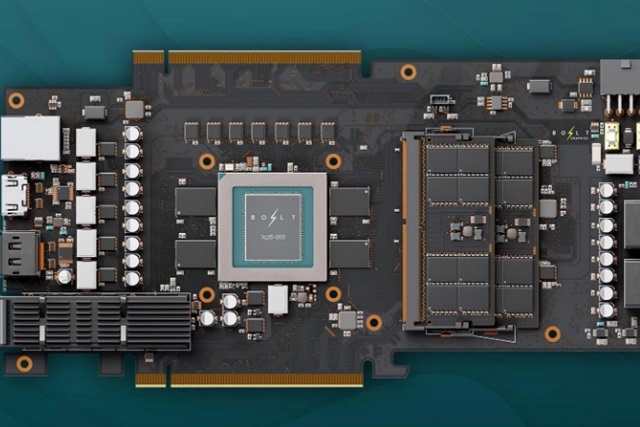
Le GPU consumer stanno diventando scarse, costose o contraffatte mentre la domanda di AI spinge i vendor verso acceleratori enterprise e professionali. Intel, AMD, Biren e la nuova arrivata Bolt Graphics si stanno riposizionando sull’hardware per inference.

Detected: 2026-10-16 · Updated: 2026-10-16

Articoli Correlati

2026-10-15 • LocalLLaMA

RTX 5060 Ti a $1.292 in Giappone: il Black Friday delle GPU è già un test

La RTX 5060 Ti da 16 GB tocca 1.292 dollari in Giappone con aumenti fino al 144%; la RTX 5080 supera i 2.400. Più che un problema di gaming, è il segnale di una domanda di VRAM contesa con l’inference locale di LLM. I prezzi finali mettono in discuss...

#Hardware #LLM On-Premise #DevOps
2026-10-15 • LocalLLaMA

AMD W7900 e LFM2.5: il segnale di un on-premise sempre più concreto

La prova di un LLM da 24 miliardi di parametri su AMD W7900, con contesto da 128.000 token e circa 95 token al secondo, segnala che l'inference on-premise si consolida anche fuori dall'ecosistema NVIDIA. L'analisi di AI-Radar esplora trade-off, sovra...

2026-10-15 • LocalLLaMA

LiquidAI LFM2.5-24-A2B: performance robuste su AMD W7900 per LLM on-premise

Un utente ha condiviso un'esperienza positiva con il modello LiquidAI LFM2.5-24-A2B (24B parametri), evidenziando performance elevate (~95 tps) su GPU AMD W7900. Il modello, che richiede 30GB di VRAM per la quantization Q8 con un contesto di 128k tok...

#Hardware #LLM On-Premise #DevOps
2026-10-12 • LocalLLaMA

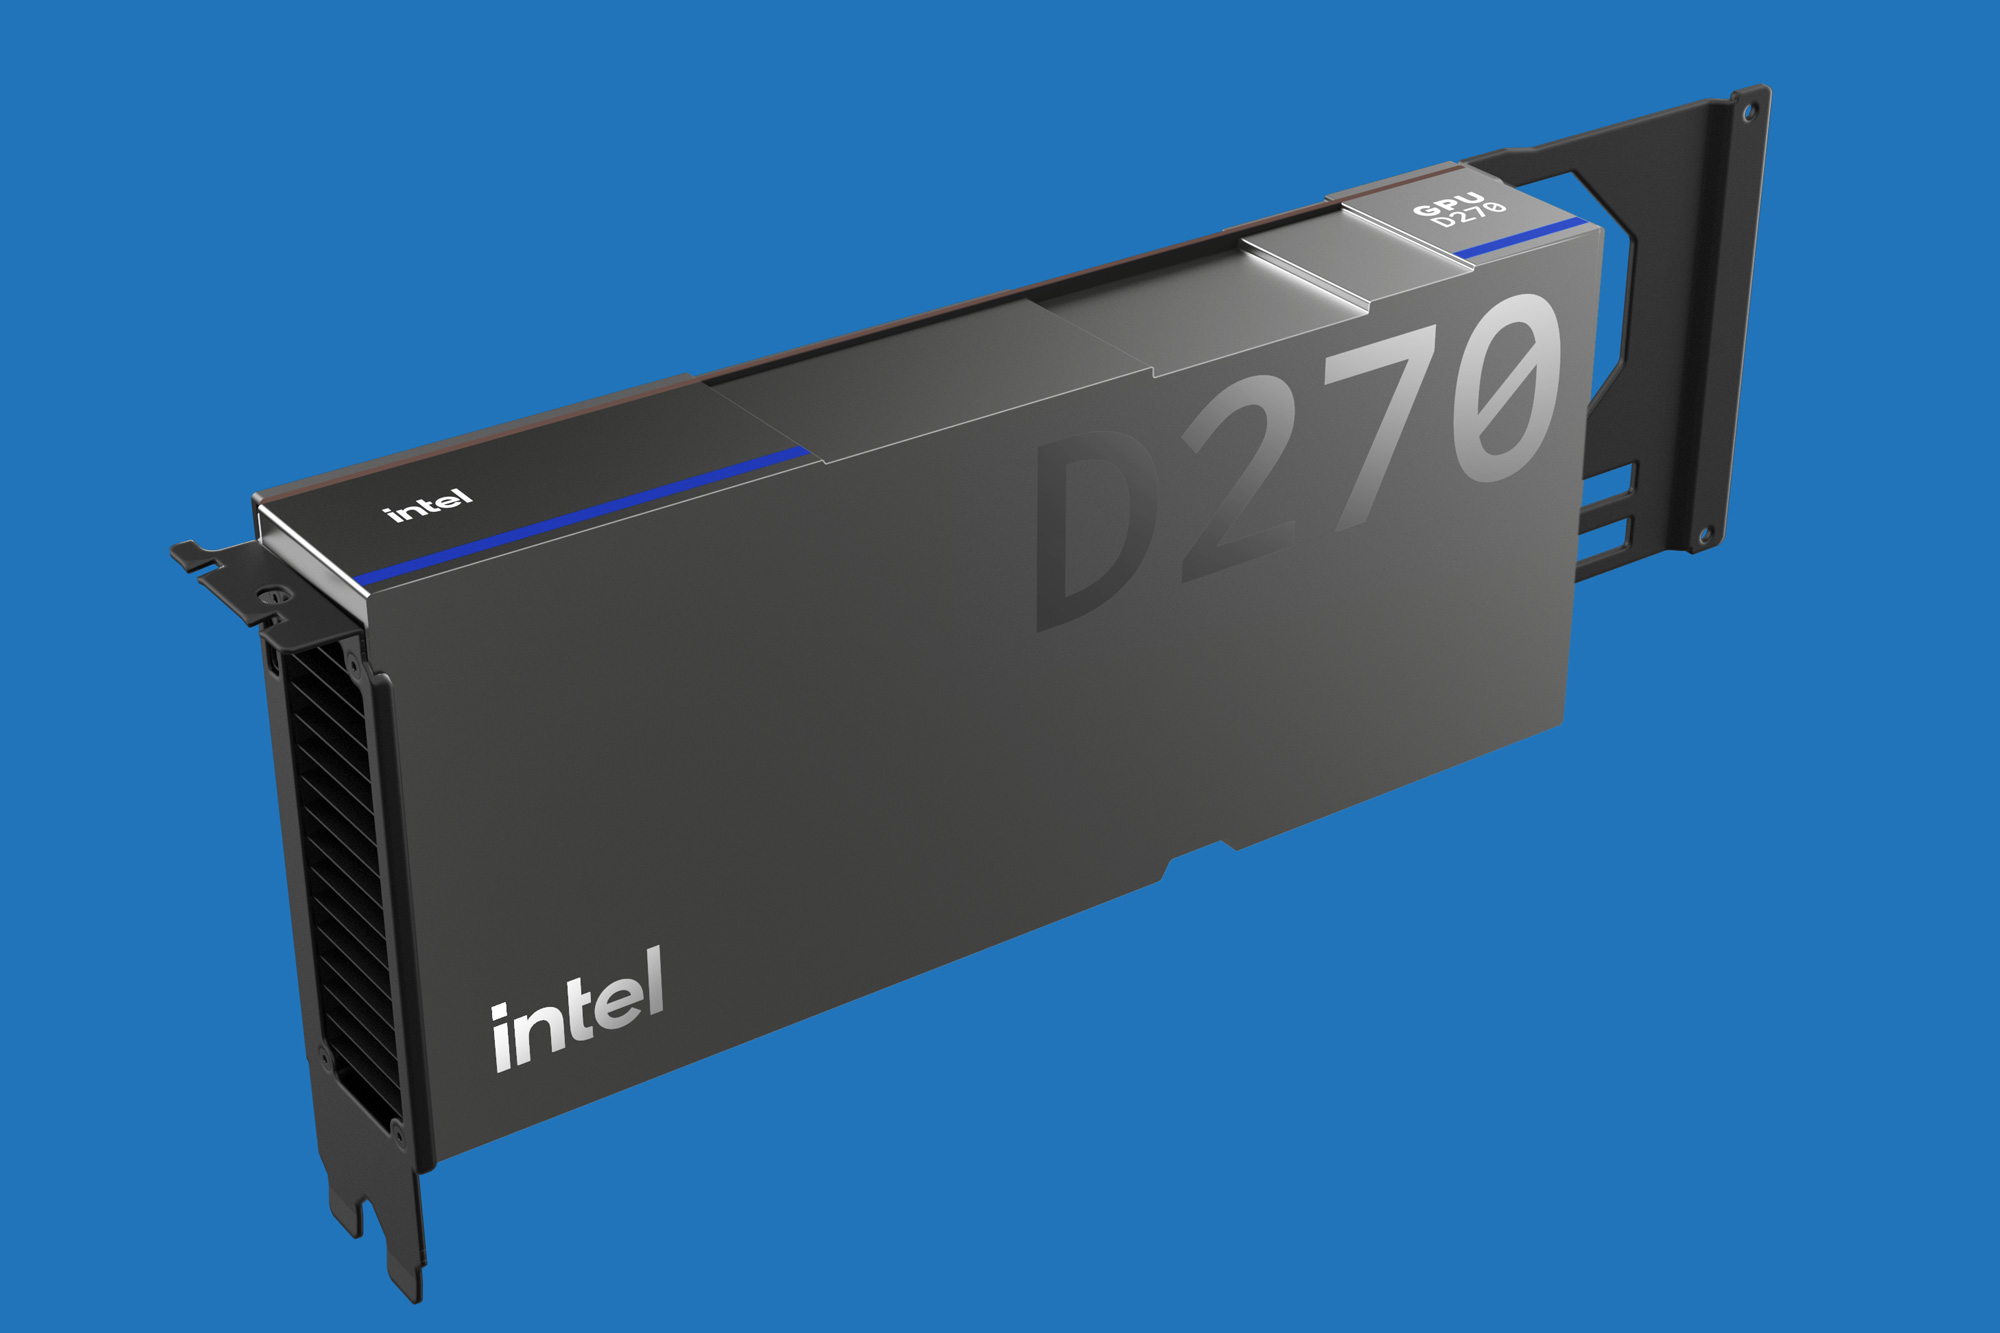
Intel Crescent Island diventa D-Series: fino a 480 GB di LPDDR5X

Intel ha trasformato Crescent Island in una linea commerciale: D-Series. La scheda D270 integra 32 core Xe3P, 256 XMX engine, fino a 480 GB di LPDDR5X e 1,5 TB/s di banda. Le prestazioni dichiarate arrivano a 1,3 PetaFLOPS FP8, con supporto da FP4 a ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-12 • Phoronix

Da Crescent Island alla serie D: Intel punta sull’inference aziendale

Intel ha annunciato la serie GPU D, erede dei prodotti noti come Crescent Island e pensata per l’inference in ambito enterprise. L’annuncio non include specifiche su VRAM o prestazioni, ma il cambio di denominazione segnala un posizionamento più dire...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-12 • ServeTheHome

Intel D-Series: la D270 sceglie l’inference con FP8 e 1,5 TB/s

Intel svela nome e specifiche della scheda di inference per data center Crescent Island: D-Series e D270 con 1,3 PFLOPS FP8 denso e 1,5 TB/s di banda memoria. Un indizio per chi valuta hardware on-prem per LLM.

#Hardware #LLM On-Premise #Fine-Tuning

2026-10-12 • LocalLLaMA

RTX 5080 da 24 GB: un rumor del 2027 che sposta gli equilibri on-premise

Un rumor da Reddit indica una RTX 5080 da 24 GB nel primo trimestre 2027, ma i partner non hanno ancora dettagli. Per chi fa inference locale di LLM, la VRAM è il vincolo chiave. Il silenzio informativo rallenta integratori e progettisti di macchine ...

#Hardware #LLM On-Premise #DevOps
2026-10-12 • Tom's Hardware

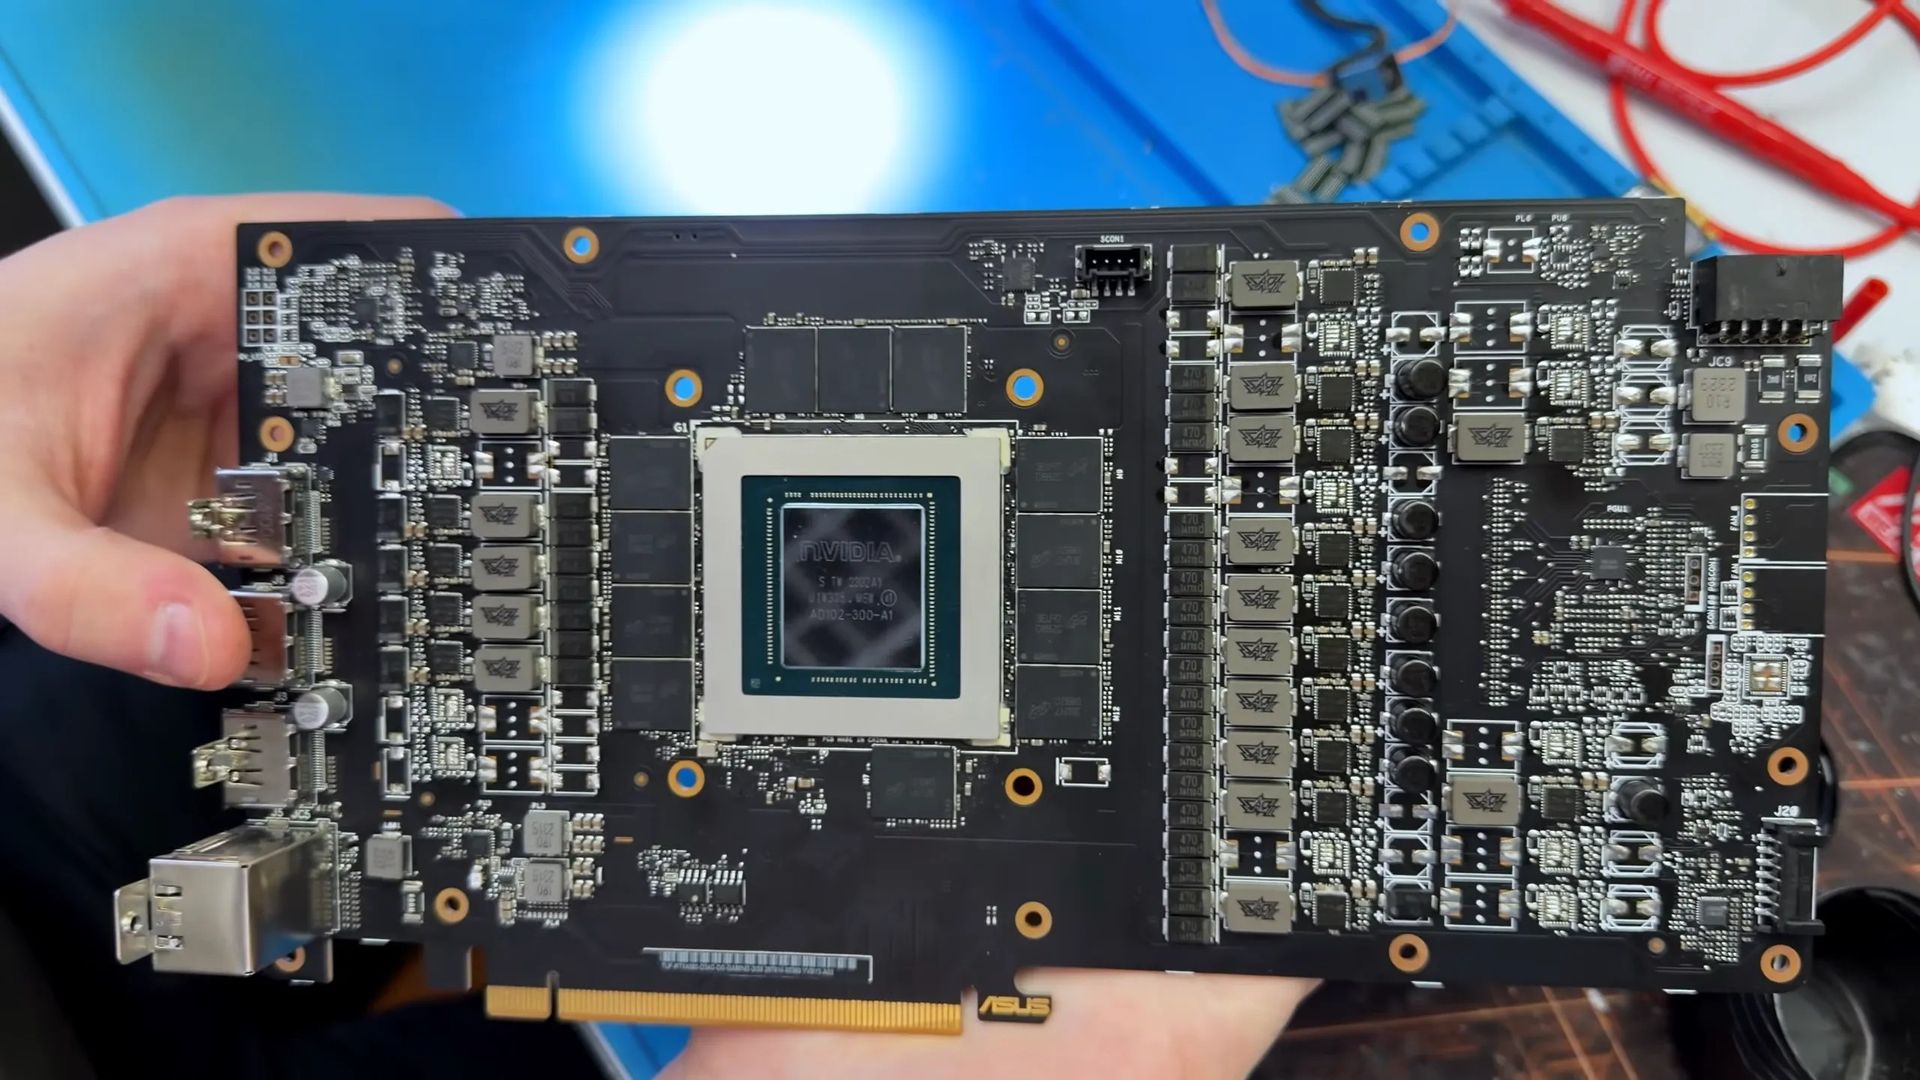
RTX 4090 'rotta' a 350 dollari: dentro una GPU falsa e memoria sostituita

Un acquirente ha pagato 350 dollari per una RTX 4090 rotta, ma il tecnico ha scoperto una GPU falsa e memorie sostituite. La truffa, documentata da un riparatore russo, usa PCB dummy sofisticati. Per chi costruisce infrastrutture LLM on-premise, l'ep...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-11 • LocalLLaMA

RTX 4090 contraffatte: la falla hardware dell'inference self-hosted

La circolazione di RTX 4090 contraffatte, quasi indistinguibili all'ispezione visiva e ai primi test software, trasforma l'acquisto di GPU consumer per LLM on-premise in un rischio strutturale. Il danno non si limita alla sostituzione: include instab...

2026-10-11 • LocalLLaMA

RTX 4090 contraffatte: il rischio nascosto per l'inference on-premise

Segnalazioni indicano nuove RTX 4090 contraffatte con GPU e memoria quasi indistinguibili dai chip originali. Per chi costruisce infrastrutture self-hosted per LLM, il rischio non è solo economico: componenti non certificati introducono incognite su ...

#Hardware #LLM On-Premise #Fine-Tuning

2026-10-10 • Tom's Hardware

Nvidia fermerebbe la RTX 5090 per dare priorità alle GPU AI

Secondo indiscrezioni, Nvidia avrebbe sospeso la produzione della GeForce RTX 5090 per concentrare la capacità sulle GPU per data center AI e workstation professionali. La scelta segnala una priorità industriale netta: i margini del calcolo accelerat...

#Hardware #LLM On-Premise #Fine-Tuning

2026-10-10 • LocalLLaMA

NVIDIA potrebbe ritirare la RTX 5090: GB202 destinato alle RTX PRO

Secondo una voce non confermata, NVIDIA starebbe interrompendo la GeForce RTX 5090 per destinare i chip GB202 alla serie RTX PRO. Se confermata, la mossa sposterebbe l'offerta di GPU consumer verso il segmento professionale, con effetti sul mercato s...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic