Topic / Trend Rising

Cache KV e ottimizzazione per contesti lunghi

La cache KV sta diventando un collo di bottiglia infrastrutturale centrale per carichi agentici e a contesto lungo, spingendo nuovi metodi di attenzione sparsa appresi o training-free.

Detected: 2026-09-22 · Updated: 2026-09-22

Articoli Correlati

2026-09-21 • ArXiv cs.LG

Elastic Threshold Attention: sparsità appresa per il decoding long-context

Un’architettura addestrabile end-to-end sostituisce le euristiche rigide con soglie contestuali dinamiche, riducendo il traffico della KV cache senza perdere qualità. Il modello da 1,45 miliardi di parametri ottiene un decoding fino a 2,5 volte più v...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-21 • ArXiv cs.AI

RBS-Attention: sparse prefill senza addestramento per LLM a contesto lungo

Un metodo training-free riduce il costo del prefill nei LLM a contesto lungo affrontando la 'mean dilution', il rischio che un centroide nasconda token rilevanti. RBS-Attention combina un ramo basato sul centroide con un ramo rescue basato sul raggio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-16 • DigiTimes

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

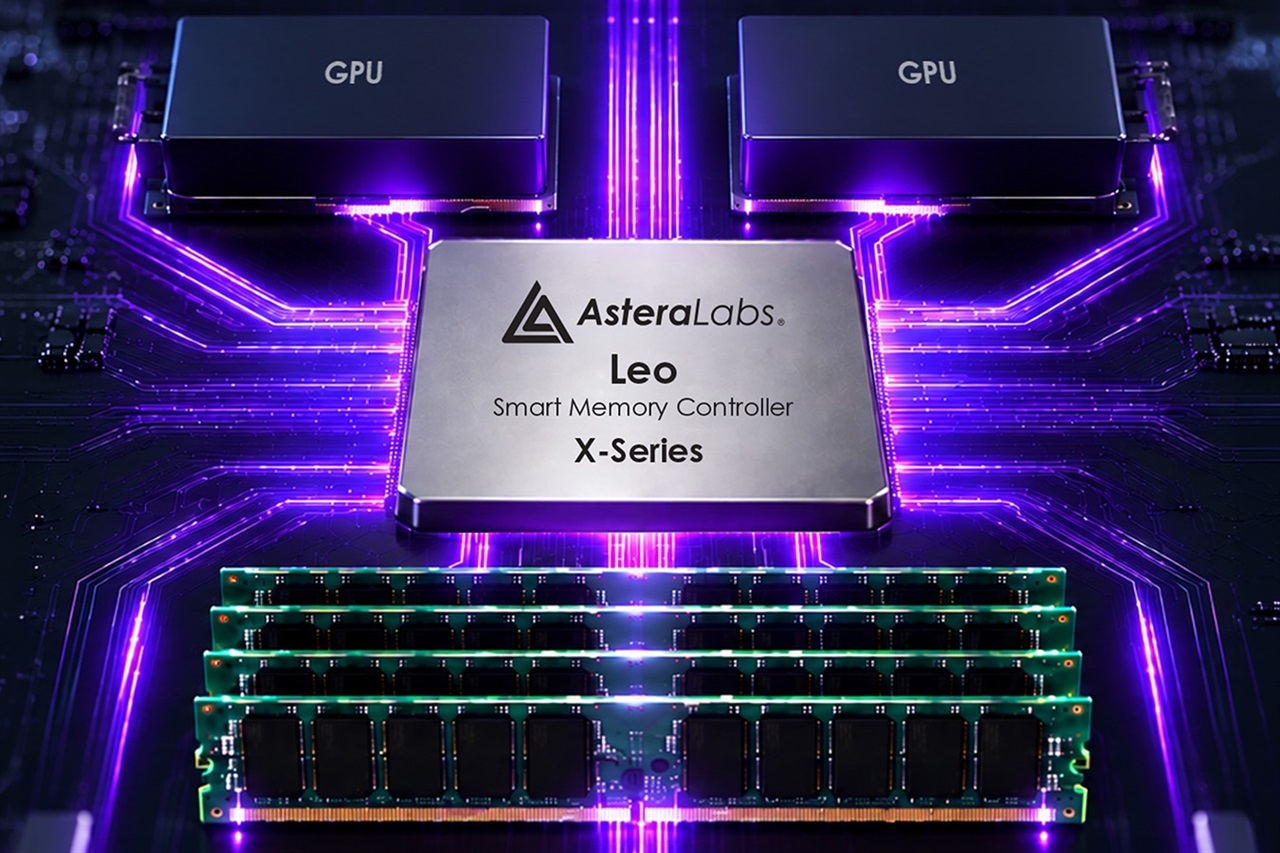
La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria ...

2026-09-15 • DigiTimes

Astera Labs affronta il collo di bottiglia della cache KV nell'AI agentica

Quando i sistemi agentici moltiplicano i token di contesto, la cache KV cresce fino a saturare la VRAM delle GPU. Astera Labs punta a questo limite strutturale, segnalando uno spostamento dell'attenzione dal calcolo alla memoria e alle interconnessio...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic