Topic / Trend Rising

Efficienza dell'Inference LLM e Ottimizzazione dei Kernel

L'inference viene ottimizzata su tutta la pila con decoding speculativo, kernel CPU per k-quant, autotuning GEMM in vLLM, alternative low-rank all'attenzione e cicli di test-time compute. Questi cambiamenti riducono FLOPs, VRAM e latenza per deployment più piccoli o economici.

Detected: 2026-10-03 · Updated: 2026-10-03

Articoli Correlati

2026-10-02 • PyTorch Blog

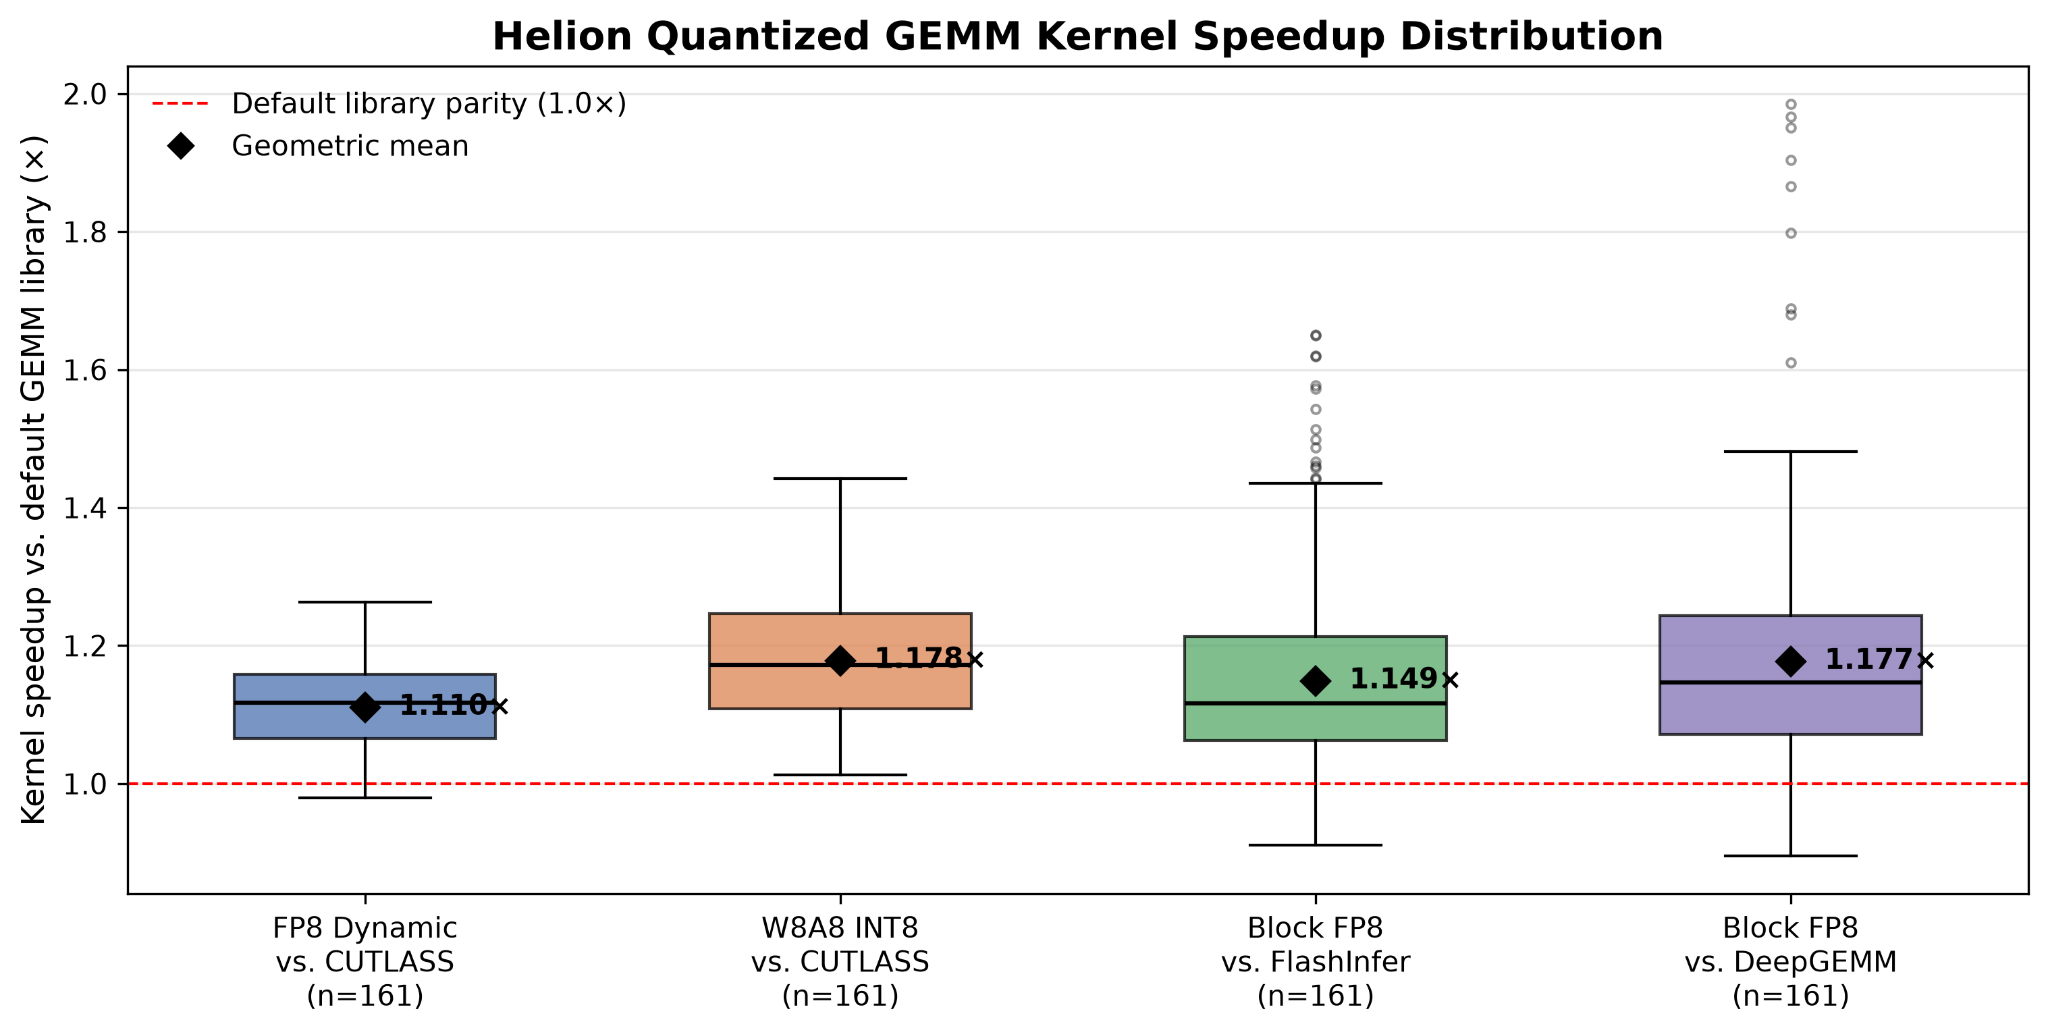
Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%

Red Hat e Meta hanno integrato Helion nel backend lineare di vLLM. Un'unica implementazione GEMM copre Standard, Split-K e Swap-AB, con autotuning per forma su GPU Hopper. Nei test su H100, i kernel superano CUTLASS, FlashInfer e DeepGEMM, con miglio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-01 • PyTorch Blog

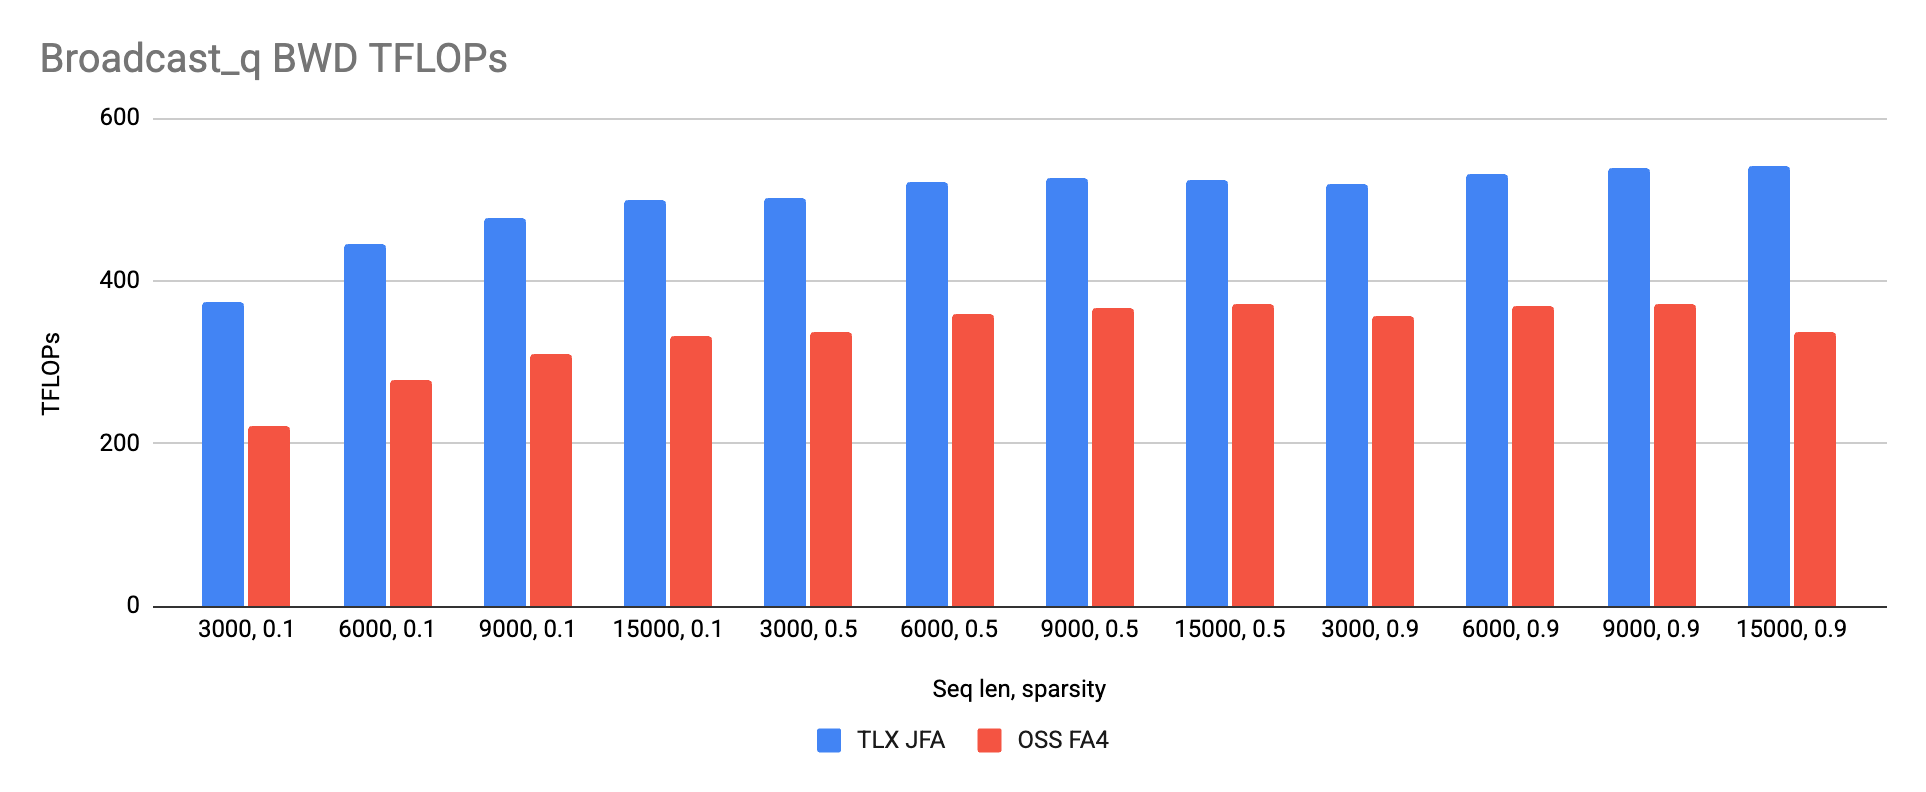
TLX porta l'attenzione jagged su Blackwell oltre FA4, con un terzo del codice

Il kernel attention di Meta per GEM, riscritto in TLX, supera FlashAttention-4 sui carichi jagged Blackwell: +13% in forward e +50% in backward in media, con circa 3.200 righe contro 10.000. Il risultato mostra che il controllo hardware esplicito non...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-30 • ArXiv cs.AI

Fine-tuning oltre il testo: DASA trasforma il gradiente nel dataset

DASA genera embedding sintetici dai gradienti di attivazione di un modello congelato, addestrando LLM senza passare da testo leggibile. I test su Llama e Qwen mostrano prestazioni simili o superiori ai dati testuali, con speedup fino a 4,9 volte risp...

2026-09-30 • ArXiv cs.AI

Fine-tuning LLM senza testo leggibile: cosa cambia con DASA

Un nuovo metodo, DASA, genera dati sintetici per il fine-tuning sotto forma di embedding continui, guidati dai gradienti di attivazione di un modello di riferimento. Nei test su sei modelli Llama e Qwen, con LoRA, raggiunge prestazioni pari o superio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-29 • LocalLLaMA

NVIDIA Nemotron 3 supera l'oro alle IOI 2026 con test-time compute

La scheda di NVIDIA Nemotron-Labs-3-Competitive-Coding descrive un modello da 550B-A55B fine-tuned su 477.642 tracce sintetiche distillate da GLM-5.2. Con la strategia GenCorrect, ha ottenuto 535,4/600 alle IOI 2026, superando soglia oro e miglior pu...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-27 • LocalLLaMA

Penalizzare i token di overthinking migliora i Qwen in formato GGUF

Un test su 50 domande del benchmark MATH-500 mostra che penalizzare via logit-bias i token di esitazione migliora l'accuratezza di Qwen3.5-4B in formato GGUF su tutti i livelli di quantization testati. In BF16 si passa dal 74% all'84%, mentre Q2_K ra...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-27 • LocalLLaMA

llama.cpp accelera di 42 volte il prompt lookup drafting

Il runtime open source per l'inference locale dei LLM introduce un miglioramento che rende la fase di prompt lookup drafting 42 volte più veloce. Non si tratta dell'intera generazione, ma di un componente chiave della decodifica speculativa: un cambi...

#Hardware #LLM On-Premise #DevOps
2026-09-26 • LocalLLaMA

llama.cpp accelera il prefill su CPU con mul_mat a tessere per k-quants

Una pull request in llama.cpp introduce una moltiplicazione matrice-vettore a tessere per i formati k-quants. Secondo la segnalazione, l'uso delle istruzioni VNNI accelera il mul_mat su CPU di 3-7 volte con complessità aggiuntiva minima. Il guadagno ...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic