Topic / Trend Rising

Diversificazione dell'hardware per l'AI locale

L'AI on-premise si sta espandendo oltre le GPU da data center verso AMD ROCm, NVIDIA GB300, FPGA, mini PC, iPad con eGPU e configurazioni desktop multi-nodo.

Detected: 2026-10-10 · Updated: 2026-10-10

Articoli Correlati

2026-10-09 • LocalLLaMA

Qwen3.8-27B su iPad Pro via eGPU: 159 token/s su R9700

LemonSeed Studio porta l'inference locale di Qwen3.8-27B su iPad Pro usando una GPU AMD esterna in enclosure Thunderbolt. Il motore LSE, identico su iPadOS, macOS e Linux, raggiunge 158,5 token/s su R9700 con decodifica speculativa DFlash2 e 64,4 su ...

#Hardware #LLM On-Premise #DevOps

2026-10-06 • ServeTheHome

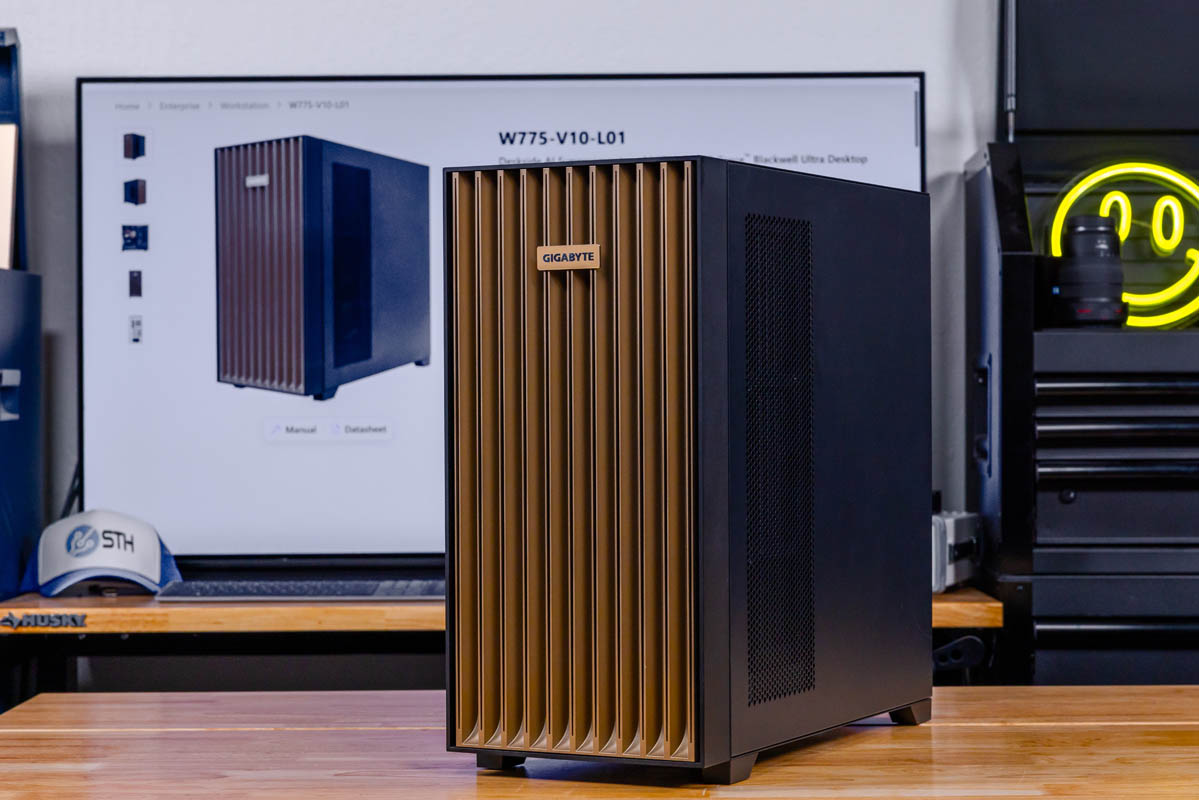
Gigabyte W775-V10-L01: il GB300 porta l'inference locale in formato deskside

Gigabyte ha testato il sistema W775-V10-L01 con NVIDIA GB300, registrando oltre 2,2 miliardi di token al giorno sulla GPU Blackwell Ultra, 800 Gbps dalla ConnectX-8 SuperNIC e il collegamento C2C tra CPU Grace e GPU. Il banco prova deskside segnala c...

#Hardware #LLM On-Premise #DevOps
2026-10-06 • Phoronix

Vulkan e driver RADV: Valve allunga la vita delle GPU AMD Polaris su Linux

Il team Linux graphics di Valve, con Timur Kristóf, prosegue il lavoro sui driver open source per vecchie GPU AMD. Dopo la migrazione delle architetture GCN 1.0/1.1 al driver AMDGPU, ora migliora il supporto Vulkan RADV per le Radeon RX 400/500 Polar...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-06 • Phoronix

ROCm 10.1: la cadenza software che riscrive il TCO on-premise

ROCm 10.1 conferma il ciclo di sei settimane di AMD per lo stack GPU. Più delle singole funzionalità, conta la prevedibilità: per i deployment self-hosted riduce il rischio di restare bloccati su versioni vecchie e rende il software parte governabile...

2026-10-05 • Phoronix

ROCm 10.1: il ciclo di sei settimane diventa la vera notizia

AMD ha rilasciato ROCm 10.1, poche settimane dopo ROCm 10.0 di fine agosto, confermando il ciclo di aggiornamenti ogni sei settimane. La notizia rilevante non è solo il nuovo pacchetto, ma la cadenza: per chi usa GPU AMD in ambienti self-hosted, la p...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-05 • Phoronix

Server AI locali, AMD tra ROCm e Vulkan: il test con Llama.cpp

Phoronix mette a confronto i backend Vulkan e ROCm di Llama.cpp su due macchine con GPU AMD Radeon e il server AI locale Lemonade. Il test segnala una scelta strutturale per lo stack self-hosted su AMD: compatibilità hardware contro prestazioni ottim...

#Hardware #LLM On-Premise
2026-10-04 • LocalLLaMA

Due DGX Spark in casa: GLM 5.3 Flash gira in locale a velocità interattive

Un utente ha assemblato un setup di inference interamente locale con GLM 5.3 Flash su due DGX Spark, usando vLLM con parallelismo tensoriale a due vie. I numeri dichiarati: prefill a circa 1.500 token/s e decode a circa 40 token/s con 100mila token d...

#Hardware #LLM On-Premise #DevOps

2026-10-04 • LocalLLaMA

FPGA ex-mining per Qwen3.5-9B: inference locale a basso costo

Un progetto GitHub esegue un LLM Qwen3.5-9B INT4 su FPGA SQRL ex-mining. Con due FK33 a 75 MHz si ottengono 3,2 token/s in generazione a contesti brevi e 2,4 token/s tra 2k e 3k token. Le stime per Qwen3.8-27B arrivano a 25 token/s con quattro die XC...

#Hardware #LLM On-Premise #DevOps

2026-10-04 • Tom's Hardware

RTX 5090, il connettore che fonde e la soluzione custom di un modder

Un modder ha affrontato il problema dei connettori di alimentazione fusi sulle RTX 5090 con un distributore personalizzato. La vicenda segnala margini di progettazione ristretti per le GPU di fascia alta usate nei carichi continui di inference locale...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-03 • LocalLLaMA

Due MoE da 300B su un mini PC da 128 GB: Kyojin spinge Strix Halo

Il progetto Kyojin porta due modelli MoE da circa 300 miliardi di parametri su un singolo mini PC con AMD Strix Halo e 128 GB di memoria. Misurati su Ryzen AI Max+ 395, GLM-5.3-Flash e MiMo-V2.6-Flash raggiungono prefill fino a 650 token/s e decode f...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic