Topic / Trend Rising

Accelerazione dell'inference LLM locale

I miglioramenti a runtime e nel deployment, come speculative decoding, motori di inference specializzati e ottimizzazioni per hardware consumer, rendono l'esecuzione locale degli LLM più veloce e pratica. Questo cambiamento riduce la dipendenza dal cloud per coding, chat e deployment on-premise.

Detected: 2026-10-06 · Updated: 2026-10-07

Articoli Correlati

2026-10-06 • ServeTheHome

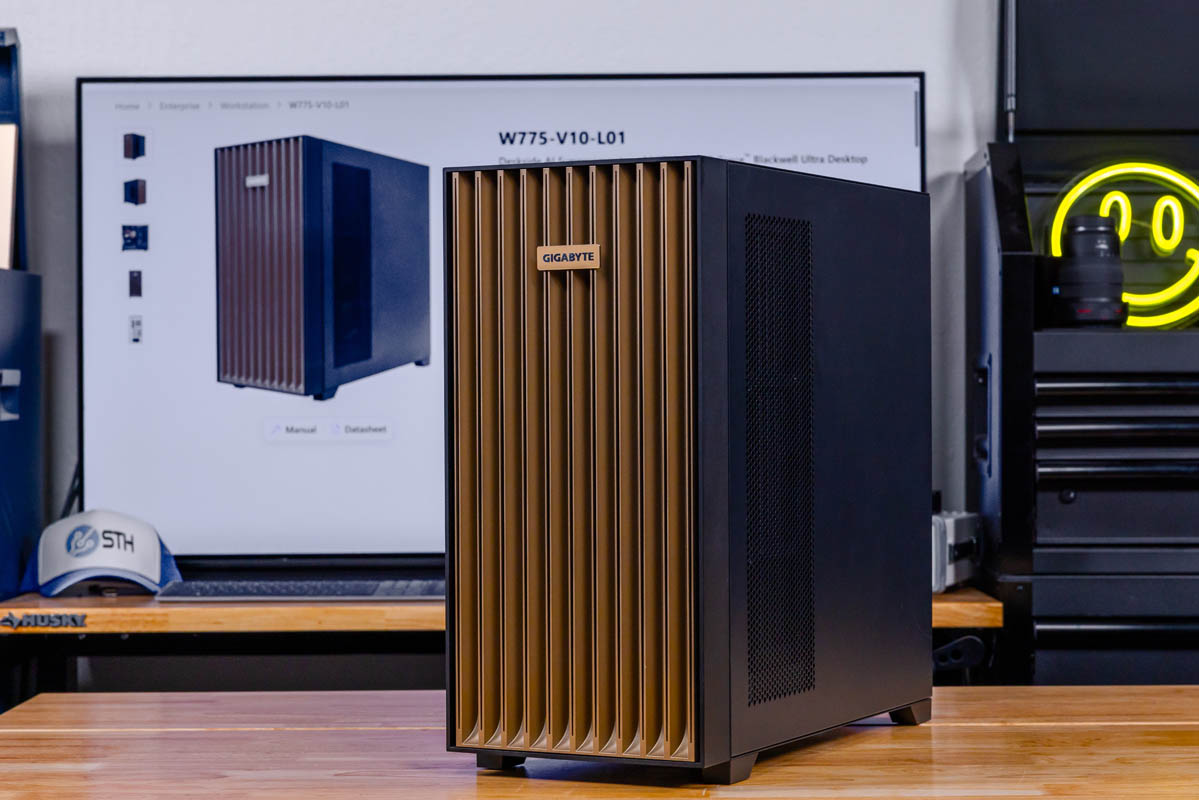
Gigabyte W775-V10-L01: il GB300 porta l'inference locale in formato deskside

Gigabyte ha testato il sistema W775-V10-L01 con NVIDIA GB300, registrando oltre 2,2 miliardi di token al giorno sulla GPU Blackwell Ultra, 800 Gbps dalla ConnectX-8 SuperNIC e il collegamento C2C tra CPU Grace e GPU. Il banco prova deskside segnala c...

#Hardware #LLM On-Premise #DevOps
2026-10-05 • LocalLLaMA

llama.cpp 0.6.0 accelera l'inference locale con il MTP speculative decoding

Il runtime per inference locale llama.cpp arriva alla versione 0.6.0 introducendo il supporto al speculative decoding MTP per i modelli Qwen4Exp. Una novità che rafforza il percorso degli LLM self-hosted, dove il controllo dell'hardware e della pipel...

#Hardware #LLM On-Premise #DevOps

2026-10-05 • LocalLLaMA

Una RTX 5090 sfida Claude Code: la harness è decisiva

Un benchmark comunitario mostra che configurazioni locali con RTX 5090 raggiungono il 96% su task di coding, avvicinandosi al 100% di Claude Code Opus 5.5. La variabile critica non è solo il modello: con la stessa GPU e quantization identica, la harn...

#Hardware #LLM On-Premise #DevOps
2026-10-05 • LocalLLaMA

Un LLM locale infila Lee Kuan Yew in un refactoring di codice

Un utente con RTX 5070 Ti e Strata osserva un modello Qwen3.8-27B IQ3_XXS accelerare di 2-3 volte, ma durante un task di rimozione codice ridondante i ragionamenti inseriscono una biografia di Lee Kuan Yew. Il caso mostra come i pensieri dei modelli ...

#LLM On-Premise #DevOps
2026-10-04 • LocalLLaMA

Due DGX Spark in casa: GLM 5.3 Flash gira in locale a velocità interattive

Un utente ha assemblato un setup di inference interamente locale con GLM 5.3 Flash su due DGX Spark, usando vLLM con parallelismo tensoriale a due vie. I numeri dichiarati: prefill a circa 1.500 token/s e decode a circa 40 token/s con 100mila token d...

#Hardware #LLM On-Premise #DevOps

2026-10-04 • LocalLLaMA

FPGA ex-mining per Qwen3.5-9B: inference locale a basso costo

Un progetto GitHub esegue un LLM Qwen3.5-9B INT4 su FPGA SQRL ex-mining. Con due FK33 a 75 MHz si ottengono 3,2 token/s in generazione a contesti brevi e 2,4 token/s tra 2k e 3k token. Le stime per Qwen3.8-27B arrivano a 25 token/s con quattro die XC...

#Hardware #LLM On-Premise #DevOps

2026-10-04 • LocalLLaMA

IQ3_S in loop dopo 10k token: il runtime è parte del problema

Un test sul campo con una quantization IQ3_S mostra che lo stesso identico modello può produrre una risposta coerente in llama.cpp e un loop ripetitivo altrove. Il racconto mette in discussione l'idea che basti scegliere il modello giusto: runtime, s...

#Hardware #LLM On-Premise #DevOps

2026-10-03 • LocalLLaMA

I runtime di inference monoscopo? La nuova normalità per l'hardware locale

Runtime ultra-specializzati come Strata e ninfer rinunciano alla generalità di llama.cpp e vLLM per ottimizzare pochi modelli e una singola famiglia hardware. La scommessa: massimo output da configurazioni locali fisse, anche a costo di codice usa e ...

#Hardware #LLM On-Premise #DevOps

2026-10-03 • LocalLLaMA

llama.cpp dimezza la memoria dell'indice per Qwen Flash Next

Una pull request nel repository llama.cpp introduce un'ottimizzazione che dimezza la memoria dell'indice di scoring per Qwen Flash Next. Il cambiamento, segnalato su Reddit, si traduce in un minore uso di VRAM durante l'inference. Per i deployment on...

#Hardware #LLM On-Premise
2026-10-02 • LocalLLaMA

llama.cpp aggiunge i Decision Models: l'inference locale cambia passo

Il progetto llama.cpp ha annunciato una nuova funzionalità denominata Decision Models, segnalando un ampliamento oltre la generazione testuale pura. Per chi gestisce Large Language Models in locale, la mossa suggerisce una maturazione verso output pi...

#Hardware #LLM On-Premise #DevOps

2026-10-01 • LocalLLaMA

llama.cpp ora supporta MTP con Qwen Flash Next: merge in 17 ore

La pull request #29761 di am17an introduce in llama.cpp il supporto MTP per Qwen Flash Next, con quantization GGUF già disponibili su Hugging Face. Un segnale per chi valuta stack locali: l'ecosistema self-hosted accorcia i tempi tra rilascio del mod...

#Hardware #LLM On-Premise #DevOps

2026-10-01 • LocalLLaMA

Riparte il lavoro su MTP per Qwen Flash Next in llama.cpp

Una pull request riapre l'integrazione MTP per Qwen Flash Next in llama.cpp, con quantizzazioni GGUF disponibili su Hugging Face. Il lavoro è ancora WIP; per chi esegue LLM in locale diventa un banco di prova per ridurre la latenza senza cambiare har...

#Hardware #LLM On-Premise #DevOps

2026-09-30 • LocalLLaMA

GLM-5.3-Flash sbarca su llama.cpp: l'inference locale avanza

La pull request #27773 di timkhronos integra GLM-5.3-Flash (GLM5-Next) in llama.cpp. Il modello diventa eseguibile su computer domestici, senza cloud. Un segnale per chi valuta deployment on-premise: i runtime open source si consolidano come canale d...

#Hardware #LLM On-Premise #DevOps

2026-09-29 • LocalLLaMA

Qwen3.8-Flash-Next: quantization e pruning portano un 176,9B su 32 GB

ISTA DASLab ha distribuito GGUFs quantizzati per Qwen3.8-Flash-Next e una variante Coder con metà degli expert rimossi. La combinazione GSQ e RCO porta il working set residente a 29,6 GB, dentro un acceleratore da 32 GB, con benchmark vicini o superi...

#LLM On-Premise #Fine-Tuning #DevOps
← Torna ai Topic

