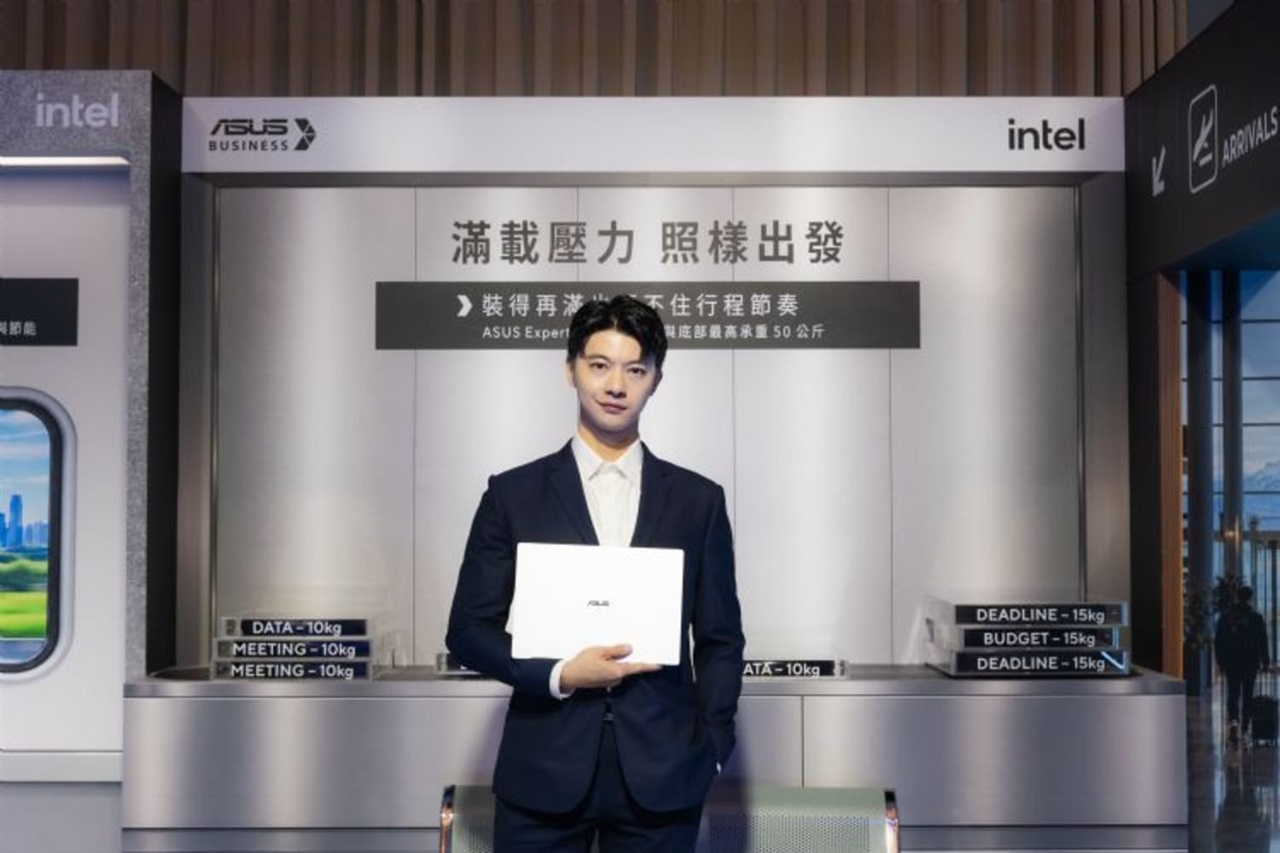
La tensione sul mercato delle GPU per l'intelligenza artificiale non riguarda più soltanto i grandi data center cloud. Ora il fronte caldo si sposta sulle workstation e sui sistemi locali. L'ultimo segnale arriva da DIGITIMES, secondo cui i costi dei servizi AI in cloud stanno alimentando la domanda di calcolo on-premise e questo sta mettendo sotto pressione le scorte della Asus RTX Spark.
Non serve scomodare cifre riservate: il meccanismo è noto a chiunque gestisca budget per l'inference di LLM. I modelli crescono, le chiamate API si moltiplicano e i costi variabili legati ai token diventano difficili da prevedere. In molti contesti, soprattutto dove i carichi sono continuativi o i dati non possono lasciare l'azienda, il calcolo locale torna a essere un'alternativa concreta. La Asus RTX Spark si trova al centro di questa tensione: un prodotto che incrocia le esigenze di chi vuole portare l'elaborazione vicino ai dati. Il rapido esaurimento delle scorte suggerisce che la domanda non è più solo quella degli appassionati, ma dei team IT che devono mettere in produzione modelli senza dipendere da un fornitore cloud.
Qui non siamo di fronte a un semplice problema logistico. La carenza di un componente specifico segnala uno spostamento strutturale. Le organizzazioni stanno ricalcolando il TCO dei deployment AI: un conto è pagare per token su carichi sporadici, un altro è sostenere mesi di inference intensiva. Il self-hosted permette di trasformare una spesa operativa continua in un investimento in capitale, con tutto ciò che comporta in termini di ammortamento, manutenzione e gestione delle risorse.
C'è un secondo effetto, meno visibile ma altrettanto rilevante. La pressione sulle forniture locali non colpisce tutti allo stesso modo. I fornitori di hardware con linee dedicate all'AI locale possono guadagnare quote, mentre i cloud provider si trovano a dover giustificare prezzi che per alcuni carichi appaiono sempre meno competitivi. Allo stesso tempo, le aziende che non hanno pianificato scorte o non hanno competenze interne per gestire infrastrutture self-hosted rischiano di restare in coda, esposte a tempi di consegna più lunghi e a listini in movimento. Il mercato, insomma, comincia a prezzare la sovranità dei dati non come un vezzo normativo ma come una voce di costo reale.
Per chi valuta deployment on-premise, esistono trade-off che vanno oltre il prezzo della scheda: consumi energetici, raffreddamento, competenze di gestione, aggiornamenti dei modelli. AI-RADAR dedica a questi temi framework analitici su /llm-onpremise, utili a mappare i vincoli senza ridurre la decisione a un confronto di listino. La vicenda Asus RTX Spark, in fondo, mostra che l'hardware locale non è più una nicchia: è diventato una variabile competitiva.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!