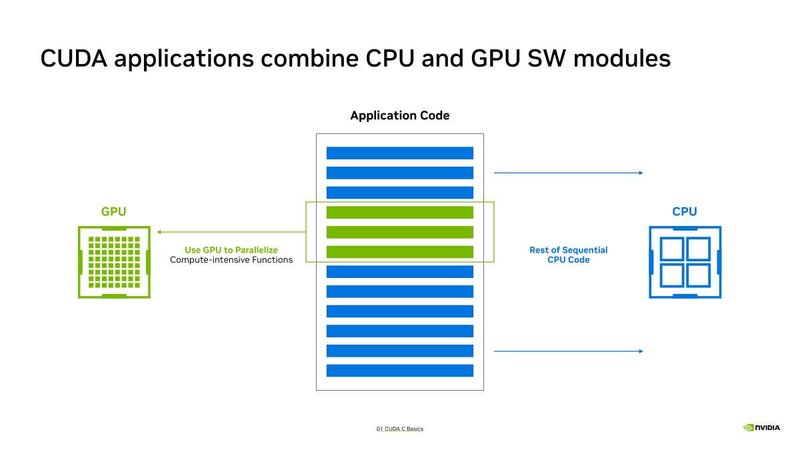
NVIDIA ha portato CUDA 13.5 allo stato di general availability, contestualmente al driver Linux 620.70.06. Il fatto che il supporto a Vera Rubin entri nella branch stabile non è una nota a margine: per chi progetta infrastrutture GPU self-hosted, il rilascio anticipa una fase che in passato si scontrava con l'attesa di toolchain maturi. La piattaforma CUDA arriva prima dell'hardware, non dopo. E questo cambia la tempistica con cui i team possono affrontare la validazione di LLM, inference e pipeline di training.
Una piattaforma che arriva prima dell'hardware
Il punto non è la singola versione, ma il modo in cui NVIDIA coordina software e hardware. Fino a pochi anni fa, il supporto production per una nuova architettura arrivava spesso a ridosso o dopo la disponibilità dei primi server. Con CUDA 13.5, il lavoro di integrazione — container, runtime di serving, librerie di comunicazione, pipeline di compilazione — può essere avviato prima che i data center ricevano i nodi Vera Rubin. Questo riduce il lead time operativo e sposta una parte del rischio di progetto dalla fase di messa in produzione a quella di preparazione.
I vincitori immediati sono gli integratori di sistemi e i team enterprise che devono mantenere attive le proprie farm GPU senza passare dal cloud. Poter compilare, profilare e testare parti della pipeline su CUDA 13.5 significa avere meno variabili ignote quando i server Vera Rubin entreranno in sala macchine. Chi invece scommette su stack alternativi trova una barriera ancora più alta: il supporto anticipato in CUDA rende l'ecosistema NVIDIA la via più breve per usare le nuove GPU, anche quando il differenziale di prezzo o di consumo energetico potrebbe suggerire valutazioni più aperte.
Il TCO di un'infrastruttura self-hosted non dipende solo dal costo di acquisto dei nodi. Dipende anche dal tempo tecnico necessario per rendere i sistemi produttivi. Il fatto che CUDA 13.5 sia già in GA sposta il costo di integrazione più a monte e, in molti casi, lo riduce: i test di compatibilità, i profili di memoria e le ottimizzazioni per l'inference possono essere affrontati su build intermedie, senza che il team debba restare fermo in attesa dell'hardware definitivo.
C'è anche un effetto di secondo ordine meno visibile: la disponibilità anticipata del toolchain spinge i vendor di server e i provider cloud a preparare le immagini di sistema con largo anticipo, perché sanno che i clienti chiederanno subito ambienti compatibili. Questo accorcia il tempo che intercorre tra la presentazione di una nuova architettura e la sua adozione nei carichi reali. Non è un dettaglio tecnico: è una leva competitiva che riguarda la velocità di ricambio delle infrastrutture AI.
Per le organizzazioni che non vogliono spostare dati e modelli su cloud esterni, il supporto production anticipato è una condizione importante: riduce l'incertezza operativa legata all'adozione di hardware nuovo in ambienti con vincoli di residenza dei dati. Le decisioni di deployment on-premise richiedono comunque una lettura integrata di questi trade-off. AI-RADAR ne discute nel dettaglio su /llm-onpremise, dove i framework analitici su costi e vincoli di sovranità dei dati non sono separati dalla scelta della piattaforma.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!