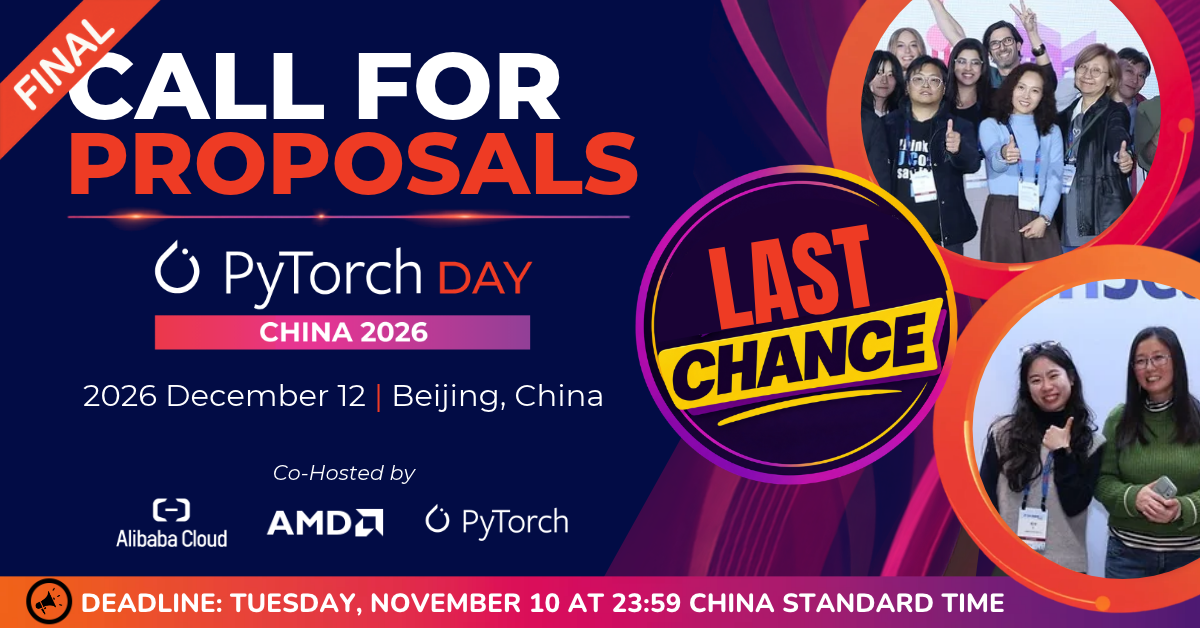
La Call for Proposals per il PyTorch Day China 2026 chiude il 10 novembre alle 23:59 ora standard cinese, ma il dato più interessante non è la scadenza. È la struttura dei cinque filoni tematici scelti dagli organizzatori per l'evento del 12 dicembre a Pechino.
Training & post-training, efficient inference & deployment, PyTorch core & hardware acceleration, physical AI, ecosystem. A prima vista sembra un elenco tecnico. In realtà, due spostamenti di baricentro sono evidenti. Il primo: l'inference e il deployment non sono più un'appendice, ma un'area con pari dignità rispetto al training. Il secondo: l'accelerazione hardware non è trattata come un tema di nicchia, ma come un elemento centrale del framework.
L'area dedicata all'efficient inference & deployment cita esplicitamente LLM inference, quantization e strategie di deployment. Non è un dettaglio: fotografa un ecosistema che deve far girare modelli su hardware eterogeneo, non solo su GPU di fascia alta nel cloud. Per chi gestisce stack self-hosted, questa è una differenza strutturale: il dibattito si sposta dalla scala del training alla sostenibilità dell'inference su acceleratori locali.
L'hardware non è più una variabile neutra
Quando il focus di una conferenza si sposta su compilazione, ottimizzazione dei kernel e profiling, il messaggio implicito è che il software deve adattarsi a un parco hardware più ampio. In Cina questo tema ha un significato particolare, perché l'accesso a determinati acceleratori non è scontato e la spinta verso soluzioni domestiche è parte del contesto industriale. Per chi lavora su deployment on-premise, la conseguenza è diretta: un framework che investe su kernel e compilazione rende più plausibile l'uso di hardware non standard senza dover riscrivere l'intera pipeline.
Anche la presenza della physical AI va letta nello stesso modo. Robotica, dispositivi intelligenti e modelli Vision-Language-Action allargano il perimetro oltre il server: parliamo di inference su edge, con vincoli di latenza, memoria e consumo energetico. Il PyTorch Day China 2026 segnala così che il framework vuole essere rilevante per carichi di lavoro che non vivono in un data center.
Chi guadagna da questa impostazione? I team di ingegneri che devono portare modelli in produzione senza dipendere da un unico vendor cloud; i produttori di acceleratori che cercano un ecosistema software maturo; i laboratori di robotica che hanno bisogno di strumenti di addestramento e deployment integrati. Chi rischia di restare indietro? Gli approcci che trattano l'hardware come una commodity astratta e il deployment come un problema risolto.
Per chi valuta deployment on-premise, i trade-off tra controllo dell'hardware, complessità di gestione e costi operativi non si risolvono con una sola conferenza. AI-RADAR mette a disposizione framework analitici su /llm-onpremise per orientarsi tra questi vincoli.
La scadenza del 10 novembre è solo l'ultimo giorno utile. La posta in gioco, però, è già visibile: il prossimo PyTorch Day cinese non parlerà solo di modelli, ma di come farli funzionare dove servono davvero.


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!