Google ha portato il ciclo di sviluppo delle sue TPU a sei mesi e ha delineato un piano di espansione della capacità di calcolo dedicata all'intelligenza artificiale. È un dettaglio che, a prima vista, sembra tecnico: in realtà racconta molto di come i grandi fornitori di cloud stanno trasformando l'hardware per l'AI in una risorsa interna, aggiornata con cadenza quasi da prodotto software.
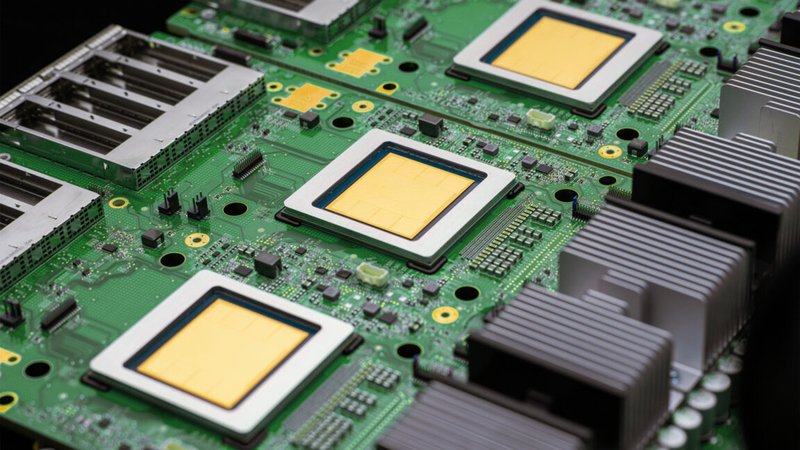
Le TPU sono processori tensorici progettati da Google per accelerare le operazioni di matrice che dominano training e inference dei modelli. A differenza delle GPU, non vengono vendute come componenti standalone: si utilizzano attraverso Google Cloud, dentro data center controllati dal fornitore. Questo modello verticale consente a Google di spingere il ritmo di iterazione senza dover convincere un mercato di acquirenti enterprise a sostituire l'hardware ogni pochi mesi. Un ciclo di sei mesi è aggressivo: storicamente gli acceleratori per data center seguivano tempistiche più lunghe, legate a cicli di validazione, produzione e supporto. Accorciare quel ciclo segnala che Google sta trattando le TPU come un prodotto interno ad alta frequenza di revisione, con la possibilità di introdurre miglioramenti architetturali e di processo molto più rapidamente.
Per chi segue le decisioni di deployment, questa notizia ha implicazioni di secondo ordine. Se il ritmo semestrale diventa strutturale, la distanza prestazionale tra silicio specializzato accessibile solo in cloud e hardware general-purpose acquistabile per infrastrutture on-premise potrebbe aumentare. Le aziende che scelgono di mantenere i carichi di lavoro AI nei propri data center, per ragioni di sovranità dei dati o controllo operativo, si troverebbero a competere con una curva di innovazione dettata da un fornitore che può ammortizzare la ricerca su volumi enormi di workload interni. Non è una questione di velocità assoluta: è una questione di incentivi. Google può permettersi di iterare perché non deve garantire compatibilità a lungo termine a un ecosistema di terze parti, né deve preoccuparsi che ogni nuova generazione venga adottata da un mercato. Il suo cliente è la propria infrastruttura cloud.
Questo non rende le TPU automaticamente superiori in ogni scenario. Molte organizzazioni continuano a preferire GPU per la flessibilità, la disponibilità di framework consolidati e la possibilità di spostare i carichi tra ambienti diversi. Ma un ciclo di sei mesi mette pressione su tutto l'ecosistema: i produttori di GPU, i fornitori di server e le piattaforme cloud concorrenti devono rispondere con roadmap più rapide o rischiano di perdere rilevanza nei segmenti ad alta intensità di calcolo. Allo stesso tempo, la logica del silicio custom cloud-only rafforza una tendenza più ampia: la separazione tra chi sviluppa modelli e infrastruttura e chi li consuma attraverso API. Per chi valuta i trade-off tra cloud e on-premise, AI-RADAR offre framework analitici su /llm-onpremise per mappare questi vincoli senza scorciatoie. Chi vuole self-hosted deve accettare un compromesso: maggiore controllo, ma una curva di aggiornamento che potrebbe restare indietro rispetto a quella dei grandi fornitori di cloud.
In sintesi, il ciclo semestrale delle TPU è un indicatore strutturale: l'hardware per l'AI sta diventando un vantaggio competitivo interno dei grandi cloud, non un mercato aperto. Le implicazioni per la sovranità e per le strategie locali sono profonde, anche se oggi la fonte non fornisce dettagli sulle specifiche tecniche o sui volumi di espansione.







💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!