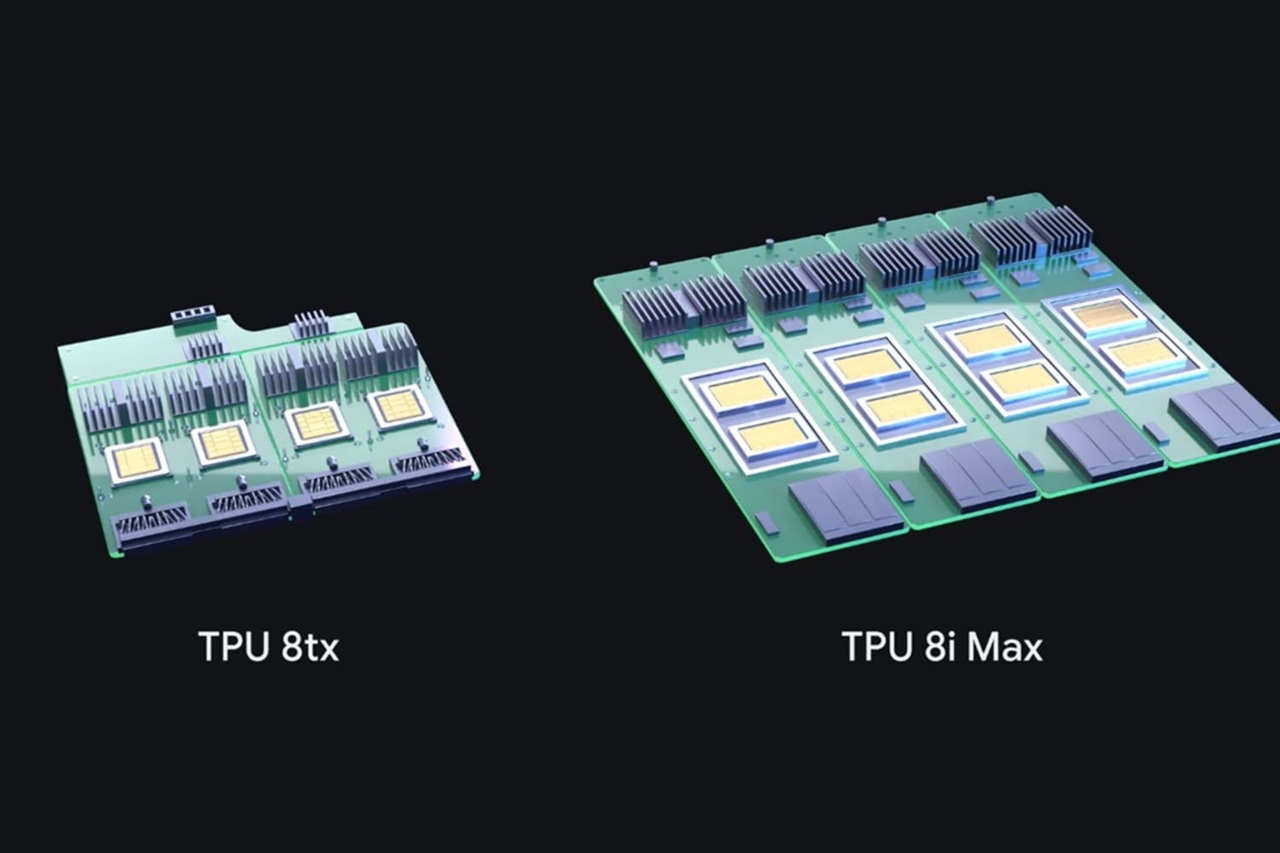
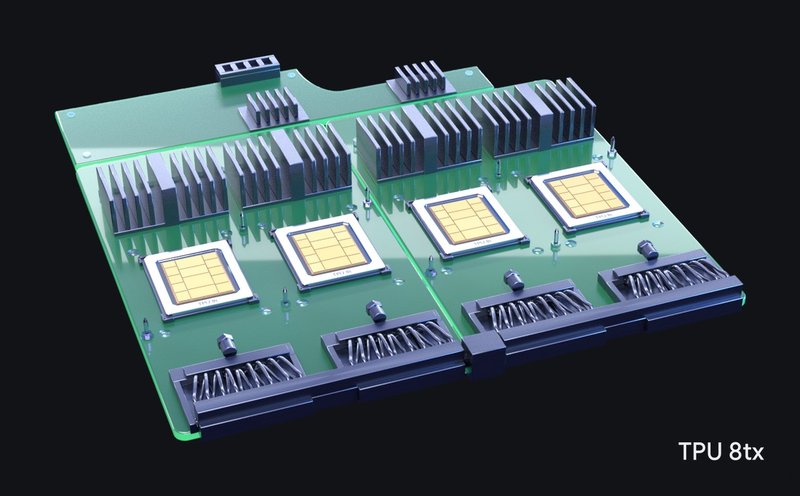
L'ultima espansione della famiglia di TPU di ottava generazione da parte di Google non è un semplice aggiornamento di catalogo. Punta dritto a due caratteristiche che stanno ridefinendo i carichi di lavoro con gli LLM: la capacità di mantenere un contesto ampio e la necessità di isolamento e sicurezza quando gli agenti compiono azioni su sistemi aziendali.
La fonte non entra nei dettagli tecnici, ma il posizionamento scelto da Google è già un segnale. Le TPU sono acceleratori sviluppati internamente dall'azienda per eseguire operazioni tensoriali su larga scala e vengono offerte attraverso Google Cloud, non come componenti acquistabili per un data center privato. Questo vincolo di accesso è importante quando si guarda alla parola "secure" accanto a "high-context agentic AI".
Un agente che interagisce con API, database e processi interni non può limitarsi a generare una risposta su un singolo prompt. Deve conservare una catena di stato, permessi e risultati intermedi per periodi più lunghi. In questo scenario il collo di bottiglia non è soltanto la velocità di emissione dei token: contano anche la gestione della memoria, la larghezza di banda verso la memoria e l'isolamento tra tenant. L'espansione del portfolio suggerisce che Google stia organizzando la propria offerta hardware attorno a questi vincoli, non solo attorno ai benchmark di throughput.
Per chi valuta ambienti self-hosted, la notizia segnala un divario strutturale. Le TPU restano cloud-native e non offrono un percorso diretto per chi deve mantenere i dati all'interno del proprio perimetro. I concorrenti on-premise, tipicamente basati su GPU con VRAM elevata e acceleratori di produttori terzi, devono rispondere non solo sul piano delle prestazioni ma anche su quello della riservatezza e della continuità di contesto. AI-RADAR propone strumenti di analisi su /llm-onpremise per mappare questi trade-off, ma la distanza tra i due modelli di deployment non si riduce con una semplice equivalenza di specifiche.
L'aspetto più rilevante è che il termine "agentic AI" sta spostando la discussione tecnica dalla potenza pura alla qualità del servizio in condizioni operative reali. Un sistema che gestisce contesti lunghi e azioni sicure cambia i criteri di valutazione: meno attenzione al singolo token generato, più attenzione alla stabilità dello stato, alla latenza nel recupero della memoria e alla separazione tra workload diversi. Questo è un cambiamento di incentivi che i team infrastruttura dovranno interiorizzare, indipendentemente dal fornitore scelto.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!