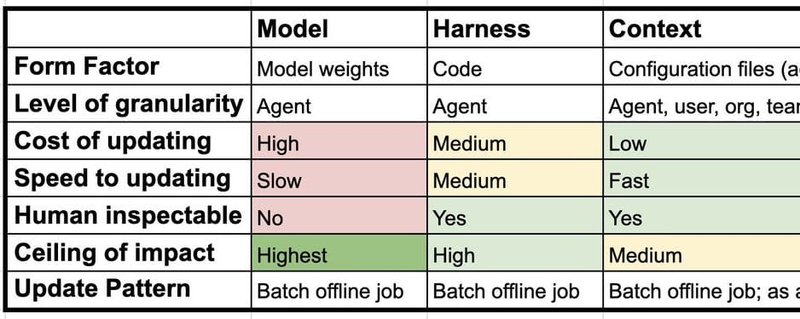
Google ha reso open source Harness2, un meccanismo che consente a un agente AI di modificare il proprio harness — l'insieme di prompt di sistema, strumenti, memoria, competenze e subagenti che circonda il modello — e di conservare i miglioramenti tra un task e l'altro. Non è un nuovo LLM e non introduce nuovi pesi: è un livello sopra il modello che rende l'adattamento parte del ciclo di esecuzione, non una fase preliminare.
La differenza rispetto alla configurazione tradizionale è sostanziale. Di norma un essere umano progetta l'harness una volta e l'agente usa quella struttura fissa per ogni richiesta. Con Harness2 l'agente propone modifiche, esegue alcune versioni candidate e confronta le prestazioni. Non servono risposte corrette o valutatori esterni: il confronto avviene sulle performance osservate. Il modello resta identico. Ciò che l'agente apprende su un task viene salvato e riutilizzato, così le modifiche successive partono da una base più intelligente.
Questo sposta l'asse dell'ottimizzazione. Invece di investire in fine-tuning o in nuovi checkpoint, si può intervenire sull'orchestrazione mantenendo i pesi congelati. Per chi gestisce modelli in modalità self-hosted, il vantaggio è chiaro: la base del modello resta un artefatto controllato e verificabile, mentre l'evoluzione avviene in uno strato separato, più facile da ispezionare e revisionare. Non è un dettaglio da poco nei contesti in cui la tracciabilità e la sovranità dei dati contano più della ricerca dell'ultimo punto percentuale di accuratezza.
Va però letto anche il costo computazionale. Ogni giro di miglioramento richiede l'esecuzione di versioni candidate aggiuntive: non si tratta di addestramento, ma di inference ripetuta. Un harness che si auto-migliora consuma token e risorse in più rispetto a un harness statico. La domanda per chi dimensiona un'infrastruttura locale diventa quindi se il guadagno di adattamento giustifica una capacità di calcolo flessibile, capace di assorbire picchi di valutazione. La fonte non riporta metriche di throughput o requisiti di VRAM, ma il segnale strutturale è chiaro: l'ottimizzazione si sta spostando dal training all'orchestrazione, e questo cambia i profili di carico delle macchine dedicate agli LLM.
I test citati da Google con Gemini 3.5 Flash e GLM-5 su benchmark legali, d'ufficio e professionali mostrano che anche un solo giro di modifiche batte gli harness originali e che più giri spingono i punteggi più in alto. È un risultato che interessa soprattutto chi vuole portare agenti specializzati su dati sensibili: invece di ricorrere a un fornitore esterno per adattare il modello, si può distribuire un harness che si affina in locale. L'apertura del codice su GitHub rafforza questa direzione, perché rende l'intero meccanismo ispezionabile e integrabile in pipeline esistenti.
Per chi valuta deployment on-premise, esistono trade-off precisi: il controllo e la trasparenza dell'harness vanno pesati contro il maggiore consumo di risorse per le valutazioni concorrenti. Harness2 non risolve questo dilemma, ma lo rende esplicito e, per la prima volta, affrontabile senza toccare i pesi del modello.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!