Il segnale non è il silicio, è il confine del controllo
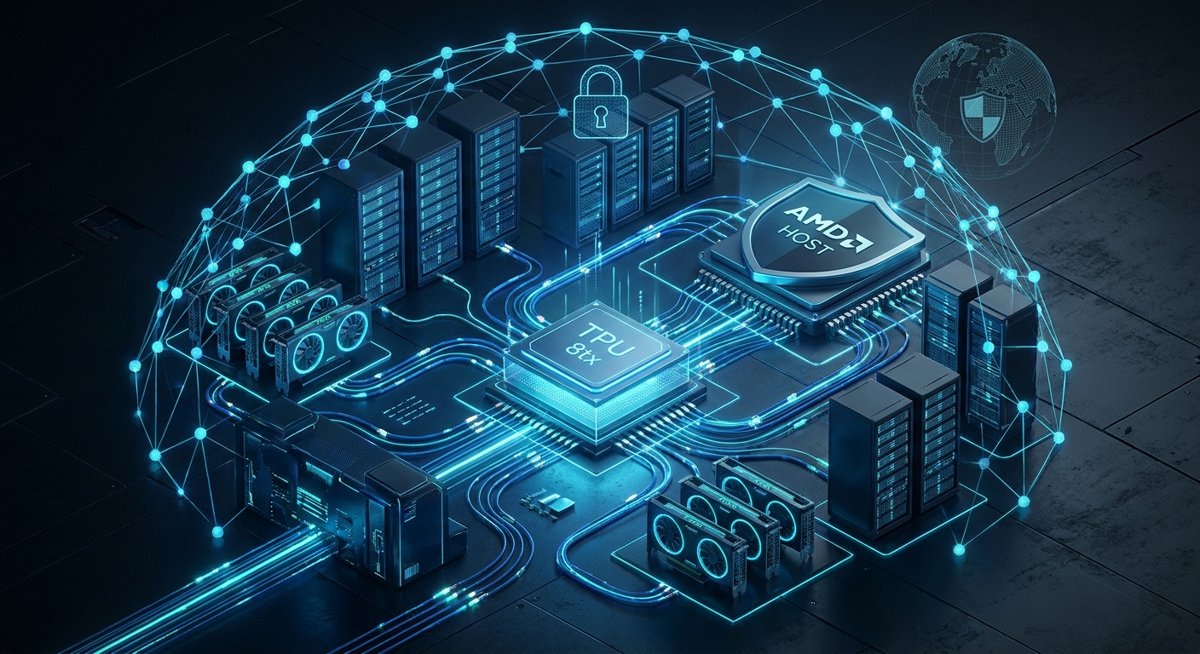
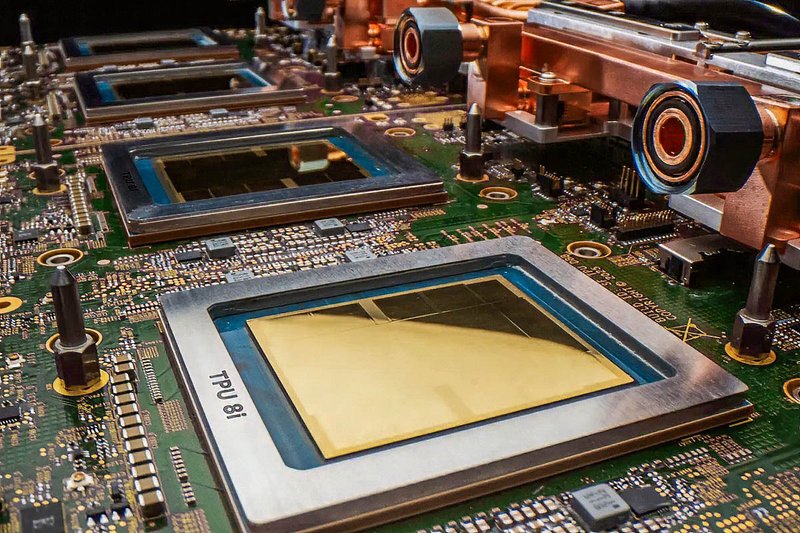
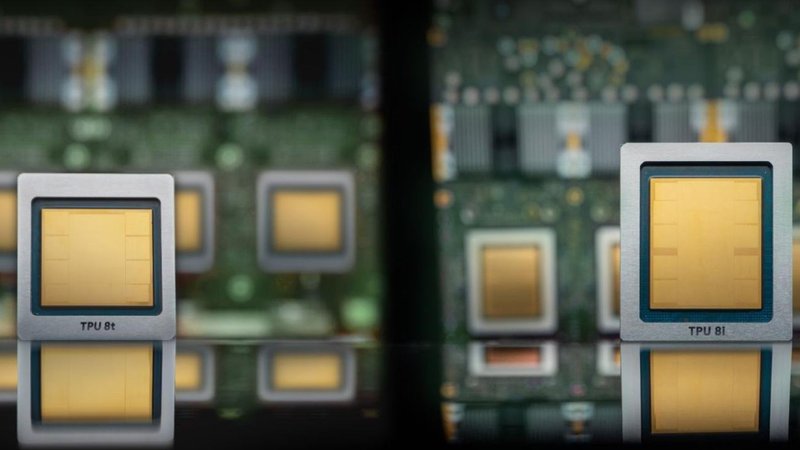
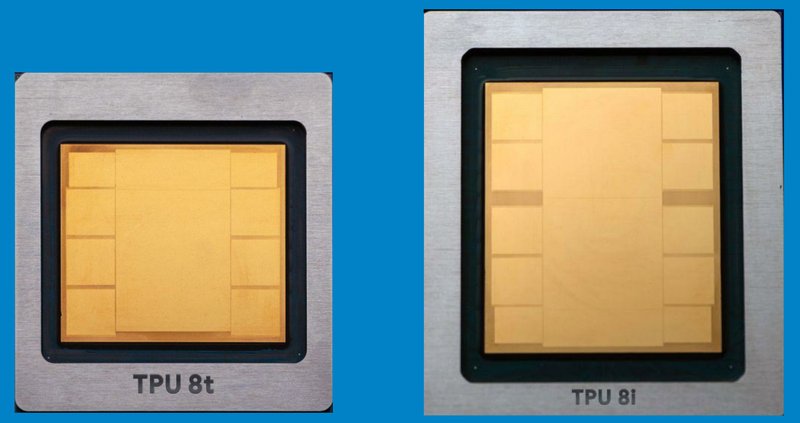
La notizia ha un contenuto tecnico scarno ma un peso strategico notevole. Google ha scelto host basati su AMD EPYC Turin per i nuovi TPU 8tx e ha integrato capacità di confidential computing; in parallelo, la variante TPU 8i Max raddoppia la banda di memoria pensata per l'inference. Non è un semplice refresh hardware. È un modo per ridefinire i confini tra ciò che l'infrastruttura cloud può offrire e ciò che un'organizzazione può portare dentro i propri data center.
Il primo segnale chiaro è che la specializzazione del silicio non elimina il ruolo dei processori general-purpose. Un acceleratore custom come la TPU ha bisogno di un host capace di gestire orchestrazione, I/O, sicurezza e parte della pipeline di dati. La scelta di AMD, e non di un processore proprietario o di un partner scontato, indica che Google tratta la CPU host come un componente strategico, non come un dettaglio da fornitori terzi.
Per chi osserva il mercato dell'AI infrastructure, il messaggio è più ampio. L'innovazione non si gioca solo sugli acceleratori, ma sull'integrazione tra calcolo specializzato, memoria, rete e meccanismi di protezione. La TPU 8tx e la 8i Max non sono semplici chip: sono elementi di una piattaforma cloud che Google controlla dall'host alla sicurezza. Questa integrazione è esattamente il punto che rende le TPU difficili da replicare in contesti on-premise.
AI-Radar segue questa notizia con un filtro preciso. Una novità hardware annunciata per un servizio cloud non si traduce in un'opzione per chi gestisce LLM locali. Ma il modo in cui Google muove i propri pezzi aiuta a capire dove si sta spostando il confronto tra cloud ad alte prestazioni e controllo locale.
Inference e banda di memoria: la variabile nascosta del TCO
Per chi lavora con modelli di linguaggio di grandi dimensioni, il raddoppio della banda di memoria sulla TPU 8i Max è il dettaglio che pesa di più. L'inference su LLM è spesso limitata dalla capacità di muovere pesi e stato del modello tra memoria e unità di calcolo, non dalla potenza massima dell'acceleratore. Aumentare la bandwidth senza cambiare architettura di calcolo è un intervento diretto su quel collo di bottiglia.
Questo ha conseguenze immediate sulla sostenibilità dei servizi che generano token in tempo reale. Quando un modello deve produrre token in sequenza, ogni passo richiede di rileggere parti significative del modello. Una banda maggiore consente di mantenere una latenza contenuta senza spingere il sistema verso configurazioni più costose o verso ottimizzazioni aggressive come la quantization. In un contesto cloud, questo si riflette sul TCO: i costi operativi legati all'inference stanno diventando la voce dominante per molti servizi basati su LLM.
Il ragionamento vale anche per chi valuta hardware locale. Nei sistemi self-hosted, la VRAM e la sua banda sono tra i fattori che determinano la qualità e il costo dell'inference. Non serve un acceleratore con il massimo numero di core se la memoria non riesce ad alimentarlo. La mossa di Google sulla 8i Max conferma che il mercato sta spostando l'attenzione dal picco di calcolo alla sostenibilità dell'inference prolungata.
C'è però una differenza fondamentale. Google può ottimizzare la banda di memoria all'interno di un ecosistema proprietario, con TPU, host e software allineati. Chi costruisce un deployment on-premise deve fare i conti con componenti eterogenei, driver e stack software. Il raddoppio annunciato da Google non è una scheda che si può installare in un rack locale, ma un segnale di dove si concentreranno i miglioramenti dei prossimi acceleratori.
Confidential computing: la sicurezza in uso non è sovranità
L'introduzione del confidential computing sui TPU 8tx sposta il confronto dal piano delle prestazioni a quello della sicurezza dei dati in uso. È un passo rilevante: protegge i dati durante l'elaborazione, riducendo l'esposizione a chi gestisce l'infrastruttura cloud. Per carichi LLM gestiti in ambienti condivisi, questo ha un peso crescente, soprattutto quando i prompt e i dati contestuali contengono informazioni sensibili.
Ma il confidential computing non equivale a sovranità dei dati. Proteggere i dati mentre vengono elaborati non cambia il fatto che quei dati risiedono in un data center gestito da terzi e che l'accesso all'infrastruttura resta fuori dal controllo dell'organizzazione. Per chi è soggetto a normative europee, la distinzione tra protezione in uso e controllo fisico è spesso più rilevante della pura potenza di calcolo.
Questa tensione è centrale per AI-Radar. Il confidential computing alza l'asticella dell'offerta cloud e può rendere accettabili scenari che prima erano esclusi. Ma non elimina il vincolo strutturale: se un dato non può uscire da un perimetro fisico definito, nessun livello di sicurezza software o hardware nel cloud risolve il problema. La risposta per questi casi resta il deployment self-hosted o una combinazione di perimetri certificati.
Vale anche un'altra considerazione. Il confidential computing richiede fiducia nel fornitore della piattaforma e nelle attestazioni di sicurezza. Le organizzazioni devono verificare come vengono gestite le chiavi, come viene attestata l'integrità dell'ambiente e quali garanzie contrattuali accompagnano la protezione. Non è una funzione che si attiva con un interruttore, ma un processo di verifica che impatta il modo in cui si valutano i fornitori cloud.
AMD entra dalla porta di servizio, Intel guarda dal retro
La scelta di AMD come host per le TPU 8tx ha un effetto di secondo ordine sul mercato dei processori server. AMD entra in un'infrastruttura AI di primissimo piano non con una GPU, ma con la CPU host. Questo dettaglio è importante: dimostra che il valore di un fornitore nel data center moderno non si misura solo sugli acceleratori, ma sulla capacità di offrire CPU affidabili, efficienti e integrabili con silicio custom.
Per Intel, che sta cercando di recuperare terreno nelle CPU server, il messaggio è chiaro. I clienti hyperscaler non considerano più scontata la scelta del processore host, nemmeno quando l'acceleratore è proprietario. Un hyperscaler come Google può decidere di diversificare i fornitori, valutare l'efficienza per socket e premiare chi offre una combinazione di prestazioni, gestione termica e supporto software. La scelta di AMD segnala che la competizione sulle CPU host resta aperta.
Non va sopravvalutato l'impatto immediato per chi usa LLM. La CPU host non è il collo di bottiglia principale per l'inference su modelli di grandi dimensioni. Ma in una piattaforma cloud, la CPU host gestisce parti critiche della pipeline, dalla preparazione dei dati alla sicurezza, e un host inefficiente può erodere i benefici dell'acceleratore. La scelta di AMD può quindi contribuire alla sostenibilità complessiva dell'offerta Google.
Guardando avanti, questo segnale potrebbe spingere entrambi i produttori di CPU a specializzare le proprie soluzioni per i carichi AI. Non basta più essere un buon processore general-purpose: serve una progettazione attenta alle interazioni con gli acceleratori, alla memoria e alle funzioni di sicurezza. La partita dell'AI infrastructure si allarga, e AMD ha dimostrato di poter essere parte del disegno anche senza avere la GPU dominante.
Il self-hosted non si spegne: la scelta è infrastruttura, non prestazione
Le TPU restano una tecnicia che Google offre principalmente attraverso la propria infrastruttura cloud, non come componente acquistabile per un data center on-premise. Questo vincolo è strutturale. L'integrazione tra TPU, host EPYC e confidential computing è progettata per migliorare l'offerta di servizi gestiti, non per aprire una filiera di hardware indipendente. Per le organizzazioni che non possono spostare dati sensibili su cloud, la notizia non fornisce una risposta diretta.
Questo non significa che la notizia sia irrilevante per il mondo self-hosted. Al contrario, indica la direzione che prenderà il confronto quando le organizzazioni dovranno giustificare la scelta tra cloud ad alte prestazioni e controllo locale. Se il cloud continua a migliorare bandwidth, sicurezza e integrazione, il calcolo del TCO per l'on-premise deve includere non solo i costi hardware, ma anche i costi di gestione, gli aggiornamenti e la complessità operativa.
Per chi valuta deployment on-premise, i framework analitici su /llm-onpremise aiutano a soppesare trade-off di questo tipo, senza ricette preconfezionate. Non esiste una risposta unica: dipende dalla sensibilità dei dati, dai vincoli normativi, dalla scala di inference e dalla capacità del team di gestire infrastruttura locale. La notizia Google offre un punto di riferimento per capire cosa il cloud può offrire, ma non sostituisce l'analisi del contesto.
AI-Radar mantiene una posizione di neutralità vendor. Non si tratta di stabilire se le TPU siano migliori o peggiori di altre soluzioni, ma di capire quali opzioni sono disponibili, quali vincoli esistono e come cambiano i termini del confronto. Il self-hosted resta una scelta legittima quando il controllo fisico e la sovranità dei dati non sono negoziabili, anche se il cloud alza continuamente l'asticella delle prestazioni e della sicurezza.
Cosa guardare nei prossimi mesi
Il primo segnale da monitorare è la disponibilità delle TPU al di fuori del cloud Google. Se Google dovesse rendere le TPU accessibili tramite partner o in modalità ibrida, il framework per il self-hosted cambierebbe. Per ora non ci sono indicazioni in questo senso, ma la pressione competitiva potrebbe spingere verso forme di distribuzione più aperte.
Il secondo fronte è la maturazione del confidential computing. Serviranno certificazioni, attestazioni e garanzie contrattuali chiare per capire se questa tecnicia può davvero soddisfare i requisiti delle organizzazioni regolate. Senza un framework di verifica indipendente, il confidential computing rischia di restare una promessa di marketing.
Sul fronte hardware, vale la pena osservare come risponderanno AMD e Intel. La scelta di Google potrebbe accelerare lo sviluppo di CPU host specializzate per carichi AI, con effetti su tutta la filiera dei server. Anche i produttori di acceleratori per il mercato on-premise dovranno tenere il passo sulla bandwidth di memoria, perché l'inference su LLM premia chi muove i dati in modo efficiente.
Infine, il vero indicatore sarà il TCO reale dei servizi di inference. Le novità hardware contano se si traducono in costi operativi più bassi o in una qualità di servizio più prevedibile. Per chi gestisce LLM in produzione, il parametro da osservare non è il numero di core o la banda di picco, ma il costo per token generato in modo affidabile, nel rispetto dei vincoli di sicurezza e sovranità. La notizia Google è un tassello di questo framework, non la conclusione.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!