
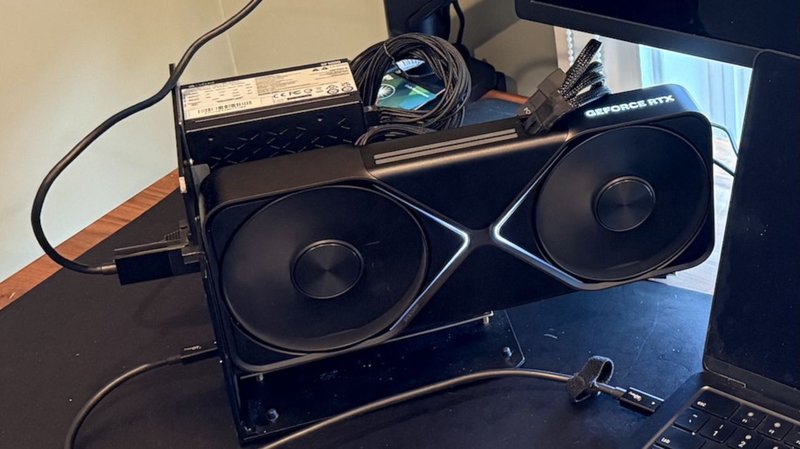
La voce è emersa nei forum specializzati: NVIDIA potrebbe aver deciso di interrompere la GeForce RTX 5090 e di destinare i chip GB202 alla serie RTX PRO. La notizia, ancora non confermata da fonti ufficiali, arriva in un momento in cui la domanda di GPU ad alta VRAM è trainata tanto dal gaming quanto dalle attività di inference locale per Large Language Models.
Se il report fosse corretto, la mossa avrebbe una logica industriale piuttosto chiara. I prodotti professionali vengono venduti a margini più elevati e spesso legati a contratti di fornitura a lungo termine. Destinare i die GB202 alle RTX PRO significherebbe privilegiare un segmento in cui NVIDIA può estrarre più valore da ogni wafer, riducendo al contempo la pressione sul canale consumer, dove i prezzi delle schede di punta sono ormai influenzati anche dalla domanda di calcolo per l'AI.
Per chi costruisce macchine self-hosted per l'inference di LLM, la potenziale assenza della RTX 5090 cambierebbe i trade-off. Negli ultimi anni, le GPU consumer di fascia alta hanno rappresentato un compromesso interessante tra costo, VRAM e facilità di approvvigionamento. Senza una scheda di riferimento con molta memoria video a prezzo consumer, molti team e singoli sviluppatori si troverebbero a scegliere tra schede professionali costose, hardware usato della generazione precedente oppure servizi cloud. Non è una questione puramente tecnica: è una questione di TCO e di controllo dell'infrastruttura, perché la disponibilità di hardware adeguato condiziona la fattibilità di progetti on-premise e la sovranità dei dati.
La notizia, se confermata, avrebbe anche effetti di secondo ordine. Il mercato dell'usato potrebbe vedere un'impennata di interesse per le GPU consumer precedenti, con prezzi che potrebbero restare elevati più a lungo. Allo stesso tempo, i produttori di workstation e i system integrator potrebbero accelerare il passaggio a configurazioni basate su RTX PRO, spostando ulteriormente l'asse del mercato verso il segmento professionale.
Resta da capire se la fonte sia attendibile e se NVIDIA rilascerà una smentita o una conferma. Nel frattempo, chi sta pianificando un deployment on-premise deve considerare che la disponibilità di GPU consumer di fascia alta non è più un dato scontato. Su AI-RADAR, nella sezione dedicata ai framework per llm-onpremise, si trovano strumenti analitici per valutare questi trade-off senza affidarsi a una singola scheda o a un singolo vendor.







💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!