Il segnale: il nodo on-premise entra nel formato del personal computer
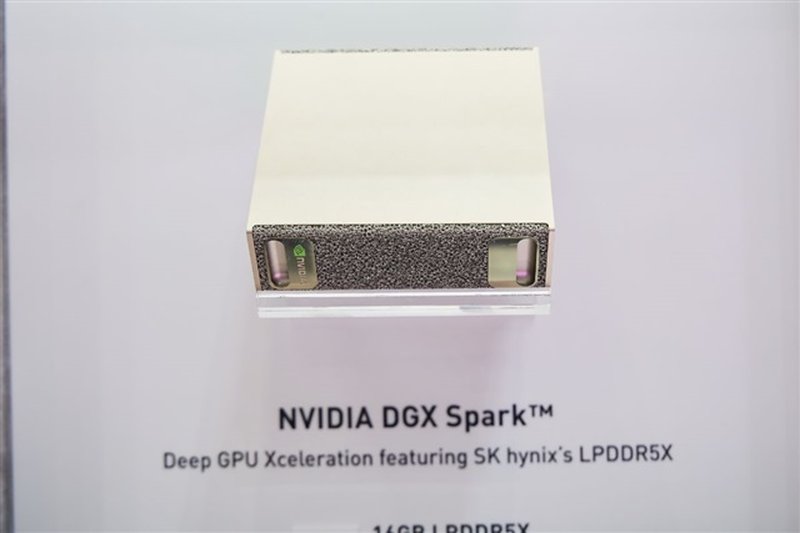
Nvidia non ha annunciato una semplice linea di schede video consumer. Ha cominciato a descrivere il personal AI computer come un punto di esecuzione autonomo per LLM, non come un terminale che delega tutto al cloud. Il passaggio è sottile ma strutturale: l'inference smette di essere un servizio remoto e diventa una capacità del dispositivo. Per AI-RADAR questo cambia il vocabolario dell'infrastruttura: non stiamo parlando di un gadget per appassionati, ma di un nodo on-premise in miniatura che può conservare dati, ridurre latenza e dare all'utente il controllo diretto del modello.
Il fatto che la notizia arrivi da DIGITIMES, con il suo osservatorio sulle filiere hardware, è indicativo. Non è una dichiarazione di marketing isolata: è un segnale che la catena produttiva inizia a prepararsi per un'ondata di macchine locali capaci di eseguire modelli in modo utile. Gli OEM di PC, i produttori di memoria e i fornitori di sistemi operativi hanno bisogno di credere che il personal AI computer non sia un esperimento. Nvidia, con il suo peso, fornisce esattamente questa legittimazione.
Il punto di svolta è che un personal AI computer è, a tutti gli effetti, un'infrastruttura on-premise in scala ridotta. Processa i dati in locale, evita il passaggio di rete verso un data center e può operare anche quando la connettività è intermittente. Questo non elimina il cloud, ma ridefinisce il confine: alcune operazioni leggere e sensibili possono vivere sulla scrivania, mentre il cloud resta per carichi massivi, addestramento o modelli troppo grandi per l'hardware locale.
In questa lettura, il dispositivo personale non è un concorrente dei rack, ma un'estensione del perimetro. La domanda non è se il cloud sopravviverà, ma quali porzioni della pipeline di inference si sposteranno verso il basso. E questa è una domanda che riguarda direttamente chi progetta deployment LLM in azienda.
Inference locale e VRAM: il vincolo che ridisegna le pipeline
Il confine tecnico principale resta la VRAM. Le GPU consumer e i sistemi personali hanno meno memoria video rispetto agli acceleratori da data center. Questa differenza non è un dettaglio: condiziona la dimensione dei modelli eseguibili, la lunghezza del contesto e la possibilità di servire più richieste in parallelo. Chi vuole eseguire un LLM on-premise su hardware locale deve fare i conti con un vincolo di memoria che i data center sentono meno.
La quantization diventa quindi una leva inevitabile. Riduce la precisione numerica dei pesi per far entrare modelli più piccoli in spazi più stretti e, in molti casi, accelera l'inference. Ma non è gratuita: può degradare la qualità delle risposte, soprattutto nei compiti che richiedono ragionamento complesso o conoscenze fini. Un team che progetta una pipeline on-premise non sta semplicemente comprimendo un modello cloud: sta scegliendo un equilibrio diverso tra latenza, qualità e footprint di memoria.
Questo sposta l'attenzione dal modello più grande disponibile a modelli ridotti e verticalizzati. Il fine-tuning mirato diventa più importante dell'addestramento massivo: si parte da un LLM compatto e lo si specializza su documenti, ticket o processi interni. In molti scenari, un modello più piccolo ma addestrato su dati aziendali produce risultati più utili di un modello gigante interrogato in modo generico. È un cambio di prospettiva che AI-RADAR osserva da tempo: l'efficienza in fase di esecuzione comincia a contare quanto la scala di addestramento.
Le architetture ibride sono la conseguenza naturale. Alcuni carichi possono restare in locale; altri, che richiedono più memoria o modelli più grandi, possono essere instradati verso un'istanza cloud o un server interno più capace. Questa suddivisione non è un fallimento dell'on-premise, ma una progettazione consapevole delle pipeline: il dispositivo locale diventa un filtro, un primo livello di elaborazione, un custode dei dati sensibili.
L'economia si sposta: CapEx, OpEx e TCO nelle decisioni on-premise
Il cloud ha dominato a lungo perché trasformava il CapEx in OpEx e prometteva scalabilità quasi infinita. Per molte aziende, pagare per l'uso era più semplice che acquistare e mantenere infrastruttura. Ma quando un dispositivo locale può eseguire un LLM utile per carichi stabili, l'equazione si complica. Un investimento upfront in macchine on-premise può ridurre i costi ricorrenti, soprattutto se il volume di inference è prevedibile e i dati devono rimanere interni.
Il TCO diventa il metro corretto, ma non è un numero semplice. Include hardware, consumi energetici, manutenzione, aggiornamenti e competenze interne. Un personal AI computer non elimina questi costi: li sposta. La bolletta del cloud può scendere, ma la complessità operativa sale. Per un team IT abituato a gestire un endpoint API, una flotta di macchine locali introduce patching, monitoraggio, sicurezza fisica e gestione della configurazione. Non è una vittoria automatica dell'on-premise; è un trade-off che va calcolato.
La sovranità dei dati aggiunge un peso economico e strategico. In settori regolamentati o in contesti europei, tenere i dati sul dispositivo riduce l'esposizione a obblighi di trasferimento e semplifica gli audit. Questo vantaggio non sempre compare nei fogli di calcolo, ma può influenzare la decisione più del costo per token. L'hardware locale diventa uno strumento di conformità, non solo di calcolo.
Il segnale che arriva da Nvidia cambia gli incentivi anche sul lato dell'offerta. Gli OEM di PC possono finalmente proporre un argomento concreto per il rinnovo dei dispositivi. I fornitori di API cloud rischiano di perdere quote di inference leggera, quella più sensibile al prezzo e alla latenza. E i team IT devono attrezzarsi per un'infrastruttura distribuita, con più punti di esecuzione e una governance più complessa.
Effetti di secondo e terzo ordine: chi si muove e chi rischia
Il primo effetto visibile è commerciale: il personal AI computer diventa un argomento di vendita per gli OEM. Non si tratta solo di prestazioni grafiche, ma di capacità di eseguire assistenti locali, analizzare documenti e proteggere la privacy. Questo può accelerare un ciclo di rinnovo hardware che l'industria attende da tempo.
Il secondo effetto è architetturale: i modelli dovranno essere progettati per girare bene su hardware vincolato. Questo non riguarda solo la quantization, ma anche la struttura dei modelli, la gestione dei token e l'efficienza delle operazioni. I laboratori che addestrano LLM inizieranno a pubblicare versioni esplicitamente pensate per l'esecuzione locale, con metriche di qualità e latenza adattate a questo contesto. L'addestramento massivo non scompare, ma l'attenzione si sposta verso la fase di esecuzione.
Il terzo effetto è operativo: le aziende dovranno gestire una flotta eterogenea di macchine locali, non solo un endpoint cloud. Questo richiede strumenti di orchestrazione, distribuzione dei modelli e monitoraggio. Il self-hosted non è solo una scelta tecnica, ma un nuovo carico di gestione. I team che investono in automazione e framework di deployment avranno un vantaggio; quelli che sottovalutano la complessità rischiano di ritrovarsi con hardware sottoutilizzato.
C'è anche un effetto di mercato sulle API cloud. L'inference leggera, quella che non richiede modelli enormi, è la più facile da spostare in locale. I fornitori cloud potrebbero reagire puntando su modelli più grandi, servizi gestiti e integrazioni che vanno oltre la semplice esecuzione. Ma la pressione competitiva aumenta: il dispositivo locale diventa una valvola di sfogo per i costi e per la latenza.
Sovranità dei dati e vincoli normativi: il contesto europeo
Un personal AI computer può processare documenti, email e conversazioni senza inviarli a server esterni. In Europa, dove il GDPR e le autorità di controllo pongono attenzione crescente ai trasferimenti di dati, questa capacità ha un valore specifico. Non si tratta solo di privacy individuale: per le aziende, mantenere i dati sul dispositivo riduce la superficie di rischio e semplifica la dimostrazione di conformità.
Il self-hosted diventa quindi una scelta di architettura con implicazioni legali. Un LLM eseguito in locale può operare su informazioni riservate senza che queste lascino il perimetro. Questo è un argomento concreto per studi legali, uffici finanziari, strutture sanitarie e pubbliche amministrazioni. Non elimina tutti i rischi — il dispositivo può essere perso o compromesso — ma cambia la natura del rischio: da trasferimento non controllato a sicurezza fisica e accesso locale.
Il trade-off è tra controllo e complessità operativa. Da un lato, il controllo diretto su modelli e dati è un vantaggio strategico. Dall'altro, la responsabilità della sicurezza, degli aggiornamenti e della configurazione ricade interamente sull'organizzazione. Non esiste una risposta unica: per alcuni carichi, il cloud con accordi contrattuali solidi può essere più adatto; per altri, l'on-premise è l'unica via percorribile. AI-RADAR ha sempre insistito su questo punto: la sovranità non è un valore assoluto, ma un requisito da valutare caso per caso.
La spinta di Nvidia non risolve questa tensione. La rende più visibile e più praticabile. Quando l'hardware locale è abbastanza capace, il confine tra ciò che deve restare interno e ciò che può andare nel cloud diventa una decisione di progettazione, non un limite tecnico. E questo obbliga le aziende a dotarsi di criteri di valutazione, non solo di preferenze.
Cosa guardare da qui in avanti
Il primo segnale da monitorare è l'evoluzione della VRAM nei sistemi consumer e professional. Se la memoria video cresce in modo significativo, modelli più grandi diventeranno eseguibili in locale e il punto di equilibrio tra cloud e on-premise si sposterà ulteriormente. Non serve una rivoluzione: bastano incrementi incrementali per allargare il numero di casi d'uso.
Il secondo segnale è la qualità degli strumenti di quantization e compressione. Se le tecniche riescono a ridurre l'impatto sulla qualità, il vincolo di memoria diventerà meno stringente. Alcune pipeline stanno già combinando quantization, pruning e architetture più efficienti per ottenere modelli che girano su hardware modesto. Questo è un campo di ricerca che AI-RADAR seguirà con attenzione.
Il terzo segnale è l'emergere di framework di orchestrazione per flotte locali. Gestire un personal AI computer è diverso da gestire un server: serve distribuire modelli, aggiornarli, monitorarli e revocarne l'accesso. Gli strumenti che semplificano queste operazioni saranno cruciali per trasformare l'hardware locale in infrastruttura affidabile.
Infine, vale la pena osservare come reagiranno i fornitori cloud e i laboratori di modelli. Se i modelli locali diventeranno una categoria riconosciuta, vedremo versioni ottimizzate, benchmark dedicati e prezzi più trasparenti. La mossa di Nvidia non chiude il dibattito tra cloud e on-premise: lo riapre, spostando l'asticella verso il basso, dove i personal computer diventano infrastruttura. Chi progetta LLM on-premise dovrà abituarsi a ragionare su questa scala.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!