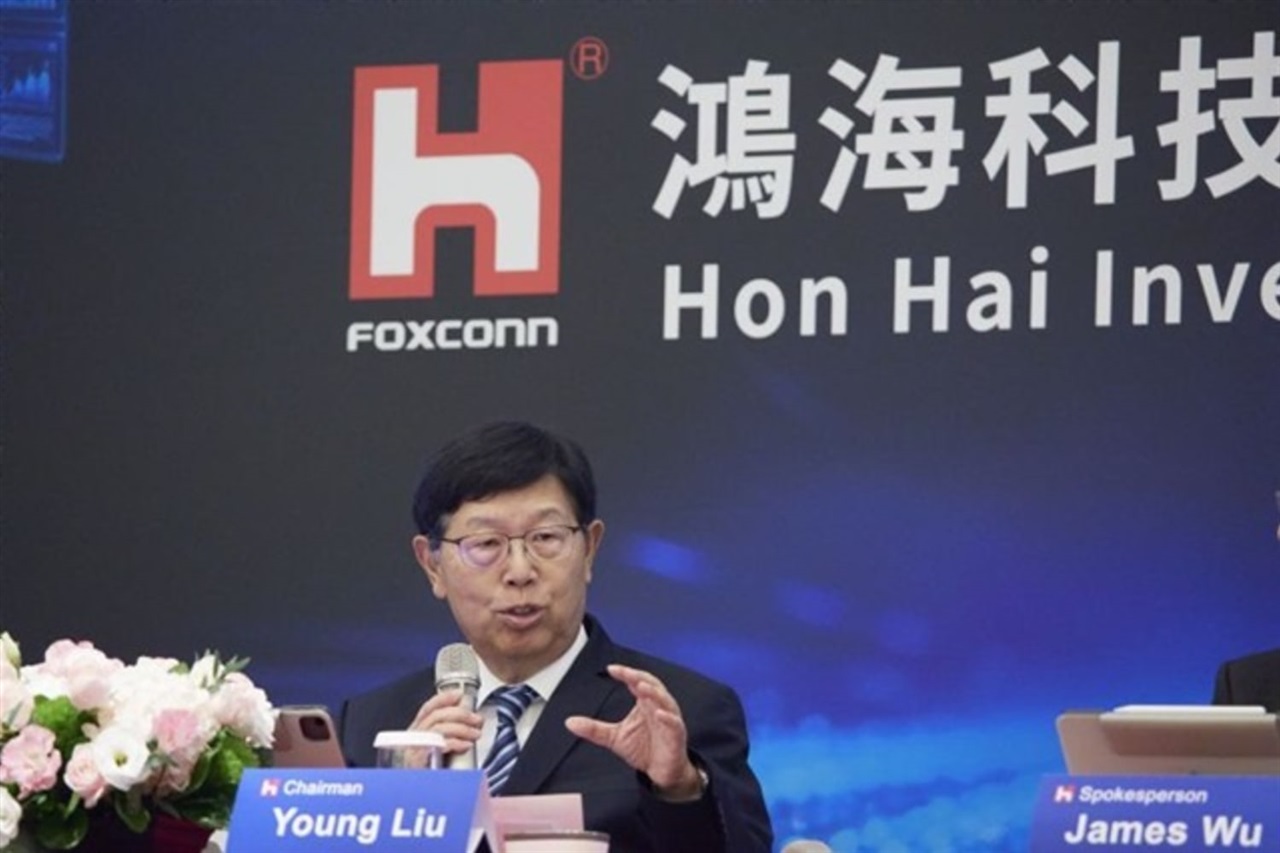
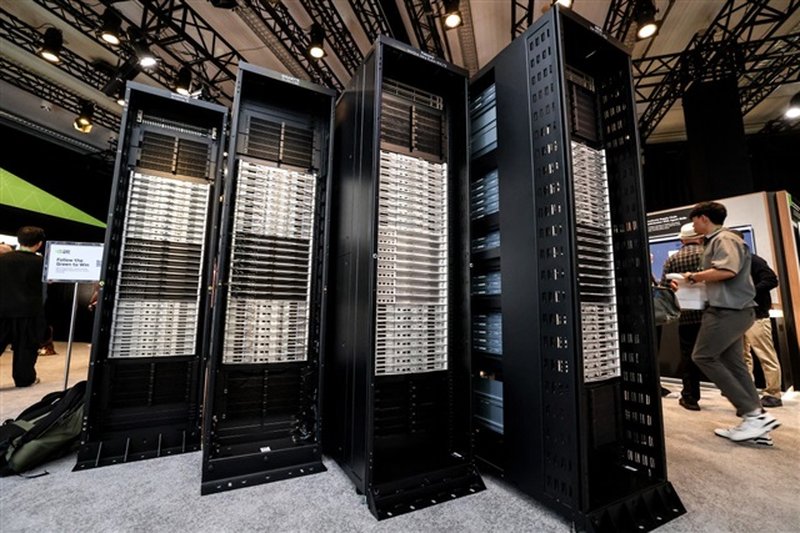
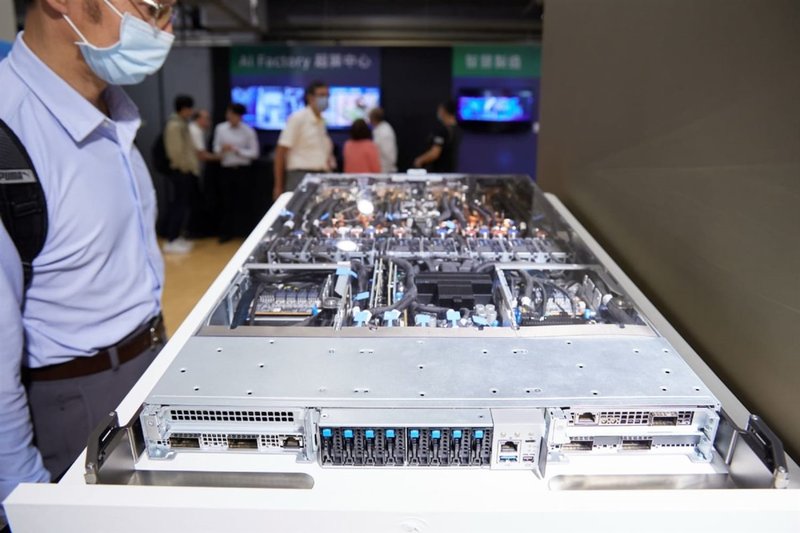
Nel terzo trimestre del 2026 le spedizioni di server AI di Foxconn raccontano una domanda di calcolo che non marcia più a un ritmo unico. I sistemi basati su ASIC hanno raggiunto 1,5 volte il volume dello stesso periodo dell'anno precedente; i server GPU sono cresciuti del 70%. I due numeri, riportati da Digitimes, non si limitano a fotografare un trimestre positivo: mostrano come l'infrastruttura per i Large Language Models si stia separando in due mercati con logiche diverse.
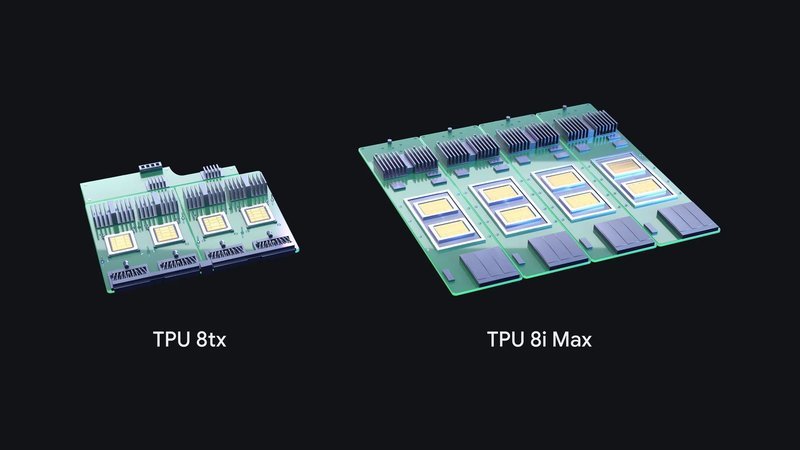
Foxconn è un produttore a contratto: non progetta i chip, ma assembla server per hyperscaler e grandi fornitori cloud. L'aumento delle spedizioni ASIC riflette quindi decisioni di acquisto già prese a monte, spesso legate a workload di inference su larga scala dove il costo per token e l'efficienza energetica contano più della flessibilità. Un ASIC può essere ottimizzato per una classe ristretta di operazioni e, in quel perimetro, consumare meno e costare meno per unità di lavoro rispetto a una GPU general purpose. La GPU conserva però un vantaggio decisivo quando il carico cambia spesso, quando serve sperimentare con modelli diversi o quando il fine-tuning e lo sviluppo richiedono un ecosistema software maturo.
Il divario tra i due tassi di crescita ha implicazioni di secondo ordine. Per i grandi fornitori cloud, spingere i volumi su ASIC riduce la dipendenza da un unico fornitore di acceleratori e dà più controllo sui costi unitari dei servizi di inference. Per un produttore come Foxconn, la crescita ASIC porta ricavi, ma anche un legame più stretto con le roadmap di pochi clienti: margini, volumi e rischi si concentrano su programmi specifici, diversi dal mercato più liquido dei server GPU. Per chi gestisce infrastruttura in proprio, il messaggio è che il confronto fra acceleratori non è più una questione di generazione di GPU, ma di mappare il carico di lavoro: una pipeline di inference stabile e ad alto volume può avere un TCO molto diverso da un ambiente di ricerca che cambia modello ogni mese.
C'è anche un effetto di terzo ordine. Se la quota di capacità dedicata a inference specializzata continua a crescere, il parco installato diventa più eterogeneo: non più solo GPU intercambiabili, ma una combinazione di silicio general purpose e custom. Questo rende più importante la portabilità del software, la qualità dei runtime e la capacità di spostare un modello da un acceleratore all'altro senza riscrivere l'intera pipeline. Le imprese che valutano deployment on-premise devono ragionare non solo sulla potenza di picco, ma su questi costi di gestione e lock-in. AI-RADAR mette a disposizione framework analitici su /llm-onpremise per confrontare i trade-off senza semplificazioni.
In definitiva, il dato Foxconn non dice che le GPU stiano perdendo rilevanza: un aumento del 70% resta una crescita forte. Dice però che la prossima ondata di capacità AI sarà sempre più costruita attorno a workload specifici, con hardware pensato per un compito. Per l'industria è il segnale che il mercato degli acceleratori sta diventando maturo, differenziato e meno prevedibile nei rapporti di forza tra fornitori.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!