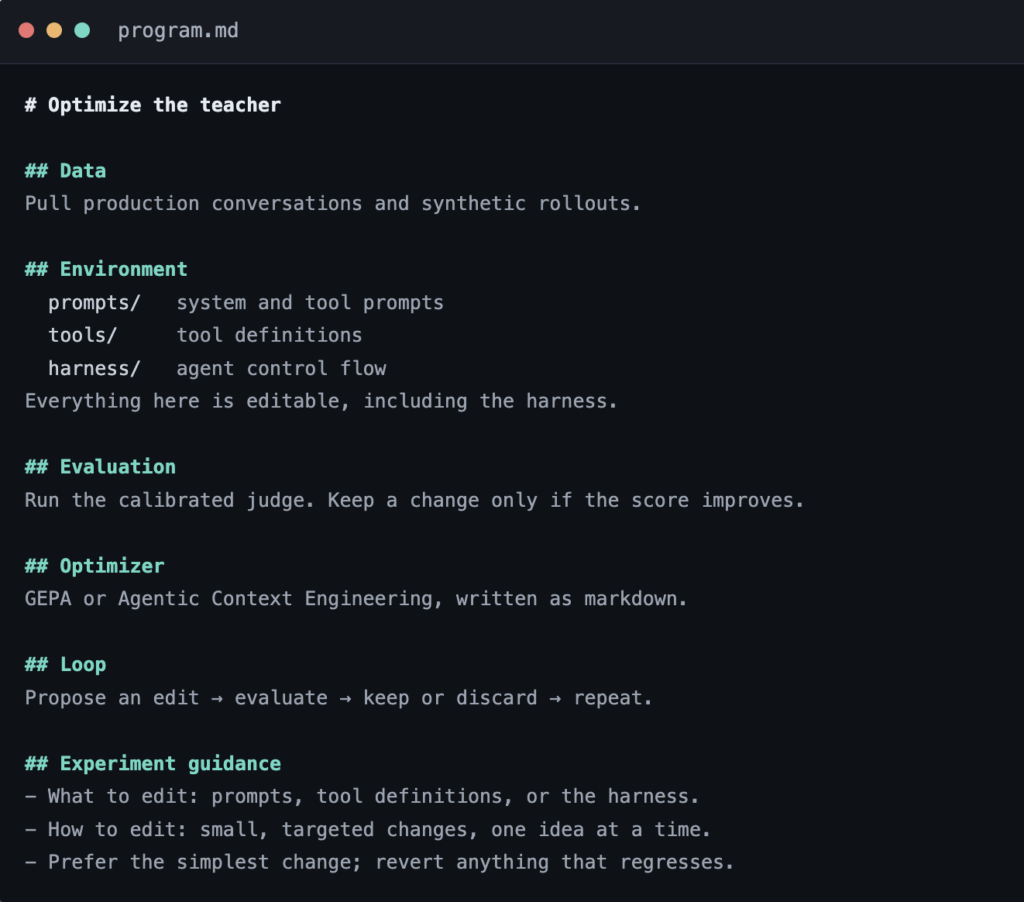
Shopify ha descritto un caso di studio che sposta il punto in cui l'esperienza di produzione si accumula. Non si limita a migliorare i prompt attorno a un LLM: usa i fallimenti reali per aggiornare i pesi del modello. Il laboratorio è l'agente GraphQL, un sistema che risponde alle domande dei merchant scrivendo query sull'Admin GraphQL API. In produzione arriva fino a 2.000 richieste al minuto. Il primo dato è economico: servire quel traffico con un modello frontier costerebbe circa 27 milioni di dollari l'anno, mentre il modello specializzato scende a circa 1 milione. Un taglio del 96% del costo di serving, con qualità che supera il frontier.
Il punto di partenza non è il modello, ma la definizione di qualità. Shopify costruisce una rubrica che trasforma i requisiti di prodotto in criteri con punteggio: completezza, esecuzione, qualità della risposta, sicurezza. Il ground truth non include solo esempi curati, ma traffico campionato in modo casuale. Un giudice viene calibrato con DSPy e ottimizzatori riflessivi come GEPA e ACE. Prima ancora, due annotatori esperti annotano 25 campioni casuali e si misura l'accordo con il kappa di Cohen. Se è troppo basso, la rubrica è ambigua e va iterata. Il motivo è semplice: se confonde chi lavora ogni giorno sul prodotto, confonderà anche un LLM.
Dall'harness ai pesi
I modelli frontier hanno pesi congelati. Le correzioni si accumulano fuori dal modello: nei prompt, negli esempi di retrieval, nelle regole di routing, nel codice. Shopify prova prima a spingere quell'harness al limite, trattandolo come un problema di autoresearch: un agente propone modifiche a prompt, definizioni di strumenti o codice, valuta il risultato con il giudice e mantiene solo i miglioramenti. Quando i guadagni si stabilizzano, il loop passa allo spazio dei parametri. Il sistema estrae dal traffico anonimizzato i casi difficili che il giudice valuta male. Una giuria di modelli reasoning frontier li corregge; un arbitro fonde le critiche in un'istruzione di riparazione; la conversazione viene rigiocata e valutata di nuovo. Se passa, diventa una traiettoria per il reinforcement learning. Se non passa, va all'annotazione umana, con Toloka che usa la stessa rubrica del giudice.
L'addestramento avviene in due fasi. La prima è un fine-tuning supervisionato su traiettorie complete, incluso il ragionamento, non solo le risposte finali. La seconda è GRPO, che usa il giudice calibrato come segnale di ricompensa. Il pipeline di auto-riparazione gira ogni giorno e aggiunge nuove traiettorie al corpus. Shopify esegue un fine-tuning full-parameter sui dati accumulati e poi ripete GRPO. PyTorch distribuisce l'addestramento su più GPU con parallelismo su tensori, contesto e dati.
Il conto dell'inference
Un modello migliore deve comunque girare. Il prompt di sistema dell'agente è lungo e statico, e ogni token generato deve attraversarlo tutto. La compressione gist riduce il prompt da circa 6.000 a circa 1.500 token appresi, senza perdita di qualità misurata dal giudice. In un test di carico a 350 richieste al minuto, il tempo al primo token scende del 19% e la latenza end-to-end del 38%. La stessa compressione aumenta le richieste al secondo del 16% e i token in uscita al secondo del 12% sulle stesse GPU, pari a circa il 14% di GPU in meno per lo stesso traffico.
Qui c'è il segnale strutturale più rilevante. Il caso Shopify non dimostra soltanto che un modello piccolo può battere un modello grande su un compito specifico. Mostra che il costo di serving smette di essere legato al prezzo per token di un'API esterna e torna a essere un problema di TCO dell'infrastruttura. vLLM, motore di inference costruito su PyTorch, tiene alta la throughput con il batching continuo e regge bene carichi con molte chiamate a strumenti. Per chi valuta deployment on-premise, i numeri sulla compressione e sulle GPU sono il punto di confronto: non si tratta di replicare un modello frontier, ma di costruire il loop che trasforma il traffico in addestramento.
Il prerequisito è il volume. Servono abbastanza conversazioni reali per generare hard negatives e un giudice affidabile. Un team con pochi utenti non ha la stessa miniera. Ma quando il traffico c'è, il vantaggio non sta nel prompt più elaborato: sta nella proprietà del ciclo di apprendimento. Per chi valuta il deployment on-premise, AI-RADAR offre framework analitici su /llm-onpremise per confrontare questi trade-off. E questo è molto più difficile da copiare.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!