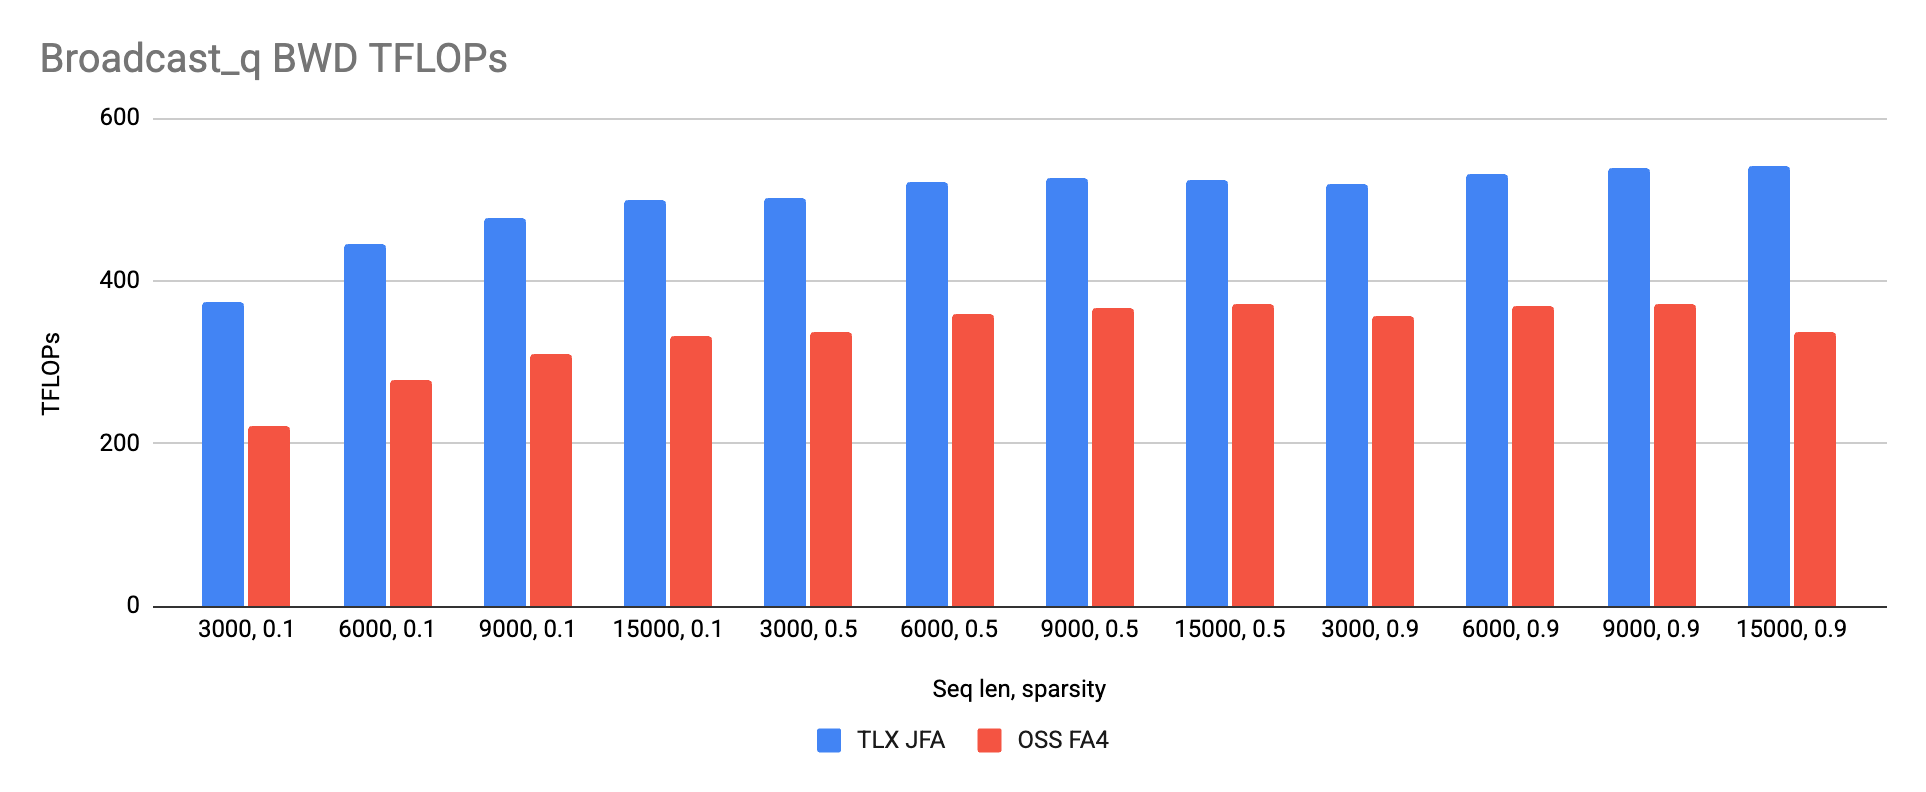
Nel training degli ads model di Meta l'attenzione è il kernel più lento, e su Blackwell B200 arrivare al picco ha finora richiesto kernel CuteDSL o CUDA scritti a mano: veloci, ma lenti da estendere quando un team di modeling introduce finestre scorrevoli, sparsità a blocchi o nuovi formati numerici. Il team che lavora sulla Jagged Flash Attention per GEM ha pubblicato un percorso alternativo: riscrivere il kernel con TLX, le estensioni a basso livello di Triton, e superare FlashAttention-4 sui carichi jagged broadcast-Q, con circa 3.200 righe di codice contro le 10.000 del kernel CuteDSL di FA4.
Il risultato non è marginale. In bfloat16 su B200, il forward è più veloce in media del 13% sui carichi jagged rilevanti per gli ads, mentre il backward guadagna circa il 50%. Sui carichi densi in stile LLM il forward resta competitivo, intorno all'87% di FA4, e il backward vince ancora con un +17%. Il vantaggio non deriva da un trucco isolato ma dalla combinazione di warp specialization, pipeline esplicite, allocazione manuale della memoria condivisa e dei TMEM, esecuzione persistente e bilanciamento software più Cluster Launch Control. Tutti elementi che in passato erano esprimibili solo in linguaggi a basso livello, mentre TLX li porta in codice Python leggibile.
Il punto di svolta: l'iterazione passa dai kernel engineer ai modeling engineer
Il dato più interessante non è il benchmark, ma chi può toccare il kernel. Con CuteDSL servono specialisti che conoscano barriere, TMA, MMA e allocazione dei registri; con TLX la struttura è scritta una volta e le varianti diventano fork della parte matematica. Lo dimostrano i due esperimenti citati: la versione MXFP8 (matmul a precisione microscaling, con P quantizzato FP8 al volo e fattori di scala nei tensor memory) riusa lo stesso scheletro warp-specialized e nel forward supera il kernel FP8 di FA4, con il backward in parità sui carichi densi. La variante block-sparse aggiunge solo l'iterazione sui blocchi selezionati e a un rapporto di selezione 0,5 corre da 1,3 a 1,5 volte più veloce del denso. In entrambi i casi, il grosso del kernel resta invariato.
Questo cambia gli incentivi. Le aziende che gestiscono cluster Blackwell per modelli self-hosted non devono più scegliere tra usare librerie generiche e assumere un team di esperti di CUDA per ottenere prestazioni accettabili. Possono partire da un kernel TLX, profilare con Nsight Compute e modificare solo la parte che serve, mantenendo il controllo su precisione, sparsità e gestione delle sequenze a lunghezza variabile. È un vantaggio concreto per chi ha vincoli di sovranità dei dati o carichi non standard che non giustificano un kernel team dedicato.
Il rovescio della medaglia
C'è però un costo di secondo ordine. La produttività di TLX sposta una parte della complessità sulla toolchain: il compilatore, il runtime Triton e le primitive a basso livello diventano infrastruttura critica. Chi adotta questo approccio dipende dalla capacità di PyTorch e della comunità di mantenere TLX stabile su ogni generazione di GPU, e deve comunque saper leggere i contatori hardware per capire dove si perdono cicli. Non è l'azzeramento della specializzazione, ma una sua redistribuzione: dal singolo kernel scritto a mano alla manutenzione condivisa di un framework.
Il codice è disponibile nel repository facebookresearch/ads_model_kernel_library, sotto tlx_jfa. La lezione per chi osserva il mercato dei kernel attenzione è che la barriera d'ingresso alla massima prestazione su Blackwell si sta spostando: non più quante righe di CuteDSL sai scrivere, ma quanto bene sai esprimere un'intenzione di scheduling in un linguaggio di alto livello. Per gli ads model di Meta, questo ha già prodotto un kernel più veloce e più mantenibile.


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!