
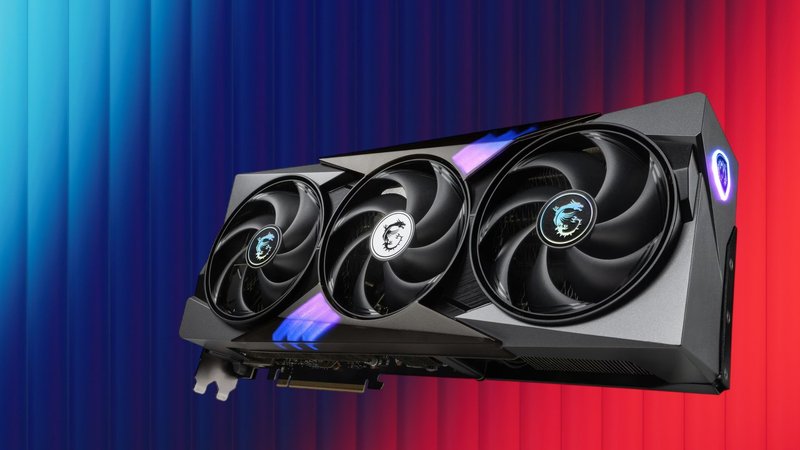
Openspline non è un nuovo LLM e nemmeno un framework di orchestrazione. È uno strato avatar open source che si aggancia agli agenti vocali già in produzione e genera, a partire da una semplice immagine, un volto parlante con labiale sincronizzato. Il dettaglio che sposta l'attenzione è dove avviene la generazione: sulla GPU locale dell'utente, non in un data center remoto. La versione lite del modello supera i 90 FPS su una NVIDIA RTX 4090, un dato che mette in discussione l'assunto secondo cui gli avatar realistici in tempo reale richiedano hardware server o servizi cloud specializzati.
La promessa tecnica è duplice. Da un lato, l'integrazione con un agente vocale esistente si riduce a poche righe di codice, il che abbassa la soglia per chi ha già una pipeline di voice AI e non vuole ricostruire l'intero stack. Dall'altro, l'esecuzione locale elimina la necessità di trasmettere flussi video e audio a servizi esterni per ottenere un avatar animato. Non è un dettaglio: quando gli avatar rappresentano persone reali o vengono impiegati in ambienti regolati, il controllo del dato resta un requisito, non un'opzione.
A livello strutturale, Openspline segnala che la generazione di avatar parlanti si sta spostando verso il self-hosting su hardware consumer. Fino a poco tempo fa, un'esperienza del genere era associata a servizi proprietari o a infrastrutture con GPU dedicate. Un progetto open source che raggiunge frame rate elevati su una scheda consumer cambia gli incentivi: per un'azienda che gestisce assistenti virtuali o interfacce conversazionali, diventa più plausibile valutare un deployment interamente locale, senza rinunciare a un volto animato. Il costo dell'hardware diventa una voce di CapEx confrontabile con il costo operativo ricorrente di un servizio cloud di avatar.
C'è anche un effetto di secondo e terzo ordine sul mercato. I fornitori di avatar cloud-based perdono una parte del loro vantaggio tecnico se uno strato open source può girare su GPU consumer. Allo stesso tempo, il carico si sposta sulla qualità del modello, sulla latenza di inference e sulla gestione della VRAM. Non basta generare a 90 FPS: serve che il sistema regga flussi audio in tempo reale, cambi di espressione, condizioni di illuminazione variabili. Qui sta il vero terreno di competizione, ed è un terreno dove il controllo locale può diventare un fattore di scelta determinante.
Il progetto è in fase molto iniziale, come ammette lo stesso autore nella presentazione. Non ci sono benchmark indipendenti, né indicazioni su requisiti di VRAM per il modello lite oltre alla RTX 4090 citata. Ma la direzione è chiara: la frontiera dell'avatar non è più necessariamente nel cloud. Per chi valuta deployment on-premise, AI-RADAR offre framework analitici su /llm-onpremise per valutare trade-off tra controllo locale e complessità infrastrutturale. La domanda aperta è se questo approccio riuscirà a scalare oltre la demo, quando gli agenti vocali dovranno gestire conversazioni lunghe e contesti visivi più complessi.







💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!