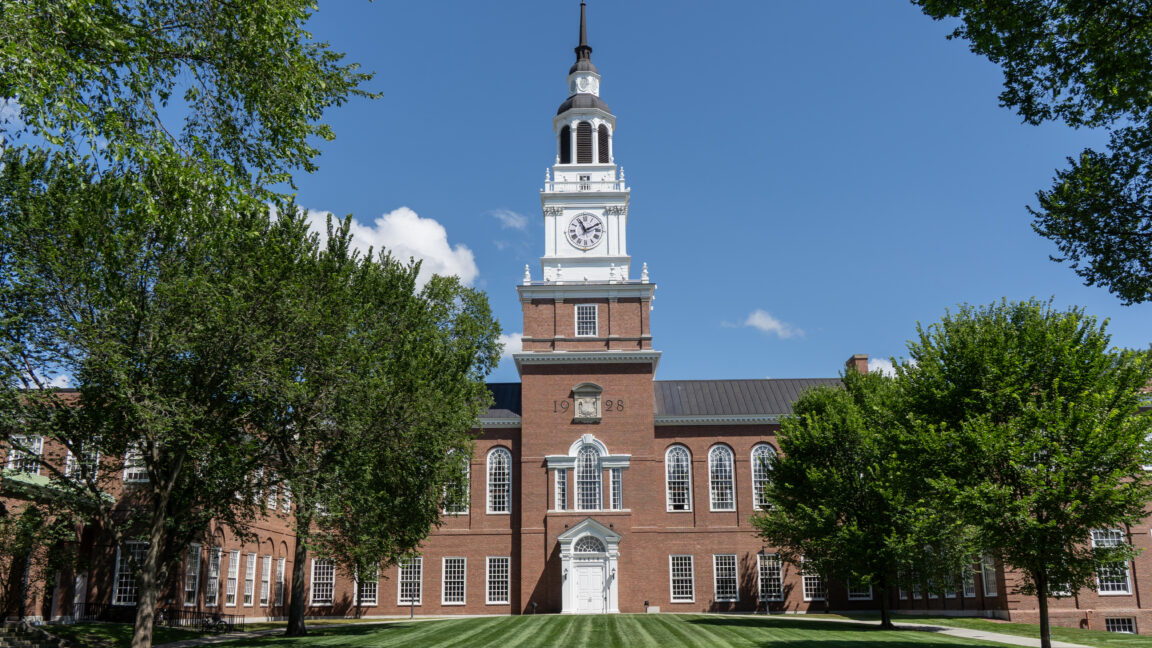
Il 9 agosto 2026 Santiago Schnell, provost del Dartmouth College, firmava sul Washington Post un editoriale intitolato «Universities are fighting AI cheating. But there’s a deeper problem». Questa settimana ha scoperto in prima persona quanto il problema fosse profondo: si è dimesso dopo che un comitato consultivo ha stabilito che non aveva dichiarato un uso significativo dell’intelligenza artificiale in un articolo accademico e nello stesso editoriale, nonostante gli editori richiedessero tale disclosure.
Il caso ha subito assunto contorni da lezione su come non si costruisce la governance dell’AI in un’università. Il comitato parla di «insufficient cooperation»: Schnell ha consegnato il portatile fornito da Dartmouth, ma non i log degli account LLM personali legati agli scritti sotto esame; non ha accettato di incontrare il comitato. La prova concreta arriva dall’account enterprise di Claude che Schnell usava tramite il college. Lì si vede l’LLM usato come strumento per rivedere articoli, trovare e correggere bug nel codice, modificare o generare figure.
La prima implicazione strutturale riguarda il valore forense degli account enterprise. Un’organizzazione che fornisce una licenza aziendale ha accesso ai log amministrativi e può ricostruire le interazioni. È esattamente ciò che ha permesso al comitato di procedere. Ma l’indagine si è fermata davanti ai confini dei dispositivi e degli account personali. Se un ricercatore usa un LLM con credenziali private, l’istituzione non vede nulla, a meno che non esistano policy di disclosure applicate con strumenti tecnici. Qui c’è il nodo: la governance basata sulla buona volontà non regge quando chi deve rispettarla è anche chi la predica.
C’è poi un effetto di secondo ordine sul mercato e sulle policy editoriali. Gli editori che già chiedono di dichiarare l’uso dell’AI potrebbero irrigidire le regole, passando da autocertificazioni a verifiche su log e cronologie. Le università, da parte loro, potrebbero spingere verso account istituzionali obbligatori e audit periodici. Ma questa strada rischia di produrre shadow AI: se il controllo diventa troppo invasivo, chi vuole evitarlo può semplicemente usare strumenti personali o servizi non tracciati dal datore di lavoro. Il risultato è un incentivo a formalizzare solo l’uso visibile, lasciando il resto nell’ombra.
Per chi valuta deployment self-hosted o on-premise, il caso segnala una differenza sottile ma importante. In un contesto cloud enterprise, il fornitore conserva i log e può renderli disponibili all’organizzazione, come accaduto a Dartmouth. In un ambiente self-hosted, l’organizzazione può gestire i log in locale con maggiore sovranità sui dati, ma deve comunque imporre policy di audit e non può impedire che le persone usino servizi esterni con account personali. L’audit trail non è un effetto automatico né del cloud né dell’on-premise: è una scelta di controllo. Per chi valuta questi trade-off, AI-RADAR propone framework analitici su /llm-onpremise per mettere a confronto vincoli e incentivi.
Il dettaglio più pesante, alla fine, non è che Schnell abbia usato Claude per correggere bug o rifinire figure. È che il comitato abbia dovuto ricostruire tutto da un account aziendale mentre l’interessato non collaborava. Se il futuro della governance dell’AI nelle istituzioni passa per l’accesso ai log, il caso Dartmouth pone una domanda scomoda: quanti usi restano invisibili semplicemente perché avvengono fuori dai canali ufficiali?


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!