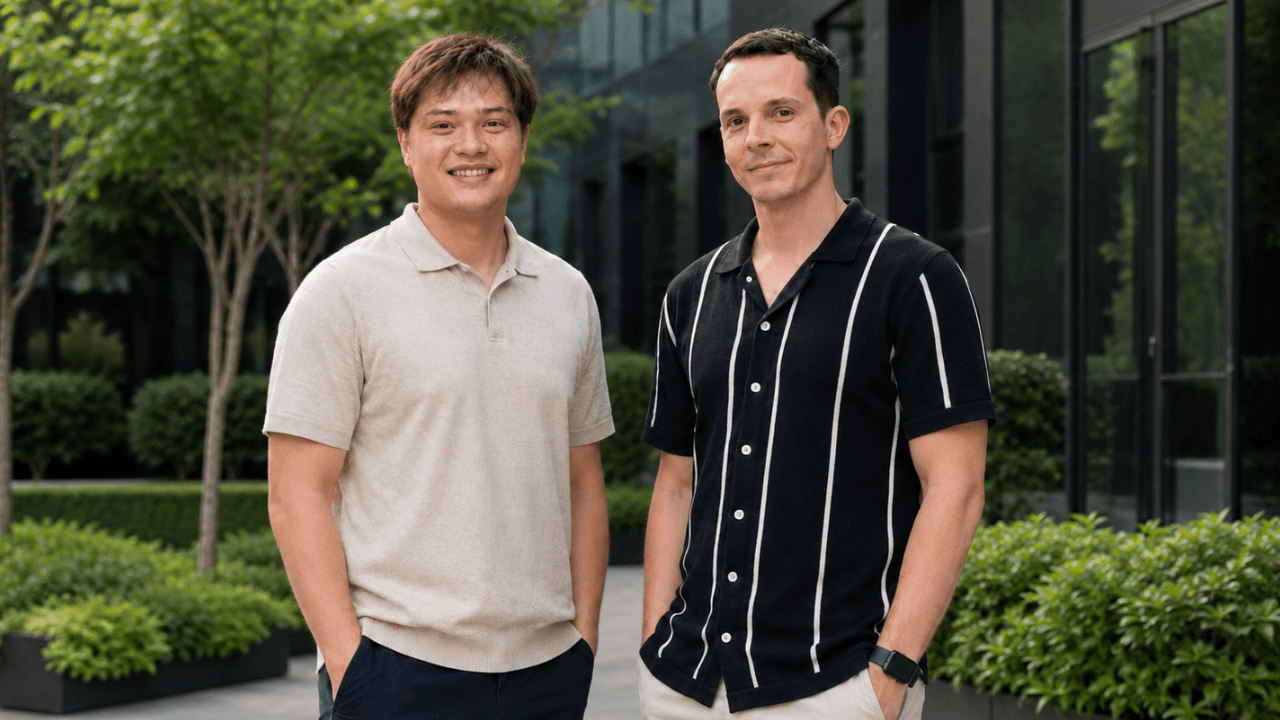
Il problema dell’AI fisica non è quasi mai il modello. È il dato che manca. Per un sistema di percezione che sorveglia una costa, riconoscere una barca in piena luce è banale; riconoscere un oggetto piccolo nell’angolo in alto a sinistra, lontano, magari in una condizione mai registrata, è un’altra cosa. DiffuseDrive, startup ungherese, lavora proprio su questa zona cieca: genera dati sintetici per addestrare i sistemi di AI fisica dove i dataset reali non arrivano.
Gabor Vecsei, VP of AI Engineering, e Daniel Schmid, AI Research Lead, descrivono una differenza netta rispetto ai Large Language Models. Nel linguaggio naturale il web offre un corpus testuale enorme; nell’AI fisica i dati sono scarsi, costosi e spesso pericolosi da raccogliere. Le applicazioni — difesa, aerospace, mining, veicoli autonomi — condividono lo stesso vincolo: gli scenari che servono davvero sono rari e difficili da riprodurre.
Il metodo di DiffuseDrive parte dal cliente. Analizza il dataset esistente, la rete neurale già addestrata e i difetti noti, poi individua i buchi e genera i dati per chiuderli. In un sistema di mining autonomo, per esempio, la fauna o il bestiame possono diventare una priorità se il sistema non li ha mai incontrati. È un processo iterativo: generazione, aggiunta al dataset, retraining, nuova analisi.
Il controllo, non il realismo
La parte tecnicamente più delicata è il controllo sull’output. Un modello generativo standard può inserire un palloncino in una scena; farlo comparire a grande distanza e fargli occupare solo dieci pixel è molto più complesso. DiffuseDrive ha costruito una soluzione dedicata per governare posizione e dimensione degli oggetti. Questo è cruciale nei sistemi di difesa, dove un oggetto può essere piccolo, lontano o collocato in un punto inusuale del campo visivo della telecamera.
Il realismo resta necessario, ma non sufficiente. L’azienda non si fida soltanto dell’occhio umano: un’immagine visivamente convincente non è necessariamente utile per l’addestramento. Per questo esistono controlli di qualità automatici e, quando serve, persone nel loop che ispezionano i dataset. Il criterio ultimo non è l’estetica dell’immagine, ma l’effetto sulla rete neurale che la consumerà.
Il vincolo è l’infrastruttura, non solo il dato
Uno degli aspetti più rilevanti per chi opera fuori dal cloud è la possibilità di consegnare un sistema air-gapped da installare sull’infrastruttura del cliente. I team di machine learning possono usarlo senza passare da DiffuseDrive. In questo scenario il tempo di generazione dipende dal calcolo disponibile: con un cluster GPU adeguato si parla di ore; con una sola GPU il vincolo è l’hardware. Per chi valuta deployment on-premise, AI-RADAR offre su /llm-onpremise un punto di osservazione su questi trade-off, ma qui la scelta infrastrutturale incide direttamente sulla velocità del ciclo dati-modello.
Questa impostazione rovescia la retorica del volume. Vecsei lo chiarisce: si possono raccogliere milioni di immagini guidando per strada senza catturare nulla di utile per il cliente. Il valore non è la quantità, ma la pertinenza dei casi limite. DiffuseDrive riporta miglioramenti superiori al 10% quando dati sintetici e reali vengono combinati; il beneficio maggiore è la robustezza su scenari che il modello non ha visto in addestramento.
Il fronte competitivo è meno scontato di quanto sembri. I concorrenti più difficili sono spesso i clienti stessi, che dispongono già di workflow e pipeline interne. DiffuseDrive deve dimostrare perché un approccio diverso produca risultati misurabili, senza poter vedere il sistema interno con cui si confronta. Anche i simulatori tradizionali competono sullo stesso terreno, ma secondo Schmid non garantiscono sempre il fotorealismo che serve ai sistemi di percezione.
Vista in prospettiva, la storia di DiffuseDrive segnala uno spostamento strutturale: nell’AI fisica il vantaggio non si costruisce accumulando dati grezzi, ma trasformando capacità di calcolo e conoscenza del dominio in casi limite controllati. Chi possiede cluster GPU e dataset proprietari può accorciare il ciclo e tenere dentro i propri confini i dati sensibili; chi vende solo modelli generalisti rischia di restare fuori dai deployment più specifici. Non è un caso che l’azienda veda una domanda crescente in difesa, soprattutto in mercati come la Germania.
È una dinamica particolarmente europea. Vecsei prevede che le aziende si sposteranno verso modelli specializzati e versioni più piccole di quelli attuali, sia per ridurre i costi di calcolo sia per adattare i modelli ai propri casi d’uso. In Europa la capacità di calcolo non è paragonabile a quelle di Stati Uniti e Cina; la specializzazione è una via alternativa alla corsa sui grandi modelli di fondazione.
Il prossimo passo di DiffuseDrive guarda alla robotica e va oltre la generazione visiva. L’obiettivo è comprendere registrazioni di esperimenti robotici esistenti — video, flussi di sensori e metadati — e trasformarle in annotazioni dense di azioni, eventi e cambi di stato. È lo stesso principio applicato a un’altra forma di scarsità: non manca il segnale grezzo, manca il significato addestrabile.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!