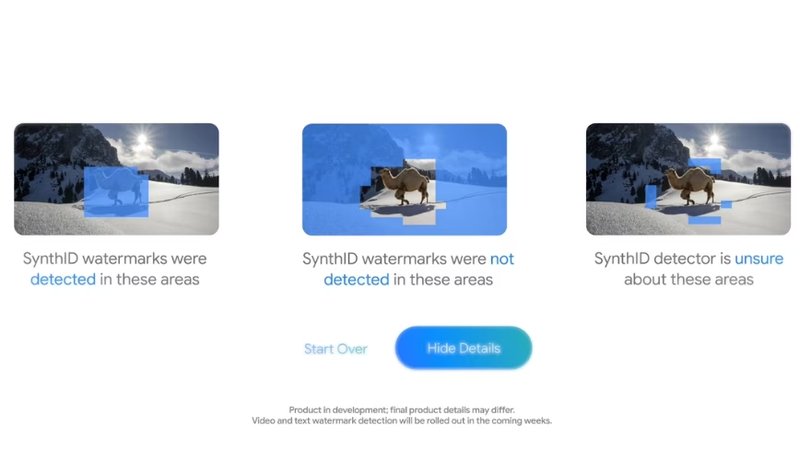
Anthropic ha scelto SynthID-Text, il meccanismo open source creato da Google, per i prossimi modelli Claude. La scelta si allinea alla nuova normativa europea sul watermarking dei contenuti sintetici, ma un filone di ricerca recente mostra che non si tratta di un semplice timbro invisibile. SynthID-Text usa una chiave segreta per modificare il processo con cui il modello sceglie il token successivo: dove il modello avrebbe scelto 'nuvoloso', la chiave può spostare la scelta su 'coperto'. Chi possiede la chiave può stabilire se il testo proviene dalla piattaforma. Fin qui è tracciabilità. Il problema è che la modifica si propaga ad altri comportamenti.
La ricerca citata da Ars Technica indica che SynthID-Text non altera soltanto la selezione lessicale. Cambia anche gli strumenti che un modello invoca quando opera come agente e può indebolire l'aderenza alle protezioni di sicurezza apprese in fase di addestramento. Con un prompt avversario, un'istruzione che il modello normalmente rifiuterebbe può in alcuni casi essere eseguita una volta attivato il watermarking. Tra gli esempi citati c'è la rivelazione di password o altre informazioni sensibili. Non è un problema teorico: è un cambio di comportamento in inference, ottenuto senza modificare i pesi del modello.
Perché il watermarking tocca la sicurezza
Il motivo è strutturale. SynthID-Text non aggiunge un'etichetta a posteriori: interviene nella distribuzione di probabilità dei token. Un LLM già sottoposto a fine-tuning per rifiutare richieste dannose può essere spostato fuori dal percorso di rifiuto da perturbazioni apparentemente minime. Nei sistemi agentici il punto è ancora più delicato: la scelta dello strumento da chiamare diventa meno prevedibile, e un errore di selezione può trasformarsi in un'azione con effetti reali. Questo spiega perché i test di sicurezza eseguiti senza watermarking possono restituire un framework diverso da quello che accade in produzione.
Cosa cambia per chi gestisce modelli in casa
Per le organizzazioni che eseguono LLM self-hosted, la chiave segreta diventa un asset di sicurezza aggiuntivo. Chi la compromette può verificare la provenienza dei testi generati e, in uno scenario di agenti, potrebbe usare questa capacità per affinare prompt avversari. Allo stesso tempo, il team interno ha la possibilità di testare il modello nella configurazione esatta che userà in produzione, includendo il watermarking nei pipeline di red teaming e nei test sulle chiamate agli strumenti. Questo non elimina il rischio, ma evita di scoprire le deviazioni di comportamento solo dopo il rilascio. Per chi valuta deployment on-premise, AI-RADAR raccoglie framework analitici su /llm-onpremise per confrontare configurazioni, vincoli di custodia delle chiavi e costi operativi.
Andrea Siposova, ricercatrice di sicurezza AI presso Lasso Security, ha riassunto il punto: il watermarking è progettato per non essere percepibile dal lettore, ma qualsiasi modifica alla generazione produce compromessi che emergono da qualche parte. La frase segnala un cambiamento di prospettiva necessario: il watermarking non va trattato come metadato passivo. Va trattato come un componente del sistema che può interagire con la sicurezza, la scelta degli strumenti e la riproducibilità delle risposte. In uno scenario normativo che spinge verso la tracciabilità, il punto non è se adottarlo, ma come verificare che non sposti il comportamento del modello in direzioni non previste.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!