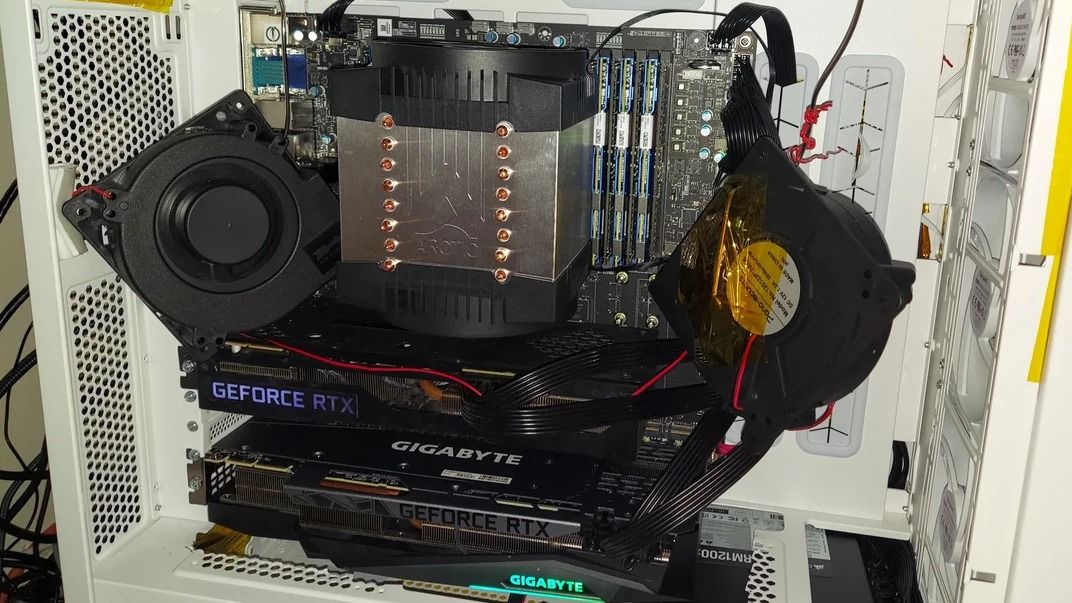
La notizia arriva da un homelabber: due schede GeForce RTX 3090, abbinate a una configurazione basata su Intel Optane di seconda generazione, bastano per caricare ed eseguire un modello Kimi AI da 2,8 trilioni di parametri. Il throughput dichiarato è di 3,11 token al secondo. Non è un dato che farà concorrenza ai datacenter, ma il segnale che manda è più interessante del numero stesso.
In uno scenario di inference tradizionale, i pesi di un LLM devono stare nella VRAM delle GPU. Quando il modello supera la capacità combinata delle schede, l'unica strada è alleggerire il checkpoint o distribuire il lavoro su più nodi. Qui invece entra in gioco una gerarchia di memoria: i parametri non attivi in un dato momento possono risiedere su storage a bassa latenza come Optane, mentre le GPU processano solo la porzione necessaria a ogni token. È un approccio che sacrifica throughput ma abbassa drasticamente la soglia hardware per sperimentare modelli di scala enorme.
Il risultato, 3,11 token al secondo, è lento per un assistente conversazionale, ma può avere senso per batch, valutazioni o test di qualità su dataset locali. Il punto strutturale è che il costo di ingresso per l'inference self-hosted non è più dettato esclusivamente dalla VRAM complessiva. Conta anche la capacità di orchestrare memoria volatile e persistente, e qui Optane ha un ruolo specifico per via della latenza più bassa rispetto agli SSD NAND tradizionali.
Questo cambia gli incentivi per chi non vuole o non può inviare dati a un'API cloud. Un'organizzazione con requisiti di sovranità dei dati può valutare un sistema on-premise basato su GPU consumer e memory tiering, accettando una latenza elevata in cambio del controllo completo. Il TCO va però calcolato con attenzione: il CapEx iniziale può essere basso, soprattutto acquistando hardware usato, ma i consumi elettrici, la manutenzione e il tempo di sviluppo della pipeline possono erodere i benefici.
A livello di mercato, esperimenti come questo segnalano che la frontiera dei modelli più grandi non è più monopolio dei fornitori di GPU datacenter. Chi sviluppa software per inference dovrà sempre più tenere conto di configurazioni eterogenee, dove VRAM, RAM di sistema e storage persistente collaborano. Non è detto che i cloud provider ne escano indeboliti, ma la pressione competitiva sul pricing per workload saltuari potrebbe aumentare.
Per chi valuta deployment on-premise, esistono trade-off tra costi iniziali, consumi e complessità operativa; AI-RADAR propone framework analitici su /llm-onpremise per orientarsi. Resta un limite chiaro: 3,11 token al secondo non sostituisce un'infrastruttura cloud per produzione. Ma come esperimento di confine, mostra che la distanza tra un homelab e un datacenter si misura ormai in compromessi di memoria, non solo in numero di GPU.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!