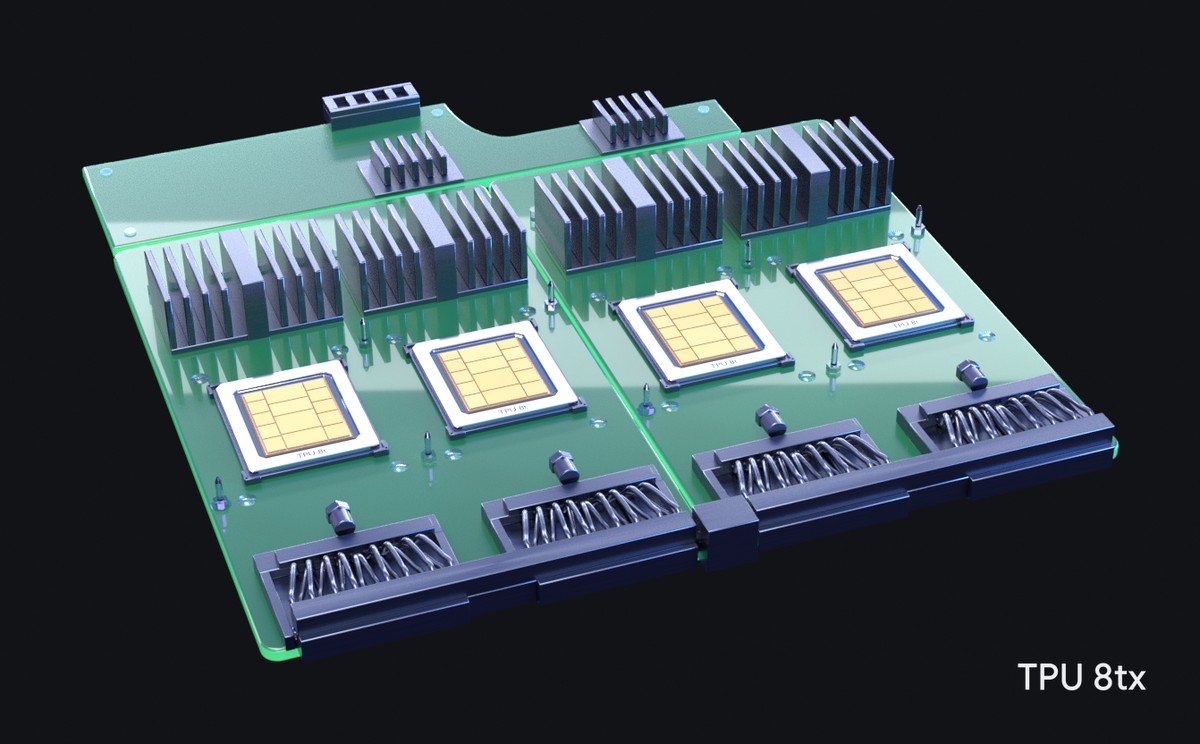
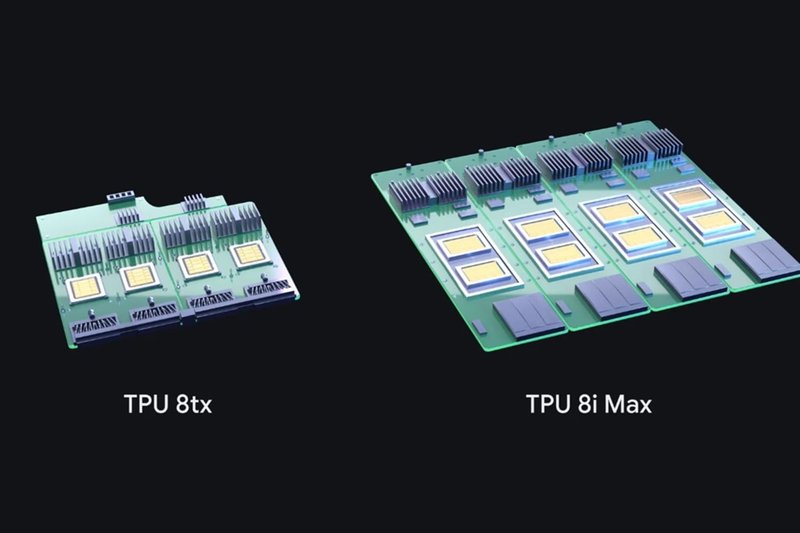
La notizia è essenziale ma carica di segnali: Google ha affiancato ai nuovi TPU 8tx host basati su AMD EPYC Turin e ha introdotto capacità di confidential computing; in parallelo, la variante TPU 8i Max raddoppia la bandwidth di memoria pensata per l'inference. Non si tratta di un semplice refresh hardware. La scelta di AMD come host per acceleratori custom segnala che nella partita dei server AI la specializzazione del silicio non elimina il ruolo dei processori general-purpose. Il confidential computing, inoltre, sposta il confronto dal piano delle prestazioni a quello della sicurezza dei dati in uso, un tema che per i carichi LLM gestiti in cloud ha un peso crescente.
Per chi lavora con modelli di linguaggio, il raddoppio della banda di memoria sulla TPU 8i Max è un dettaglio che conta più di quanto sembri. L'inference, soprattutto su LLM di grandi dimensioni, è spesso limitata dalla capacità di muovere i pesi e lo stato del modello tra memoria e unità di calcolo. Aumentare la bandwidth senza cambiare architettura di calcolo è un modo diretto per migliorare la sostenibilità di servizi che generano token in tempo reale. In un mercato in cui i costi operativi legati all'inference stanno diventando la voce dominante del TCO cloud, un salto di banda può ridurre la pressione su istanze più grandi o su ottimizzazioni troppo aggressive come la quantization.
Il framework per chi valuta deployment self-hosted è più sfumato. Le TPU restano una tecnicia che Google offre principalmente attraverso la propria infrastruttura cloud, non come componente acquistabile per un data center on-premise. Questo vincolo è strutturale: l'integrazione tra TPU, host EPYC e confidential computing è progettata per migliorare l'offerta di servizi gestiti, non per aprire una filiera di hardware indipendente. Per le organizzazioni che non possono spostare dati sensibili su cloud, la notizia non fornisce una risposta diretta, ma indica la direzione che prenderà il confronto quando dovranno giustificare la scelta tra cloud ad alte prestazioni e controllo locale. Per chi valuta deployment on-premise, i framework analitici su /llm-onpremise aiutano a soppesare trade-off di questo tipo, senza ricette preconfezionate.
C'è poi un effetto di secondo ordine sul mercato dei processori. AMD entra in un'infrastruttura AI di primissimo piano non con una GPU, ma con la CPU host. Questo rafforza la posizione di AMD nel data center e sottolinea che il valore di un fornitore non si misura solo sugli acceleratori. Per Intel, che sta cercando di recuperare terreno nelle CPU server, il messaggio è chiaro: i clienti hyperscaler non considerano più scontata la scelta del processore host, nemmeno quando l'acceleratore è proprietario.
Resta aperta la questione della sovranità dei dati. Il confidential computing risolve una parte del problema — protegge i dati durante l'elaborazione — ma non elimina il vincolo di dove quei dati risiedono e chi può accedere all'infrastruttura. Per carichi regolati da normative europee, questa distinzione è spesso più rilevante della pura potenza di calcolo. La combinazione di TPU, host AMD e sicurezza hardware alza l'asticella dell'offerta cloud, ma lascia intatto il tema del controllo fisico per chi non può accettare un perimetro gestito da terzi.






💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!