Un unico kernel GEMM che copre tre varianti algoritmiche e un autotuner che sceglie, forma per forma, la configurazione migliore. È la scommessa del backend lineare Helion per vLLM, frutto del lavoro congiunto del gruppo OCTO di Red Hat e del team Helion di Meta. L'integrazione punta a ridurre la complessità di sviluppo dei kernel e a migliorare le prestazioni di inference degli LLM su GPU NVIDIA Hopper, concentrandosi sui formati di quantization a 8 bit più diffusi nell'inference efficiente: FP8_Dynamic, W8A8_INT8 e Block_FP8.
Di norma, per ottenere buone prestazioni sui GEMM a 8 bit servono più implementazioni specializzate. Split-K divide la dimensione K tra più thread block quando le dimensioni M o N sono troppo piccole; Swap-AB riscrive A@B come ([email protected]).T per migliorare le forme con una M ridotta. In vLLM, per esempio, il backend Block_FP8 usa Swap-AB quando M è inferiore a 32 su Hopper. Queste euristiche funzionano in media, ma non sono ottimali per ogni modello o carico. Con Helion, una sola implementazione GEMM unificata copre Standard GEMM, Split-K e Swap-AB: le scelte algoritmiche sono esposte come parametri tunable e l'autotuner ahead-of-time seleziona la variante e la configurazione migliore per ciascuna forma di input.
Helion è un DSL per kernel nativo PyTorch e agnostico rispetto all'hardware, basato su un modello di tile programming. Permette di scrivere un kernel una sola volta in codice Python conciso e di generare codice specializzato per piattaforme diverse. L'autotuner AOT esplora sistematicamente uno spazio di ricerca che va dal layout di memoria e dallo scheduling fino alle scelte algoritmiche di più alto livello. In questo lavoro, split_k e swap_ab sono registrati come parametri tunable, con split_k limitato a valori potenza di due fino a 256. L'autotuner confronta le combinazioni e sceglie la migliore per ogni workload.
L'integrazione adotta una strategia di dispatch ibrida basata sul numero di token a runtime e sulla copertura dei CUDA Graph. Per forme piccole fino a max_helion_size, il backend lineare usa Helion sotto CUDA Graph replay; oltre quella soglia, ricade sui kernel predefiniti CUTLASS o DeepGEMM. Nel lavoro il valore scelto è 32. Questo elimina l'overhead CPU legato a dispatch e launch dei kernel Helion fuori dai CUDA Graph, riduce il numero di forme da ottimizzare e rende più gestibile la manutenzione dei config precalcolati.
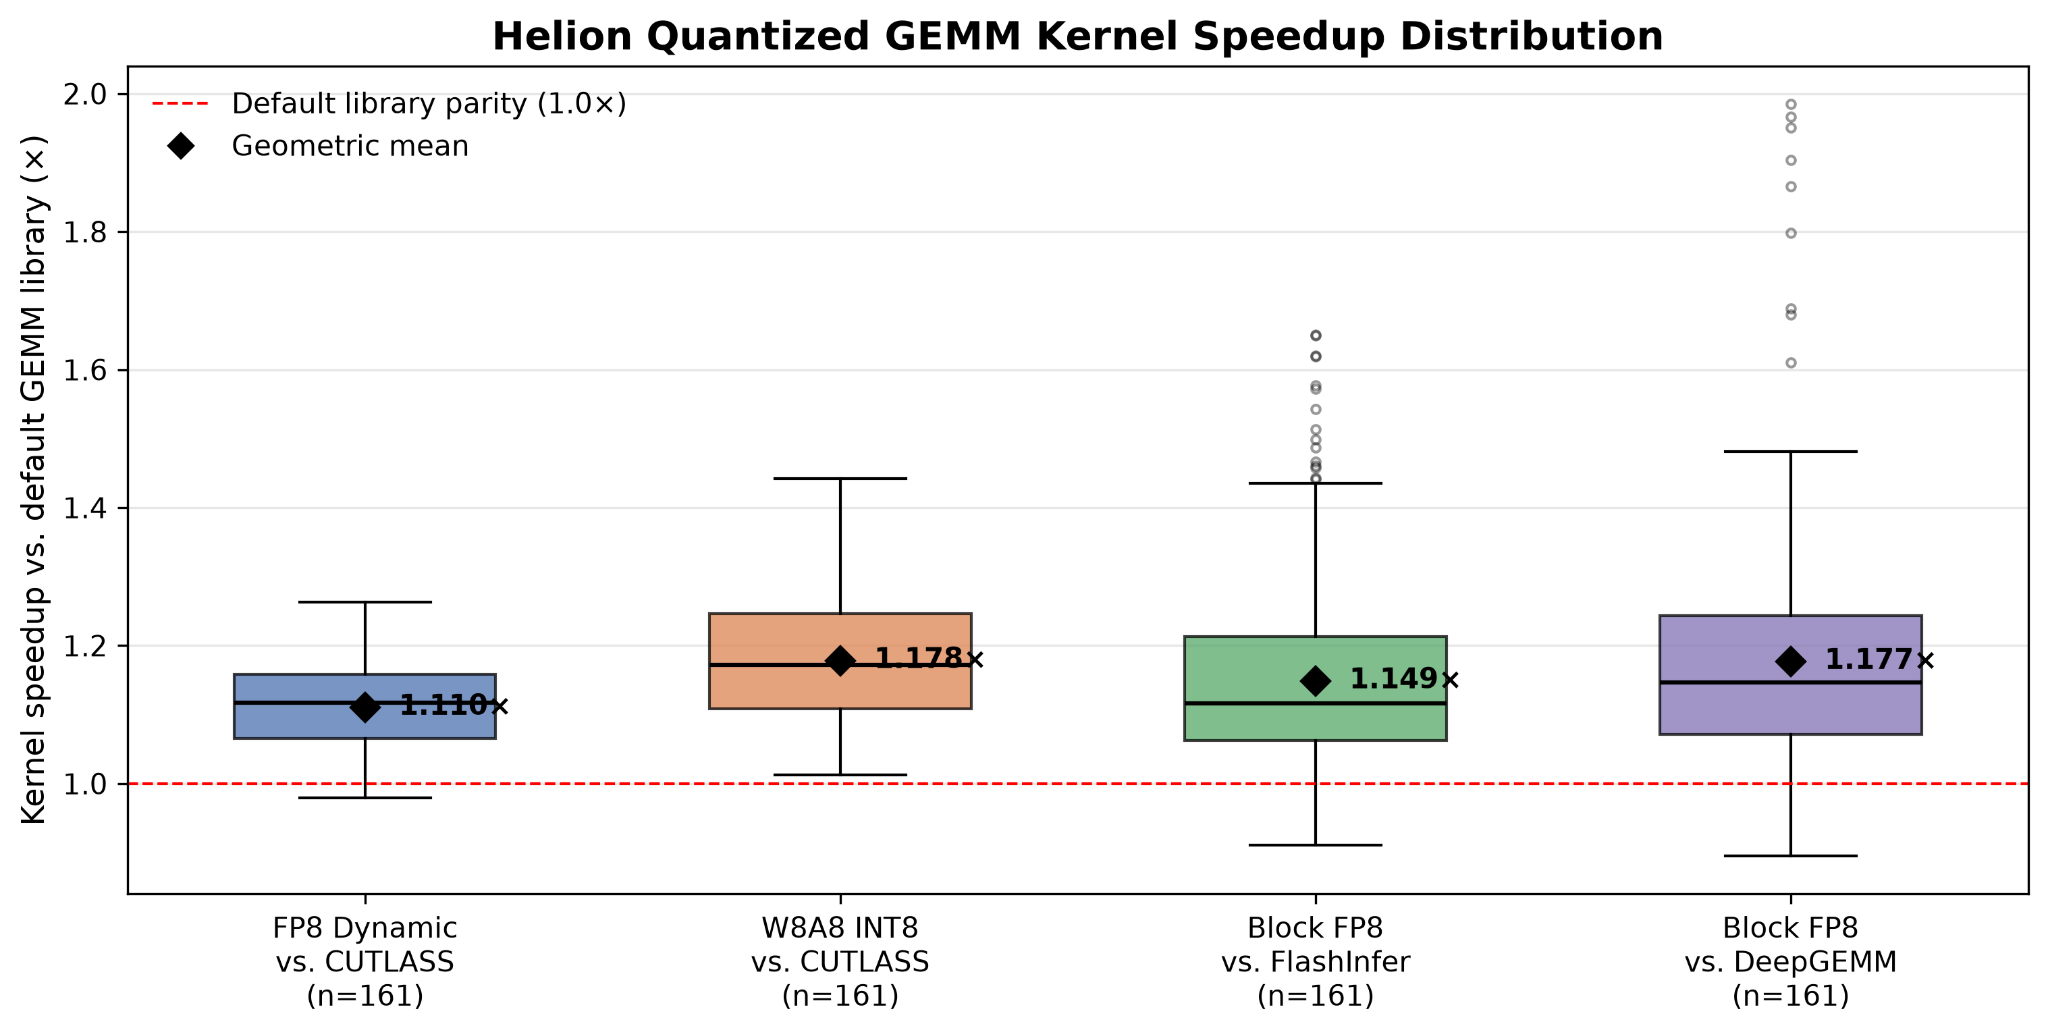
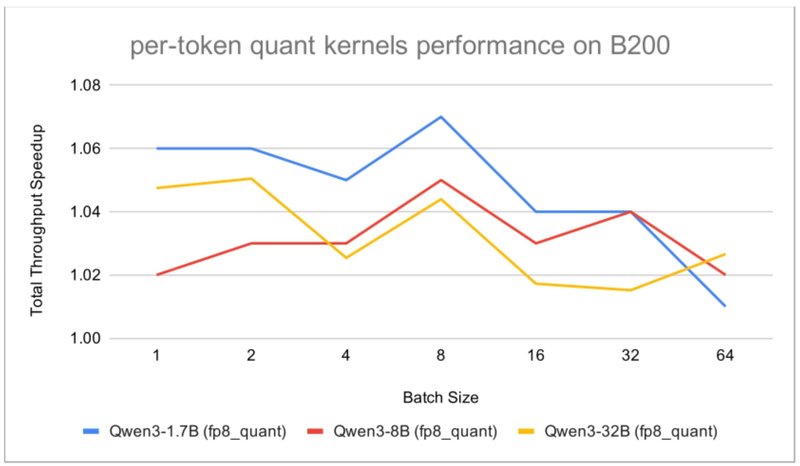
Sul piano prestazionale, i risultati presentati sono solidi. Su una GPU NVIDIA H100 80GB HBM3, i kernel Helion raggiungono speedup geometrici medi di 1.110× su CUTLASS per FP8_Dynamic, 1.178× su CUTLASS per W8A8_INT8, 1.149× su FlashInfer e 1.177× su DeepGEMM per Block_FP8. La distribuzione degli speedup varia da forma a forma, il che conferma il valore del tuning per forma rispetto a una configurazione unica o a un'euristica generica di dispatch. Nei benchmark end-to-end con vLLM serve e dataset ShareGPT, il backend Helion ha mostrato guadagni di throughput consistenti su modelli Qwen3 di diverse dimensioni, con miglioramenti superiori al 10% in alcuni workload.
Il punto strutturale non è soltanto il guadagno percentuale. Helion sposta l'ottimizzazione dei kernel da un lavoro artigianale, riservato a pochi specialisti di programmazione GPU di basso livello, a un problema di ricerca numerica automatizzata. Questo cambia gli incentivi: un team che serve un modello specifico su infrastruttura self-hosted può ottenere configurazioni ritagliate sul proprio carico senza dover mantenere internamente competenze CUDA profonde. Il costo si sposta invece sul tuning ahead-of-time, che può richiedere ore, e sulla gestione dei file di configurazione per i modelli più diffusi.
Qui emerge il compromesso tra prestazioni, usabilità e manutenibilità. Un tuning più fine migliora le prestazioni ma aumenta lo sforzo di autotuning lato cliente o l'onere di distribuire config precalcolati. Per i kernel GEMM studiati, il team sta valutando un modello in cui i kernel Helion e il framework di integrazione vengano mantenuti upstream con un config di default per test funzionali e CI, mentre l'autotuning specifico per workload venga delegato agli utenti finali. Lo strumento automatizzato consente di generare config ottimizzati per modelli e hardware prima del deployment. Questo approccio privilegia prestazioni e manutenibilità rispetto all'usabilità immediata, un tradeoff realistico per chi fa serving di modelli in produzione ed è disposto a investire in ottimizzazione offline.
Non è l'unica strada. Per kernel ausiliari come quantization, attivazioni e normalizzazione, i primi esperimenti indicano che si possono ottenere miglioramenti significativi con un numero ridotto di config, abbassando il costo di manutenzione e aprendo un'altra via all'adozione upstream.
Il lavoro è disponibile oggi in un fork di vLLM ed è descritto come pronto per l'uso in produzione dagli autori. Sul fronte hardware, il team Helion sta estendendo il supporto a NVIDIA Blackwell tramite il backend CuteDSL, con lavoro in corso anche su GPU AMD e TPU. L'estensione ai modelli MoE, dove il backend MoE diventa il target principale di ottimizzazione, è un altro obiettivo dichiarato. Per chi gestisce servizi di inference LLM in casa, il segnale è chiaro: i kernel predefiniti dei framework non sono un vincolo invalicabile, ma l'ottimizzazione specifica ha un costo di processo che va messo in conto nei deployment e negli aggiornamenti.


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!