LLM On-Premise – Deploy AI Locally
> SYSTEM STATUS: ONLINE
Soluzioni on-premise, configurazioni server, GPU workstation e infrastructure per deployare e gestire Large Language Models in locale. La sovranità inizia qui.
LLM On-Premise significa eseguire l'inferenza dei modelli linguistici interamente su infrastruttura che controlli — i pesi del modello vivono nella tua VRAM, il calcolo avviene sul tuo silicio, e zero bit raggiungono una API di terzi. È diventato pratico quando tre cose sono confluite: modelli open-weight genuinamente capaci (Llama, Qwen, Mistral, Gemma), la quantizzazione a 4-bit che li ha fatti entrare su singole GPU, e runtime maturi (Ollama, vLLM) che ne hanno reso di routine il serving. Il modello concettuale completo →
Questo osservatorio è il livello di supporto decisionale: esiste per l'ingegnere che dimensiona un server GPU, l'architetto che pesa l'on-prem contro una API, e il responsabile compliance che mappa l'EU AI Act su uno stack self-hosted. Il materiale è organizzato come un percorso:
- Questo carico deve girare in locale? → Decision Axes e il confronto tra deployment
- Su quale hardware? → Hardware Matrix e Model Cards
- In che forma? → Architetture di riferimento e Checklist
- Sotto quali regole? → Governance ed EU AI Act
Per i riferimenti evergreen di lungo formato — acquisto GPU, TCO reale, quantizzazione, costruire un ChatGPT privato — vedi le guide di AI-Radar.
> DECISION_SUPPORT_MATRIX
Framework decisionali basati sui vincoli per la pianificazione del deployment
Compare On-Premise, Hybrid, and API-Only deployment models across 5 decision axes.
ACCESS MATRIX →Industry-specific deployment scenarios with weighted constraints and failure modes.
Standardized deployment patterns with scenario fit analysis and implementation constraints.
Scenario-specific pre-deployment verification checklists. Manufacturing (uptime, edge), Pharma (21 CFR Part 11 validation), Enterprise IT (security, scalability). Verification gates, not recommendations.
VIEW CHECKLISTS →Constraint-focused decision reasoning engine for deployment planning questions.
QUERY SYSTEM →Curated cards for Llama 3.3 70B, Qwen3.6 27B, Mistral Small 3.1, Phi-4, Gemma 3 27B, DeepSeek-R1 32B — VRAM, license, and hardware tier.
BROWSE MODELS →Run LLM agents locally: LangGraph vs AutoGen vs CrewAI, tool sandboxing, persistent memory, token budgets, and security guardrails.
AGENT GUIDE →Mixture of Experts on consumer hardware: active vs total params, VRAM implications, quantization selection, and failure modes for Qwen3.6-35B-A3.7B and Mixtral.
MOE GUIDE →EU AI Act timeline, risk classification, high-risk obligations (Aug 2026 ⚡), and how on-premise deployment simplifies regulatory compliance.
COMPLIANCE GUIDE →> BENCHMARK_METRICS
Configurazioni target 2026 — Blackwell & Ada Lovelace
> LATEST_INTELLIGENCE

DeepSeek V4.1 Flash su Hugging Face: il self-hosting torna sotto i riflettori
La repository di DeepSeek V4.1 Flash compare su Hugging Face senza dettagli tecnici. Per i team che valutano LLM self-hosted, il solo annuncio...

NVIDIA e il 4B BF16: il peso specifico dell'inference locale
Un modello da 4 miliardi di parametri in precisione BF16 firmato NVIDIA Nemotron Labs appare su Hugging Face. Non è la dimensione a contare, ma il...

ORL spinge i diffusion LLM a 2.788 token/s su una RTX 5090
Il progetto ORL (On-Policy Residual Learning) promette di accelerare i diffusion LLM senza sacrificare la qualità. Su una singola RTX 5090 il team...

Beam di Reflection: ragionamento a token ridotti, memoria da 501 miliardi
Reflection ha rilasciato Beam, LLM aperto con architettura MoE da 501 miliardi di parametri totali e 23 miliardi attivi. Supporta contesto da 1...

Ragionamento nascosto: l’approccio ibrido che dimezza i token degli LLM
Un preprint di Stanford, Together AI, UIUC e Meta introduce i Hybrid Reasoning Agents: modelli che ragionano in modo interno e producono testo...

Tencent Hy-Memory-30B-A3B: perché 3B attivi contano più di 30B totali
La scheda del modello Tencent Hy-Memory-30B-A3B accende il dibattito su un dato sfuggente: un'architettura con 3 miliardi di parametri attivi su...
Qwen Flash Next: il quant Q2 GYRO-M sfida i team di ISTA Lab
Un test empirico di tre giorni su GYRO-M, quantization Q2 del modello Qwen Flash Next, segnala stabilità paragonabile al q3 ISTA con dimensioni...
Intel pubblica LLM-Scaler-vLLM PV 1.5: stack Docker per LLM su GPU Arc
Gli ingegneri software di Intel hanno rilasciato LLM-Scaler-vLLM PV 1.5, uno stack Docker pensato per semplificare l'inference di LLM su hardware...
Sovranità open source: il lavoro noioso che la rende concreta
Al Summit Europe l'attenzione va a GPU e AI, ma la parte più concreta viene dai piani di conformità CRA, metriche OSPO e obiettivi di migrazione...
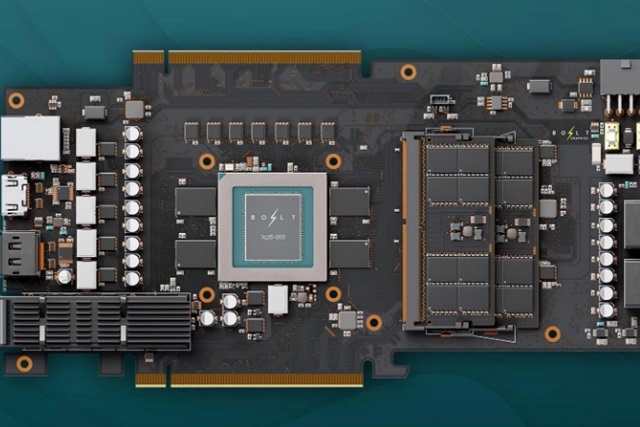
Bolt Graphics cerca 100 milioni di dollari per sfidare Nvidia e AMD con la GPU Zeus
Bolt Graphics cerca 100 milioni di dollari per sviluppare Zeus, una GPU che punta a sfidare Nvidia e AMD oltre i soli carichi AI. La fonte non...

PRISM insegna ai sistemi multi-agente a scegliere la topologia giusta per ogni query
PRISM recupera un segnale per-query da corpora di grafi verificati che non hanno ranking. Un teacher legge un grafo sibling tramite un ramo...
DeepUnfolding Agent: il controllo adattivo diventa un servizio esterno
La piattaforma FastAPI proposta da DeepUnfolding Agent separa il controller adattivo dall'esecuzione di dominio. Gli executor registrano uno...

Benchmark saturi: nei transcript resta segnale utile
Quando più modelli raggiungono punteggi quasi perfetti, i benchmark perdono capacità di distinguerli. Uno studio mostra che le trascrizioni...
DeepSeek-V4-Flash su 4 Radeon AI PRO R9700: la modalità da 79 tok/s funziona
Un test con quattro Radeon AI PRO R9700 reali mostra che il motore affinity gestisce la configurazione multi-GPU senza output degeneri. La...

Meta apre i pesi di Muse Spark Open: 816B parametri e contesto da 1M token
Meta rilascia i pesi di Muse Spark Open, modello da 816 miliardi di parametri totali e 42 miliardi attivi con finestra da 1M token. L'annuncio...
Nemotron 3.5 Bolt: un VLM da 74B compresso in 24 GB per l'on-premise
NVIDIA descrive Nemotron 3.5 Bolt come modello vision-language per task agentici locali: 74B parametri totali, 9B attivi, quantization nativa a 2...
GNOME Mutter migliora il damage tracking per le GPU secondarie
Un ritocco nel compositor di GNOME 52 limita le copie inutili tra le GPU nei portatili ibridi. Meno spreco di banda e batteria, con un effetto...
Microsoft e il modello locale da 137 miliardi di parametri: la mossa per il codice on-premise
Microsoft AI ha sviluppato una versione locale di MAI Code 1.1 Flash, modello di coding ottimizzato con architettura mixture-of-experts: 137...
Mr.Chatterbox-2.7B-Chat: un LLM addestrato da zero sui testi vittoriani
Presentato nella community da u/centerstate, Mr.Chatterbox-2.7B-Chat è un checkpoint pre-addestrato e rifinito con fine-tuning su testi vittoriani...
AMD W7900 e LFM2.5: il segnale di un on-premise sempre più concreto
La prova di un LLM da 24 miliardi di parametri su AMD W7900, con contesto da 128.000 token e circa 95 token al secondo, segnala che l'inference...