> DEEPENING :: APPROFONDIMENTI

In-depth technical content for LLM On-Premise deployment: detailed architecture breakdowns, comprehensive hardware analysis, step-by-step implementation guides, and advanced optimization techniques. Long-form articles where we dive deep into the technical details.

[STATUS] 97 deepening articles available | [MODE] Long-form technical documentation
> WHAT_LIVES_HERE

This section collects AI-Radar's original long-form analysis — including the daily 📡 Signal, an in-depth piece generated every morning from the most significant story on the radar, read through the on-premise and local-AI lens: what it changes for hardware choices, deployment economics and data sovereignty. Unlike the news feed, these pieces are analysis-first: a thesis, second-order implications, winners and losers.

For evergreen reference material instead — GPU buying, TCO math, quantization, private-ChatGPT builds — see the guides hub and the observatory decision tools.

> AVAILABLE_DEEPENING_ARTICLES

Comprehensive technical guides ordered by publication date

[DEEPENING] ✓ Published | 2026-10-15 07:35 UTC

AMD W7900 and LFM2.5: A Concrete Signal for On-Premise LLM

AMD W7900 e LFM2.5: il segnale di un on-premise sempre più concreto

La prova di un LLM da 24 miliardi di parametri su AMD W7900, con contesto da 128.000 token e circa 95 token al secondo, segnala che l'inference on-premise si consolida anche fuori dall'ecosistema NVIDIA. L'analisi di AI-Radar esplora trade-off, sovranità dei dati e TCO.

[DEEPENING] ✓ Published | 2026-10-14 07:34 UTC

Mesa brings YOLOX to NPUs: the open driver reshapes local inference

Mesa porta YOLOX su NPU: il driver aperto ridefinisce l'inference locale

Mesa estende il supporto alle NPU e dimostra YOLOX via PyTorch, spostando l'accesso all'accelerazione fuori dai toolchain proprietari. Per edge e on-premise, il driver aperto riduce lock-in e costi di porting, cambiando il calcolo del TCO. AI-Radar legge il segnale strutturale: l'accelerazione AI segue la traiettoria delle GPU, dove il valore si sposta dal semplice accesso hardware all'orchestrazione con framework condivisi e pipeline riproducibili.

[DEEPENING] ✓ Published | 2026-10-13 07:35 UTC

Reverse engineering CUDA with AI: the on-premise lock-in symptom

Reverse engineering CUDA con AI: il sintomo di un lock-in che pesa sull'on-premise

Un post Reddit rilancia l'idea di usare LLM per ricreare CUDA open source e liberare le GPU AMD. Il segnale non è la fattibilità tecnica immediata, ma la tensione strutturale tra controllo dello stack, compatibilità software e TCO nelle infrastrutture self-hosted. Per chi valuta deployment on-premise, il dibattito mostra come la scelta hardware sia inseparabile da ecosistemi, framework e vincoli di migrazione.

[DEEPENING] ✓ Published | 2026-10-12 07:33 UTC

Receipts on-device: the signal for those controlling local inference

Scontrini on-device: il segnale per chi controlla l'inference locale

Un modello da 0,8B che legge scontrini sul telefono mostra l'inference on-device come opzione concreta per documenti personali. Il progetto intreccia fine-tuning su dati donati, output JSON e una valvola self-hosted via server OpenAI-compatibile. Il segnale per chi valuta deployment locali è il trade-off tra memoria, qualità dei dati e TCO, con la sovranità come vincolo e non preferenza.

[DEEPENING] ✓ Published | 2026-10-11 07:32 UTC

Counterfeit RTX 4090s: the hardware gap in self-hosted inference

RTX 4090 contraffatte: la falla hardware dell'inference self-hosted

La circolazione di RTX 4090 contraffatte, quasi indistinguibili all'ispezione visiva e ai primi test software, trasforma l'acquisto di GPU consumer per LLM on-premise in un rischio strutturale. Il danno non si limita alla sostituzione: include instabilità sotto carico, benchmark inaffidabili e TCO più alto. Per chi punta su self-hosted e sovranità dei dati, la provenienza hardware diventa competenza infrastrutturale, non solo logistica.

[DEEPENING] ✓ Published | 2026-10-10 07:34 UTC

GLM 5.3 Flash and Mistral Large 4: the overtake that shifts TCO

GLM 5.3 Flash e Mistral Large 4: il sorpasso che sposta il TCO

Due modelli aperti guidano l'Artificial Analysis Cyber Index e superano ogni singolo modello Anthropic. Il sorpasso non è solo classifica: sposta il calcolo del TCO dai canoni API all'infrastruttura on-premise, riapre il confronto su sovranità dei dati, quantization e gestione delle GPU. AI-RADAR analizza le implicazioni per chi valuta deployment locali, fine-tuning e stack self-hosted, oltre i riflessi su vendor cloud e system integrator.

Il framework Synthesis Through Simulation di SAP genera dati sintetici aziendali facendo operare un agente LLM contro API che applicano policy simulate, senza accedere agli schemi database. La validità strutturale nasce per costruzione, non per estrazione. Per le infrastrutture self-hosted cambia il calcolo di sovranità e TCO: la pipeline locale dalla simulazione al fine-tuning riduce dipendenza da cloud e approvazioni legali, ma sposta il rischio sulla fedeltà dell'ambiente simulato.

[DEEPENING] ✓ Published | 2026-10-08 07:34 UTC

LiteBox: local sandboxing becomes a building block for on-premise AI

LiteBox: il sandbox locale diventa un tassello per l’AI on-premise

Microsoft ha pubblicato il primo rilascio taggato di LiteBox, sandbox in Rust per isolare Linux su Linux e Linux su Windows. Il segnale è la maturità: un isolamento più forte dei container, portabile cross-OS, utile per pipeline LLM self-hosted. Riduce la dipendenza da sandbox cloud e rafforza sovranità. Restano da valutare overhead, superficie d'attacco e integrazione operativa.

[DEEPENING] ✓ Published | 2026-10-07 07:31 UTC

External guidance in LLMs: bias cannot be eliminated, only calibrated

Guida esterna nei LLM: il bias non si elimina, si calibra

Il framework GA-GRPO formalizza la guida esterna nel fine-tuning di LLM reasoning come un operatore che introduce bias misurabile in base alla divergenza tra guida e policy. La teoria mostra che il bias è inevitabile e cresce nel tempo, ma il peso ottimale della guida diminuisce con l'avanzare dell'addestramento. Un test con Qwen2.5-Math-7B su nove benchmark mostra un risparmio del 31% di GPU-ore, con implicazioni dirette per il TCO dei deployment on-premise e self-hosted.

[DEEPENING] ✓ Published | 2026-10-06 07:32 UTC

ROCm 10.1: The Software Cadence Reshaping On-Premise TCO

ROCm 10.1: la cadenza software che riscrive il TCO on-premise

ROCm 10.1 conferma il ciclo di sei settimane di AMD per lo stack GPU. Più delle singole funzionalità, conta la prevedibilità: per i deployment self-hosted riduce il rischio di restare bloccati su versioni vecchie e rende il software parte governabile della pipeline. La maturità dello stack entra nel TCO accanto a VRAM e prestazioni. Restano incognite su compatibilità dei framework, SKU e qualità dei rilasci.

Un task di refactoring su RTX 5070 Ti con Qwen3.8-27B in quantization IQ3_XXS produce una digressione biografica su Lee Kuan Yew nel reasoning. L'episodio mostra come compressione spinta e velocità possano erodere la coerenza interna, rendendo fragile la tracciabilità nei deployment self-hosted. Per i deployment on-premise, l'attenzione si sposta dai token al secondo alla stabilità dei passaggi intermedi, con implicazioni per pipeline agentiche e supervisione.

[DEEPENING] ✓ Published | 2026-10-03 07:32 UTC

Helion in vLLM: GEMM tuning becomes search, not GPU craft

Helion in vLLM: il tuning dei GEMM diventa ricerca, non artigianato GPU

L'integrazione di Helion nel backend lineare di vLLM mostra che un solo kernel GEMM con autotuner ahead-of-time può coprire varianti specializzate e migliorare l'inference fino al 10% su Qwen3. Per chi gestisce LLM self-hosted, il segnale è duplice: si riduce la dipendenza da competenze CUDA profonde, ma si sposta il costo sul tuning offline e sulla governance delle configurazioni.

[DEEPENING] ✓ Published | 2026-10-02 07:32 UTC

BIG-IP Next for Kubernetes: AI Efficiency Shifts from GPU to Network

BIG-IP Next per Kubernetes: l'efficienza AI si sposta dalla GPU alla rete

Il test F5 su BIG-IP Next for Kubernetes mostra che lo stesso cluster GPU può rendere più del triplo agendo su bilanciamento e instradamento del traffico. Per i deployment on-premise l'efficienza per nodo diventa centrale per il TCO; il rischio è legare l'ottimizzazione a uno stack proprietario. AI-RADAR analizza le implicazioni per chi valuta infrastrutture locali, tra capacità inutilizzata e dipendenza tecnica.

[DEEPENING] ✓ Published | 2026-09-30 07:32 UTC

Fine-tuning beyond text: DASA turns gradients into the dataset

Fine-tuning oltre il testo: DASA trasforma il gradiente nel dataset

DASA genera embedding sintetici dai gradienti di attivazione di un modello congelato, addestrando LLM senza passare da testo leggibile. I test su Llama e Qwen mostrano prestazioni simili o superiori ai dati testuali, con speedup fino a 4,9 volte rispetto a GRADMM. Per i deployment self-hosted cambia l'equilibrio tra cura dei dati, calcolo, portabilità e audit.

[DEEPENING] ✓ Published | 2026-09-29 07:34 UTC

Nemotron 3: Value Shifts from Weights to Inference Orchestration

Nemotron 3: il valore si sposta dai pesi all'orchestrazione dell'inference

Il punteggio di Nemotron 3 alle IOI 2026 non segna solo un primato. Il risultato dichiarato si spiega con GenCorrect, un loop di test-time compute che moltiplica i token per query. Per i deployment on-premise, i pesi aperti e la quantization NVFP4 abbassano la barriera hardware, ma il costo operativo si sposta su VRAM, throughput e TCO. L'analisi di AI-RADAR: perché conta e quali trade-off valutare.

[DEEPENING] ✓ Published | 2026-09-28 07:33 UTC

Nvidia pushes personal AI computers: on-premise computing changes scale

Nvidia spinge i personal AI computer: l'on-premise diventa un formato

La spinta di Nvidia sui personal AI computer segnala un cambio di baricentro: l'inference LLM si avvicina al dispositivo locale. Non è solo hardware consumer, ma un nodo on-premise in miniatura che tocca VRAM, quantization, TCO e sovranità dei dati. Per i team IT si apre una terza via tra cloud e data center: occorre valutare carichi stabili, vincoli di memoria e complessità operativa.

Qwengram-0.8B congela Qwen3.5-0.8B e aggiunge una memoria n-gram da 51 miliardi di parametri fuori dal GGUF. La perplexity scende del 5,05%, ma il dato rilevante è l'architettura: iniezione tardiva governata da una gate per token, sidecar quantizzato Q8_0 e nessun fine-tuning del backbone. Per chi gestisce LLM locali, il segnale è la separazione tra pesi e conoscenza: aggiornare la memoria senza toccare il modello apre scenari nuovi, ma impone vincoli severi ai runtime.

[DEEPENING] ✓ Published | 2026-09-25 07:31 UTC

Safety, ad hominem, and local control: the real cost of tamed LLMs

Sicurezza, ad hominem e controllo locale: il vero costo degli LLM addomesticati

Il fine-tuning di sicurezza non è neutro: riduce lo spazio strategico degli LLM nei dibattiti reali. Per i deployment on-premise conta il controllo dei pesi, delle pipeline e del TCO. L'analisi AI-Radar mette a fuoco il trade-off tra modelli pronti via API e sistemi self-hosted capaci di ridefinire il comportamento conversazionale.

L'avvio del supporto GDDR7 nei driver Linux di AMD segnala un cambiamento per chi gestisce infrastrutture AI on-premise. La notizia, apparentemente tecnica, anticipa l'importanza della banda di memoria per l'inference LLM e riduce l'attrito di integrazione per ambienti self-hosted. Un segnale da leggere in ottica TCO e sovranità dei dati, più che come annuncio di prodotto.

[DEEPENING] ✓ Published | 2026-09-22 07:32 UTC

AliceAI 80B: Custom Architecture and the Runtime Bottleneck

AliceAI 80B: architettura custom e il nodo dei runtime

Yandex ha pubblicato un base model da 80 miliardi di parametri con architettura custom e componente attiva ridotta. Non è una fine-tune di Qwen3 e non ha supporto in Llama.cpp: un doppio segnale. AI-RADAR analizza le implicazioni per chi valuta deployment on-premise: maturità dell'ecosistema di inference, costo di porting, proliferazione di architetture. Non è un modello plug-and-play, ma un indicatore di direzione tecnica.

[DEEPENING] ✓ Published | 2026-09-21 07:33 UTC

BI-Bench and BI-Agent: the real gap is in data orchestration

BI-Bench e BI-Agent: il vero divario è nell'orchestrazione dei dati

La BI end-to-end rivela un limite strutturale dei LLM: sotto il 50% di accuratezza senza guida umana. Il guadagno vero arriva da architetture che orchestrano strumenti e da post-training su dati proprietari. Per chi valuta on-premise e self-hosted, il TCO si sposta verso GPU, metadati e pipeline, non verso il costo per token.

Von, un LLM open source da 395 milioni di parametri, gira interamente su CPU con 1-2 GB di memoria e latenze dichiarate tra 25 e 300 ms. Presentato su Reddit come sostituto di JEV, senza ottimizzazione iniziale, riapre il confronto su deployment locali senza GPU. Per AI-RADAR il segnale non è il benchmark, ma il costo di verifica indipendente e la possibilità di self-hosted dentro il perimetro aziendale.

MDT trasforma la divergenza tra volto, voce e testo nel segnale centrale dell'analisi clinica, raggiungendo 0,7408 Macro F1 sul test BAH e addestrandosi in meno di venti minuti su singola GPU. Per AI-Radar il dato chiave è operativo: un modello che codifica il conflitto con token espliciti sposta l'attenzione su pipeline parallele, VRAM e TCO, rendendo più concreta l'elaborazione locale dei video sensibili.

Un esperimento con un LLM da 27 miliardi di parametri in quantization a 4 bit su una RTX 3090, per 63 ore, non risolve Riemann ma mostra la tenuta di pipeline agentiche self-hosted. Il valore non è il teorema: è la stabilità di processo, la gestione della memoria e l'ownership dei dati. AI-Radar analizza implicazioni per infrastruttura locale, valutazione e orchestrazione.

[DEEPENING] ✓ Published | 2026-09-16 07:32 UTC

KV cache: the new frontier of on-premise LLM infrastructure

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria e il movimento dei dati diventano criteri di scelta non più secondari.

[DEEPENING] ✓ Published | 2026-09-14 07:33 UTC

The right to local AI, safety, and the push toward centralization

Il diritto all'AI locale, la sicurezza e la spinta alla centralizzazione

La rivendicazione del diritto di eseguire AI in locale, emersa in un dibattito sulla sicurezza, segnala una frattura profonda tra controllo distribuito e centralizzazione. Le restrizioni sui modelli aperti rischiano di colpire il self-hosted, la sovranità dei dati e l’hardware per l’inference on-premise, spostando il mercato verso API proprietarie e cloud. L’analisi esplora incentivi, effetti di secondo ordine e TCO, senza ridurre la sicurezza a un pretesto.

Un ricercatore indipendente ha preparato un modello denso da 9,4 miliardi di parametri per il training su una singola scheda, con distillazione da Llama 3 e semplificazioni architetturali. Non ci sono benchmark, ma il segnale per l'AI on-premise è chiaro: il collo di bottiglia non è più l'hardware, ma dati, iterazione e comunità. Il progetto Budget mostra che la barriera per l'addestramento locale è scesa.

[DEEPENING] ✓ Published | 2026-09-12 07:32 UTC

Personality in prompts, not weights: the new on-premise frontier

Personalità nel prompt, non nei pesi: il nuovo confine dell'on-premise

Un metodo in tre passaggi mostra come ottenere chatbot 'umani' senza fine-tuning: biografia, voce, istruzioni operative. Per i deployment on-premise il segnale è duplice: meno pressione sul training, ma più fragilità e rischi di audit. Il costo si sposta dall'addestramento all'inference, mentre la governance del testo diventa parte dell'infrastruttura. La partita si gioca sempre più sulla scrittura dei prompt, non sui pesi.

Nel BabyLM 2026 Strict-Small, Qiushi Engine ha guadagnato 0,23 punti Overall su nove metriche senza aumentare la scala, ma riorganizzando l'esperienza attorno alle dipendenze contestuali. Per chi valuta LLM self-hosted, il segnale è il principio di efficienza dei dati: sposta parte del costo da hardware e VRAM a progettazione del corpus e supervisione.

[DEEPENING] ✓ Published | 2026-09-10 07:33 UTC

Enflame completes China's GPU landscape: capital is not enough

Enflame e il completamento del framework GPU cinese: il capitale non basta

La quotazione di Enflame chiude il ciclo delle quattro IPO dei produttori GPU cinesi. Il segnale finanziario è chiaro: Pechino considera i chip per AI una priorità strategica. Ma il capitale raccolto non sana da solo il divario di ecosistema software, VRAM, bandwidth e compatibilità con pipeline di fine-tuning e inference. Per infrastrutture self-hosted e on-premise, la vera partita si gioca su driver, strumenti e maturità operativa.

[DEEPENING] ✓ Published | 2026-09-09 07:34 UTC

SEMIFIVE on Samsung 4nm: the first industrial stress test for LLM ASICs

SEMIFIVE sul 4nm di Samsung: il primo stress test industriale degli ASIC per LLM

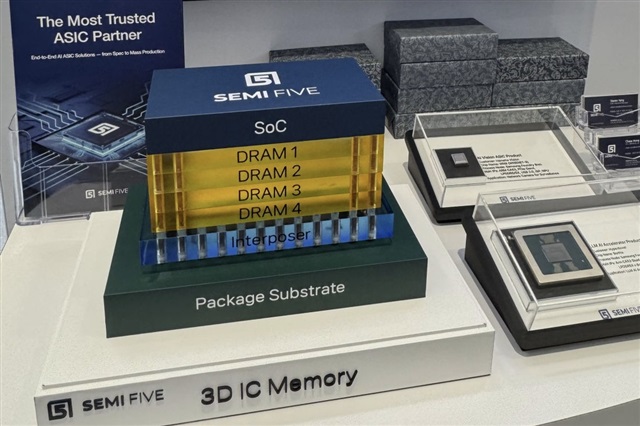
La produzione degli HyperAccel sul nodo a 4nm di Samsung segnala il passaggio degli acceleratori dedicati ai LLM da sperimentazione a logica industriale. La capacità limitata introduce pressioni su consegne e allocazione dei wafer. Per i deployment self-hosted, gli ASIC promettono TCO più basso su carichi stabili, ma vincolano l'hardware a modelli e schemi di quantization poco flessibili. Il trade-off va valutato oltre il costo di acquisto.

L’ingresso di Cambricon come membro Platinum della PyTorch Foundation segnala un cambio di fase: controllare lo stack software open source conta quanto la potenza dei chip. Per chi valuta LLM self-hosted, il supporto nativo di backend diversi riduce dipendenza da CUDA, manutenzione e TCO. Restano da verificare continuità e maturità dei contributi upstream.

[DEEPENING] ✓ Published | 2026-09-07 07:32 UTC

Astra and open source LLMs: the real gap is orchestration

Astra e LLM open source: il divario vero è nell’orchestrazione

Un post su Reddit chiede quando i LLM open source raggiungeranno Astra. Il segnale non riguarda i pesi del modello, ma l'infrastruttura: pipeline multimodale, runtime di inference, memoria e orchestrazione. Per chi valuta stack on-premise, il divario si traduce in trade-off tra controllo, latenza e TCO. L'open source può competere su compiti specifici, ma l'esperienza integrata richiede investimenti coordinati. AI-Radar analizza le implicazioni per deployment locali e sovranità dei dati.

[DEEPENING] ✓ Published | 2026-09-06 07:32 UTC

Open Source and Frontier Labs: When Perceived Parity Shifts the Market

Open source e laboratori di frontiera: quando la parità percepita sposta il mercato

La percezione di parità tra modelli open source e laboratori di frontiera, emersa in un dominio critico, sposta la competizione dalla qualità tecnica a costi e governance. Chi gestisce dati sensibili guarda al self-hosted come opzione concreta: TCO, latenza e controllo superano il punteggio dei benchmark. Il segnale indica pressione sui token, domanda di hardware per inference locale e un premio fragile per le API chiuse.

[DEEPENING] ✓ Published | 2026-09-05 07:33 UTC

Tencent Hy4 on llama.cpp: local inference shifts its center of gravity

Tencent Hy4 su llama.cpp: il segnale per l'inference locale

La pull request #28127 per integrare Hy4-preview in llama.cpp non porta benchmark, ma segnala la convergenza dell'ecosistema self-hosted. Anche i vendor cloud mostrano attenzione alle pipeline on-premise. Restano da verificare stabilità, licenze e documentazione: il valore reale si misurerà su costi operativi, efficienza e vincoli di sovranità.

[DEEPENING] ✓ Published | 2026-09-04 07:32 UTC

Nvidia-Hugging Face: AI control moves through payments and talent

Nvidia-Hugging Face: il controllo dell'AI passa da pagamenti e talenti

L'accordo tra Nvidia e Hugging Face segnala che il controllo dell'ecosistema LLM passa anche da clausole finanziarie. Pagare i concorrenti nel silicio e vincolare un miliardo di dollari al personale incide su neutralità delle piattaforme, costo del talento e dipendenze per chi valuta stack self-hosted e on-premise. Un segnale da monitorare accanto a VRAM, inference e TCO.

La ricerca di ServiceNow mostra che i profili comportamentali estratti da interazioni reali offrono una personalizzazione più aderente rispetto alle personas sintetiche. Il metodo combina fine-tuning supervisionato e ragionamento multi-prospettiva, spostando l'attenzione dai template identitari ai segnali osservati. Per chi gestisce LLM self-hosted, il passaggio impone pipeline di pulizia, anonimizzazione e governance più articolate, con costi infrastrutturali ma anche un vantaggio competitivo legato alla sovranità dei dati.

La compressione post-training non è una trasformazione neutra. Un paper mostra classi di equivalenza comportamentale che collassano parametri diversi e aprono backdoor attivate solo dopo quantization INT8 o 4 bit. I test su modelli multilingua segnalano fino all'85,02% di inversione friend-foe e ΔBias=0,33. Per deployment on-premise e air-gapped, l'audit del solo checkpoint sorgente non basta: va certificata ogni coppia modello-compressione e ogni percorso di produzione.

[DEEPENING] ✓ Published | 2026-08-30 07:33 UTC

The runtime lever that puts a 27B LLM and 100k tokens on 16 GB

La leva runtime che porta un LLM da 27B a 100k token su 16 GB

Un setup su Reddit mostra un modello dense da 27 miliardi di parametri a 47-50 token/s con contesto da 100.000 token su una RTX 4070 Ti SUPER da 16 GB. Il segnale non è il modello, ma il controllo fine del runtime: cache KV asimmetrica kvarn5/kvarn4, coda di 1.024 token a piena precisione e decodifica speculativa. Sposta il vincolo dalla VRAM al software di serving, con implicazioni per TCO e sovranità dei dati.

[DEEPENING] ✓ Published | 2026-08-29 07:32 UTC

HP Z4 G6i: Price Is Only the Surface of the Linux-Ready Signal

HP Z4 G6i: il prezzo è solo la superficie del segnale Linux-ready

La workstation HP Z4 G6i unisce Xeon serie 600, grafica RTX e supporto Linux dichiarato, ma la configurazione top supera i 41mila dollari. Il segnale per AI-Radar non è la potenza assoluta: è la legittimazione delle macchine da lavoro come nodi on-premise per LLM, inference locale e fine-tuning su dati sensibili. Restano da verificare GPU, VRAM e gestione operativa, variabili decisive per valutarne il TCO e l'uso reale.

[DEEPENING] ✓ Published | 2026-08-28 07:32 UTC

Nvidia-Hugging Face: The Model Node Becomes a Hardware Asset

Nvidia-Hugging Face: il nodo dei modelli diventa un asset hardware

L’eventuale acquisizione di Hugging Face da parte di Nvidia va letta come presa di controllo su un punto di passaggio per modelli, pesi e pipeline. Per i deployment on-premise e self-hosted cambia il piano di distribuzione: neutralità, accesso e sovranità tecnica diventano variabili industriali. AI-Radar analizza implicazioni e segnali da monitorare.

[DEEPENING] ✓ Published | 2026-08-27 07:33 UTC

GreenLeaf Law Embed Tiny and the Local Turn in Legal Retrieval

GreenLeaf Law Embed Tiny, il retrieval giuridico si fa locale

Un embedding giuridico da 0,6 miliardi di parametri mostra che distillazione, hard negative mining e quantization binaria possono spostare il retrieval legale verso deployment self-hosted. Il dato strutturale non è solo il benchmark, ma la possibilità di servire ricerca giuridica su hardware locale con TCO ridotto, dati nel perimetro e dataset specializzato come vero fossato. Restano aperti i limiti per l'uso ad alto rischio.

[DEEPENING] ✓ Published | 2026-08-26 07:33 UTC

Qwen3.8-27B Drops to 19.7 GB: What Changes for On-Prem LLM

Qwen3.8-27B scende a 19,7 GB: cosa cambia per l'on-premise

Un checkpoint Qwen3.8-27B in NVFP4 mostra che la quantization W4A4 guidata da distillation può portare un LLM da 27 miliardi di parametri sotto i 20 GB senza perdite rilevanti. L'analisi AI-Radar legge il risultato come un cambio di soglia per VRAM e TCO, ma anche come un vincolo hardware NVIDIA Blackwell e uno spostamento del costo di precisione verso il training.

[DEEPENING] ✓ Published | 2026-08-25 07:33 UTC

ToMoE and Dynamic Sparsity: Less Compute for Local LLMs

ToMoE e la sparsità dinamica: meno calcolo per gli LLM locali

ToMoE converte checkpoint densi in MoE senza fine-tuning, riducendo i parametri attivi per token ma non il footprint in memoria. Un cambio di logica per l'on-premise: meno calcolo, stesso modello. Restano aperti i nodi runtime, latenza e VRAM. Il segnale per chi gestisce LLM locali è la sparsità dinamica come leva di deployment.

[DEEPENING] ✓ Published | 2026-08-23 07:34 UTC

After Qwen 3.8 27B: silence shifts TCO toward on-premise

Dopo Qwen 3.8 27B: il silenzio che sposta il TCO verso il locale

Il silenzio dei vendor chiusi dopo Qwen 3.8 27B segnala un cambio di pressione competitiva: la retorica della sicurezza si affievolisce quando un LLM da 27B può girare in locale con 16 GB di VRAM. La barriera hardware scende, il TCO si sposta dal costo per token ai costi di gestione e l'on-premise diventa opzione di produzione. AI-RADAR analizza implicazioni per governance, hardware e regolamentazione.

[DEEPENING] ✓ Published | 2026-08-20 07:33 UTC

Depth pruning on Qwen3.8-27B: lightness is not free

Depth pruning su Qwen3.8-27B: la leggerezza non è gratuita

Uno sviluppatore ha ridotto Qwen3.8-27B a 22,7 miliardi di parametri con pruning di profondità, senza fine-tuning. Distribuito solo in MLX per Apple Silicon, mostra trade-off: meno pressione su memoria e calcolo, ma perdite nei casi limite. Per l'on-premise il costo si sposta dalla produzione alla validazione.

[DEEPENING] ✓ Published | 2026-08-19 07:33 UTC

DFlash 2 via llama.cpp: quantized distribution is the real signal

DFlash 2 via llama.cpp: la distribuzione dei quantizzati è il segnale

La seconda versione di DFlash non arriva con un annuncio ma con la PR 27342 su llama.cpp e i quantizzati GGUF già pronti per Qwen 3.8 27B e Muse Glimmer. AI-Radar analizza il cambio di baricentro: il vero collo di bottiglia dell'on-premise non è il modello ma la disponibilità immediata di artefatti verificabili. Il trade-off tra sperimentazione rapida e governance del ciclo di vita software definisce il prossimo test di maturità per lo stack locale.

FPO propone un fine-tuning dei LLM che non propaga errori tra i layer e non costruisce grafi autograd. Il metodo riduce il picco di memoria e accelera il throughput, ma concentra l'adattamento nei layer finali. Per chi gestisce modelli self-hosted, il guadagno operativo è reale: va però verificato con una diagnosi rapida, altrimenti il vantaggio si trasforma in un vincolo architetturale.

[DEEPENING] ✓ Published | 2026-08-17 07:32 UTC

Benchmarks as Targets: Ranking Distortion and On-Premise Risks

Il benchmark come obiettivo: distorsione dei ranking e rischi per l'on-premise

Il fine-tuning su SWE-bench non trasferisce capacità a suite come Django o LiveCodeBench. Il benchmark diventa obiettivo di addestramento e smette di misurare capacità generale. Per chi gestisce LLM self-hosted, un punteggio gonfiato falsa il calcolo di VRAM, quantization e TCO. Serve una valutazione multi-task e una manutenzione continua dei benchmark, non un numero singolo.

[DEEPENING] ✓ Published | 2026-08-16 07:33 UTC

Qwen3.8-27B: closing the visual loop shifts on-premise value

Qwen3.8-27B: la chiusura del loop visivo sposta il valore on-premise

Un confronto amatoriale tra Qwen3.6-27B e Qwen3.8-27B su un ray tracer in BASIC mostra una differenza decisiva: la capacità di osservare il rendering e correggere il codice in autonomia. Con quantization spinta e hardware locale, il ciclo chiuso riduce la supervisione umana e sposta la valutazione dagli LLM one-shot agli agenti multi-turno.

[DEEPENING] ✓ Published | 2026-08-15 07:32 UTC

Lemonade 11.6: The Signal Is in the Runtime, Not the Model

Lemonade 11.6: il segnale è nel runtime, non nel modello

AMD aggiorna Lemonade SDK con Muse-Glimmer 30B e modulo sperimentale ROCm per generazione immagini. Più che una novità di benchmark, è un segnale per chi valuta LLM locali: il valore si sposta su ottimizzazione di CPU, GPU e NPU, prevedibilità dei costi e controllo dei dati. La release estende i carichi supportati su hardware AMD e abbassa la soglia per deployment self-hosted, pur lasciando aperti integrazione, driver e aggiornamenti.

L'esperimento di physicsrob compila l'algoritmo di rendering di Doom nei pesi di un trasformatore Phi-3. Nessun addestramento: ogni peso è calcolato. Il risultato è deterministico e verificabile, ma restano 34–86 GB in fp32, nessuna quantization e inferenze nell'ordine dei 40 minuti per frame su GPU B200. Per AI-Radar il segnale è soprattutto infrastrutturale: il checkpoint è auditabile, ma il requisito di VRAM ne limita il deployment on-premise reale.

[DEEPENING] ✓ Published | 2026-08-13 07:33 UTC

RTX PRO 6000 at $16,000: on-premise compute is no longer discounted

RTX PRO 6000 a 16.000 dollari: il calcolo on-premise non è più scontato

Il raddoppio del prezzo di listino della RTX PRO 6000 Blackwell, da meno di 8.000 a 16.000 dollari, segnala una domanda enterprise anelastica e un potere di prezzo che ridisegna i calcoli TCO per l'on-premise. La scheda da 96 GB di VRAM diventa un filtro: cloud, sovranità dei dati e accesso degli sviluppatori cambiano. Servono scenari, non budget basati sui vecchi listini.

LLM Agents Factory offre una via pragmatica alla gestione degli agenti: invece di generarli a ogni richiesta, li recupera da un archivio strutturato. Questo riduce i costi di inference, la latenza e la pressione sulle GPU, con implicazioni dirette per chi sviluppa e mantiene stack on-premise. La stabilità e la prevedibilità dei profili agentivi diventano un vantaggio strategico, aprendo scenari di mercato per componenti standardizzati.

[DEEPENING] ✓ Published | 2026-08-11 07:32 UTC

$200 enough to train a 1B LLM: data sovereignty stops being a luxury

200 dollari bastano per addestrare un LLM da 1B: la sovranità dei dati smette di essere un lusso

Un esperimento dimostra che con 200 dollari su GPU noleggiate si può addestrare un LLM da 1,1 miliardi di parametri e distribuirlo su CPU o persino smartwatch. Il costo irrisorio riscrive il calcolo del TCO per le aziende che valutano soluzioni self-hosted: la sovranità dei dati diventa una scelta progettuale concreta, non un lusso per pochi. Restano limiti di qualità e contesto, ma la commoditizzazione del training sposta il valore dalla potenza bruta alla capacità di orchestrare pipeline e deployment.

Un utente ha fatto generare a DeepSeek un kernel Metal per eseguire Kimi K2 quantizzato su Mac Studio, ottenendo modeste prestazioni ma dimostrando che gli LLM possono colmare lacune software per l’inference self-hosted su hardware non-Nvidia. Il caso ridefinisce il calcolo del TCO a favore dell’hardware esistente e solleva interrogativi sulla robustezza del codice autogenerato. È un segnale di autonomia computazionale che si autoalimenta, con rischi e opportunità per le aziende che puntano all’on-premise.

Una manciata di righe di codice in llama.cpp moltiplica fino a 2,7 volte le prestazioni delle GPU Intel Battlemage su contesti di 118.000 token quando la cache KV è quantizzata. Il guadagno è talmente netto da trasformare una scheda da gaming in un’alternativa concreta per l’inference locale di modelli da 35 miliardi di parametri, abbattendo il costo totale di possesso e aprendo scenari inediti per chi gestisce dati sensibili on-premise.

[DEEPENING] ✓ Published | 2026-08-07 07:33 UTC

NVIDIA's local speech stack: implications for on-premise AI

Stack vocale NVIDIA in locale: implicazioni per l'AI on-premise

L'analisi esamina come il rilascio dello stack vocale NVIDIA (ASR, TTS, codec) ottimizzato per esecuzione locale tramite GGUF e NeMo-Speech.cpp ridefinisca il calcolo del TCO, la sovranità dei dati e le architetture on-premise. Il passaggio dal cloud al device sposta gli equilibri nel make-or-buy dei servizi vocali, abilita scenari regolamentati e prepara il terreno per agenti multimodali completamente locali.

Denial integra Flutter direttamente in un compositor Rust per Wayland, riducendo latenza, carico di memoria e strati software. Per i carichi di lavoro on-premise che affiancano LLM self-hosted su dispositivi edge, questa co-ubicazione non è solo una curiosità ingegneristica, ma un segnale di come l’infrastruttura locale stia ripensando anche l’ultimo miglio dell’interfaccia utente, con ricadute concrete su TCO, sicurezza e sovranità dei dati.

[DEEPENING] ✓ Published | 2026-08-05 07:32 UTC

Maple-Preview and Ternary Inference: The On-Premise Threshold Lowers

Maple-Preview e l’inference ternaria: la soglia on-premise si abbassa

Maple-Preview porta i pesi ternari su 20 miliardi di parametri, occupando solo 5 GB e attivando 1 miliardo di parametri per token con un design MoE-like. La preview apre a inference locale su GPU consumer, ma il supporto dei framework è ancora acerbo. AI-Radar analizza le implicazioni per il TCO, la sovranità dei dati e il deployment self-hosted, mettendo in guardia sul gap software e sui vincoli dei kernel ternari.

[DEEPENING] ✓ Published | 2026-08-04 07:32 UTC

RTX 5090 over $5,100: The true cost of on-premise AI

RTX 5090 oltre 5.100 dollari: quanto costa davvero l’AI on-premise

I prezzi della RTX 5090 salgono alle stelle e rimettono in discussione la sostenibilità del deployment on-premise. L’analisi di AI-RADAR esplora le ripercussioni sul TCO, la sovranità dei dati e l’intera catena di approvvigionamento, mostrando come l’aumento dei costi dell’hardware stia spingendo verso quantization aggressiva, modelli distilati e un possibile ritorno al cloud, con vincitori e vinti lungo il percorso.

[DEEPENING] ✓ Published | 2026-08-03 07:33 UTC

LLMs for Data Preprocessing: Why On-Premise Becomes Inevitable

LLM per il preprocessing dei dati: perché l’on-premise diventa inevitabile

Una ricerca su GMM e LLM per il clustering su dati sbilanciati mostra che la generazione di documenti sintetici non è più solo per l’addestramento nel cloud. Quando i dati sono sensibili (sanità, finanza, legale), l’augmentation deve restare on-premise, spingendo la domanda di GPU locali per task batch e ridefinendo i confini tra modelli applicativi e pipeline del dato. Per i decisori, si aprono nuovi trade-off su TCO, sovranità e hardware.

Le ottimizzazioni di KWin sulla gestione di più GPU in KDE Plasma 6.8 non sono una semplice miglioria grafica: abbattono la frizione tra rendering desktop e carichi di inference locali, rendendo le workstation Linux un ambiente più efficiente e diretto per chi sviluppa LLM on-premise. Il segnale è la convergenza tra il layer di interazione umana e l’infrastruttura di calcolo, con benefici concreti su TCO, latenza e utilizzo della VRAM.

[DEEPENING] ✓ Published | 2026-08-01 07:33 UTC

Unsloth brings Deepseek V4 local: the missing signal for on-prem AI

Unsloth porta Deepseek V4 in locale: il segnale che mancava per l’AI on-premise

Unsloth ha rilasciato i file GGUF per Deepseek V4, abilitando l’inference self-hosted su hardware consumer via llama.cpp e Ollama. La mossa ribalta il calcolo del TCO e la sovranità dei dati: l’AI on-premise diventa una scelta di design. AI-Radar analizza le implicazioni di sistema, dalla riduzione dei vincoli hardware alla frammentazione del cloud e i segnali per chi costruisce infrastrutture locali.

thinkingmachines ha rilasciato Inkling-Small, un LLM a mistura di esperti con 276 miliardi di parametri e soli 12 miliardi attivi, finestra di contesto da 1 milione di token e quantizzazioni NVFP4 e GGUF. L'analisi AI-RADAR mette a fuoco il nodo nascosto della KV cache e le implicazioni per deployment on-premise, TCO e sovranità dei dati.

AMD e Anthropic stanno costruendo una fabbrica AI su larga scala che rinuncia a CUDA. L’ecosistema ROCm diventa un’alternativa concreta per l’inference e il fine-tuning di modelli multi-trilione di parametri. Per le aziende che puntano al self-hosted degli LLM, questa mossa introduce un secondo fornitore credibile, riducendo la dipendenza da NVIDIA e potenzialmente il TCO. L’analisi approfondisce l’impatto su hardware, software, ricerca e strategie di deployment on-premise.

La virata della Cina verso ecosistemi open source per l’AI generativa è più di una scelta tecnica: è un adattamento forzato dai vincoli hardware e dalle dottrine di sicurezza, che trasforma il paese in un banco di prova avanzato per il deployment on-premise di LLM. L’analisi esplora perché questo passaggio ridisegna gli equilibri dell’infrastruttura AI globale e quali segnali offre a chi cerca sovranità sui dati e controllo del TCO.

La violazione dell’account OpenAI su Hugging Face ha esposto il tallone d’Achille dell’allineamento: una volta in possesso dei pesi, un avversario può cancellare le barriere di sicurezza con fine-tuning malevolo. L’unica vera difesa è il contenimento materiale dei modelli tramite infrastrutture on-premise, confidenzial computing e procedure di attestazione hardware. Per chi gestisce dati regolati, il costo del self-hosted diventa un investimento obbligato per salvaguardare anni di lavoro sull’allineamento.

[DEEPENING] ✓ Published | 2026-07-26 07:33 UTC

What do you actually do with small LLMs? The on-premise signal

Cosa ci fate davvero con i piccoli LLM? Il segnale per l’on-premise

La domanda comparsa su Reddit – «Cosa ci fate con i modelli piccoli?» – svela un riassetto dell’infrastruttura AI lontano dai data center. AI-Radar analizza i quattro scenari d’uso reali, il ruolo decisivo della VRAM, del TCO e dei framework locali, e come la sovranità dei dati stia ridefinendo il mercato hardware e software enterprise.

Un nuovo paper introduce la quantization “statisticamente senza perdita” (SLQ), che garantisce la qualità dell’output in termini probabilistici senza sacrificare la velocità. Definisce tre livelli di fedeltà e mostra che già sotto i 4 bit si preserva l’accuratezza dei benchmark, mentre a 5-6 bit la distribuzione dei token è indistinguibile dall’originale. L’impatto sull’infrastruttura on-premise è immediato: meno VRAM, meno energia, più modelli sulla stessa macchina. La ricerca segnala un passaggio dal “quanto comprimo” al “quale garanzia statistica serve”, ridefinendo il costo reale dell’inference locale.

Uno studio su DeepSeek mostra che i LLM valutano la scrittura premiando struttura e voce, non il lessico. Questo ha implicazioni profonde per chi fa inference locale: quantization aggressiva, scelta dell'hardware e fine-tuning devono tenere conto della sensibilità alle dipendenze a lungo raggio, riaprendo il confronto su TCO e sovranità dei dati.

[DEEPENING] ✓ Published | 2026-07-23 07:33 UTC

The specter of sanctions on open source AI: why on-premise trembles

Lo spettro delle sanzioni sull’open source AI: perché l’on-premise trema

Limiti all’export sui modelli open weight potrebbero minare la sovranità dei dati, spingendo le aziende che hanno investito in stack on-premise verso le API cloud centralizzate. La segmentazione dell’ecosistema minaccia l’innovazione aperta e avvantaggia i gatekeeper. Servono meccanismi di governance basati su tracciabilità, non su divieti a priori, per evitare un danno alla distribuzione locale dei carichi di lavoro AI. Ecco i segnali da tenere d’occhio.

La quantization di Laguna S 2.1 a opera di Unsloth abbassa la barriera hardware per l’inference locale, rendendo un modello potente eseguibile su GPU consumer. Questo passo rafforza l’AI on-premise, riduce la dipendenza dal cloud, protegge i dati e abbassa il costo marginale dell’inference. Per le organizzazioni che puntano alla sovranità digitale, ogni compressione efficace allarga lo spazio delle scelte concrete, erodendo il vantaggio dei fornitori cloud.

La chiusura dei modelli di frontiera americani non frena l’adozione dell’AI, ma la sposta su stack self-hosted. Aziende e istituzioni scelgono controllo, costi prevedibili e indipendenza dalle API. L’analisi AI-RADAR esplora come questo riequilibrio infrastrutturale stia ridefinendo hardware, framework e competenze, trasformando l’on-premise da eccezione a standard per chi tratta dati sensibili o opera a volumi elevati.

[DEEPENING] ✓ Published | 2026-07-15 07:32 UTC

PSMC hikes DRAM prices by 45%: the hidden cost for on-premise AI

PSMC alza i prezzi DRAM del 45%: il conto salato per l’AI on-premise

Il rincaro del 45% sulle DRAM imposto da PSMC non è un episodio isolato: è il sintomo di una tensione strutturale che la domanda di AI sta scaricando sulla filiera delle memorie. Per chi ospita LLM on-premise l’impatto è diretto sul TCO, mentre il nuovo progetto 3D AI Foundry promette soluzioni integrate ma solo sul medio termine. L’analisi delle implicazioni immediate e delle strategie per assorbire lo shock.

L’autorità canadese rompe un tabù citando esplicitamente Claude di Anthropic in un alert alle banche. Non è più questione di ‘tecnicie emergenti’: la finestra per proteggersi si sta chiudendo, e la sovranità dei dati diventa l’unico argine. L’on-premise accelera, e con lui tutto l’ecosistema hardware e dei framework di serving.

[DEEPENING] ✓ Published | 2026-07-13 07:33 UTC

Flash-MSA brings million-token training on-premise

Flash-MSA: il training su un milione di token sbarca on-premise

Flash-MSA introduce kernel di attention sparsa che riducono drasticamente calcolo e memoria per l’addestramento di LLM su contesti fino a un milione di token. Per i deploy on-premise ciò significa poter addestrare modelli specializzati su dati interni con poche GPU server, abbassando il TCO e rafforzando la sovranità dei dati. L’analisi di AI-Radar esplora le implicazioni per l’hardware, il fine-tuning verticale, la filiera dei chip e la competitività delle organizzazioni che scelgono di non dipendere dal cloud.

Una patch di tre linee per llama.cpp corregge un errore di precisione che affliggeva da anni le GPU Tesla P100, migliorando la fedeltà dei calcoli di oltre 2000 volte senza impatto prestazionale. La scoperta ridisegna il rapporto costo-efficacia di queste schede da 80 dollari per l’inference on-premise, solleva interrogativi sulla verifica dell’aritmetica a basso livello nei framework open-source e rafforza il legame tra controllo dello stack e qualità del modello.

Un test con un Qwen3.6 35B-A3B mostra che la quantization a 8 bit su CPU produce codice HTML complesso migliore della versione a 4 bit su GPU, nonostante la lentezza. L’esperimento accende un riflettore sul trade-off qualità-velocità, sul ruolo delle architetture MoE e sulla possibilità di usare server CPU ad alta densità di RAM per inference on-premise di LLM. Un segnale per chi cerca sovranità dei dati senza rinunciare alla fedeltà dell’output.

Meta starebbe preparando un’alternativa open source a Muse Spark, il coding assistant di Anthropic. La conferma del CEO di Scale AI aggiunge peso a una mossa che potrebbe ridefinire lo sviluppo software aziendale: deployment self-hosted, fine-tuning su codebase private e controllo totale del codice. Senza dettagli tecnici, l’annuncio è già un indicatore di direzione per chi guarda a LLM on-premise e sovranità dei dati. L’analisi esplora implicazioni deep-dive per infrastrutture locali, TCO e licenze aperte.

La cronica indisponibilità della scheda Nvidia H20, versione depotenziata per aggirare i controlli Usa, sta spingendo i buyer cinesi verso chipmaker locali come Biren e Cambricon. Più che una scelta tecnica, è una corsa alla sovranità dei dati e alla continuità operativa. L’analisi esplora i trade-off tra ecosistema software maturo e dipendenza geopolitica, il peso del divario con CUDA e le implicazioni per chi gestisce deployment on-premise di LLM, offrendo chiavi di lettura su un mercato AI che si avvia a una profonda biforcazione.

Horus Hiero è un LLM open source per tradurre geroglifici, disponibile in versione 9B e una Mini 4B ottimizzata per CPU e mobile. Supporta 150 lingue, input multimodale e una finestra di contesto fino a 1M token, permettendo l'inference on-premise a basso TCO. Rende l'analisi dei testi antichi autonoma sul campo, senza cloud, un passo concreto verso la sovranità dei dati culturali.

Un report da Reddit mostra come Qwen 3.6 27B, eseguito su singola RTX 6000 con llama.cpp, perda coerenza dopo quattro turni in task agentici, mentre il più grande Qwen 3.5 122B rimane stabile. Il caso svela una tensione critica nei deployment self-hosted: la creatività nel singolo prompt non equivale all’affidabilità multi-turno, con implicazioni su TCO e strategie di quantization.

[DEEPENING] ✓ Published | 2026-07-06 09:31 UTC

Qwen3.6-27B Q8 and KV Cache: 115K Tokens on a Single RTX 5090

Qwen3.6-27B Q8 e cache KV: 115K token su singola RTX 5090

L’esperimento di un utente dimostra che un LLM da 27B quantizzato a Q8 può servire contesti fino a 115.000 token su una GPU consumer con 32 GB di VRAM, grazie alla quantization selettiva della cache chiave-valore. I compromessi tra memoria, velocità e qualità percepita aprono prospettive concrete per il deployment on-premise senza hardware enterprise, ma sollevano la necessità di valutazioni oggettive sulle prestazioni reali.