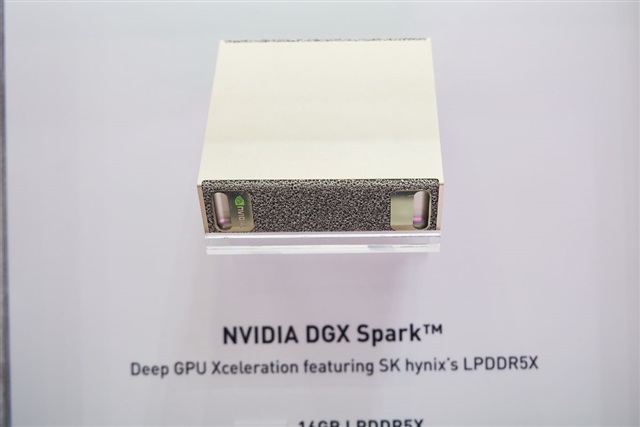
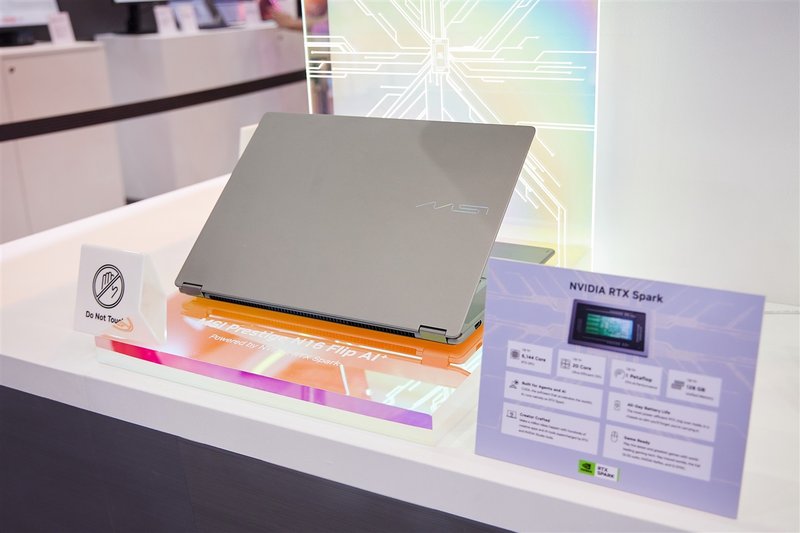
La notizia, rilanciata da DIGITIMES, è apparentemente una mossa di prodotto: Nvidia spinge i personal AI computer. Ma il titolo segnala qualcosa di più profondo: il baricentro del calcolo AI si sta spostando dai data center cloud verso macchine locali. Non è una semplice questione di nuove schede video consumer; è una ridefinizione del confine tra cloud, edge e on-premise.
Il punto di svolta è che l'inference, la fase in cui un LLM produce risposte, può vivere su hardware che non deve per forza stare in un rack remoto. Un personal AI computer è, di fatto, un nodo on-premise in miniatura: conserva i dati sul dispositivo, riduce la latenza di rete e consegna all'utente un controllo diretto sul modello. Per un'azienda che valuta il deployment di LLM, questa non è una curiosità da appassionati, ma un'opzione concreta per carichi di lavoro sensibili.
Il vincolo principale resta la VRAM. Le GPU consumer hanno meno memoria video rispetto agli acceleratori da data center, e questo costringe a usare la quantization per far entrare modelli più piccoli in spazi più stretti. Il trade-off è noto: la quantization può ridurre l'ingombro e accelerare l'inference, ma può anche degradare la qualità delle risposte. Chi progetta pipeline on-premise deve quindi ragionare su modelli ridotti, fine-tuning mirato e architetture ibride, non su repliche esatte di ciò che gira nel cloud.
Da un punto di vista economico, la spinta di Nvidia cambia gli incentivi. Il cloud ha dominato perché trasformava il CapEx in OpEx e prometteva scalabilità quasi infinita. Ma quando l'hardware locale diventa abbastanza capace da eseguire un LLM utile, l'equazione si ribalta: per carichi stabili e dati regolamentati, un investimento upfront in macchine on-premise può ridurre i costi ricorrenti e rafforzare la sovranità dei dati. Non è una vittoria automatica, perché manutenzione, consumi e aggiornamenti restano a carico di chi possiede l'hardware, ma il calcolo diventa più sfumato.
Il segnale strutturale è questo: Nvidia non sta solo ampliando la propria offerta, sta educando il mercato a considerare il dispositivo locale come un'alternativa credibile al cloud. I secondi effetti si vedono già in filigrana. Gli OEM di PC guadagnano un nuovo argomento di vendita; i fornitori di API cloud rischiano di perdere quote di inference leggera; i team IT devono attrezzarsi per gestire flotte eterogenee di macchine locali, non solo un endpoint API. La terza conseguenza è meno visibile ma più duratura: i modelli dovranno essere progettati per girare bene su hardware vincolato, e questo sposta l'attenzione dall'addestramento massivo all'efficienza in fase di esecuzione.
Non è un caso che il tema si intersechi con la sovranità dei dati. Un personal AI computer può processare documenti, email e conversazioni senza inviarli a server esterni, un requisito che in Europa diventa sempre più rilevante per il GDPR. Per chi valuta deployment on-premise, esistono trade-off tra controllo e complessità operativa; su AI-RADAR, la sezione /llm-onpremise offre framework analitici per valutarli.
La mossa di Nvidia, insomma, non chiude il dibattito tra cloud e on-premise: lo riapre, spostando l'asticella verso il basso, dove i personal computer diventano infrastruttura.






💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!