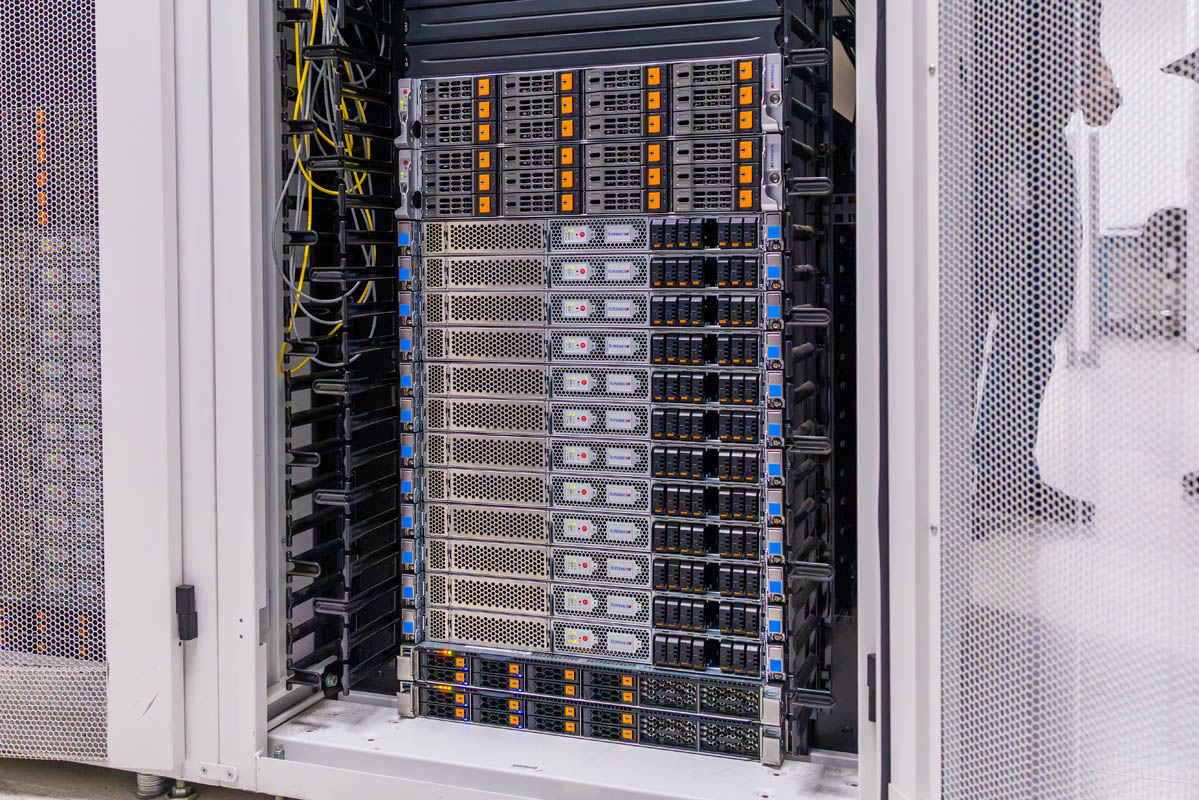
Il laboratorio F5 ha mostrato un risultato che merita attenzione: con BIG-IP Next for Kubernetes, lo stesso cluster GPU ha reso più del triplo delle prestazioni. Non è una nuova generazione di acceleratori, né un salto di VRAM. È un guadagno che arriva dal modo in cui il traffico verso i nodi di calcolo viene gestito, bilanciato e instradato.
Kubernetes è ormai la piattaforma operativa comune per molti carichi AI, ma la rete resta spesso un elemento sottovalutato. Quando un cluster esegue inference o fine-tuning, i dati devono muoversi rapidamente tra storage, nodi e processi di serving. Ogni collo di bottiglia su quel percorso lascia le GPU in attesa, vanificando parte della capacità acquistata.
La tesi che emerge dal test F5 è che il prossimo salto di efficienza per i cluster AI non arriverà solo dall'hardware, ma dalla riduzione dell'attrito tra piano dati e piano di controllo. Se un componente di rete può liberare capacità già presente, la conversazione sul TCO cambia: aggiungere GPU non è più l'unica leva per scalare.
Per i team che gestiscono infrastrutture locali, questo ha implicazioni concrete. I cluster on-premise spesso non possono crescere orizzontalmente con la stessa facilità di un cloud, quindi l'efficienza per nodo diventa centrale. Un miglioramento di questo tipo può ridurre la pressione a overprovisioning e spostare parte del budget dal silicio al software e alla configurazione di rete. Sul fronte opposto, c'è il rischio di legare l'ottimizzazione a uno stack proprietario, con nuove forme di dipendenza tecnicica.
Il dato viene dal laboratorio del vendor e andrà verificato su carichi reali. Ma il segnale strutturale è chiaro: la maturazione delle infrastrutture AI passa anche dalla capacità di orchestrare il traffico, non solo dall'accumulo di compute. Per chi valuta deployment on-premise, AI-RADAR offre framework analitici su /llm-onpremise per confrontare questi trade-off.






💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!