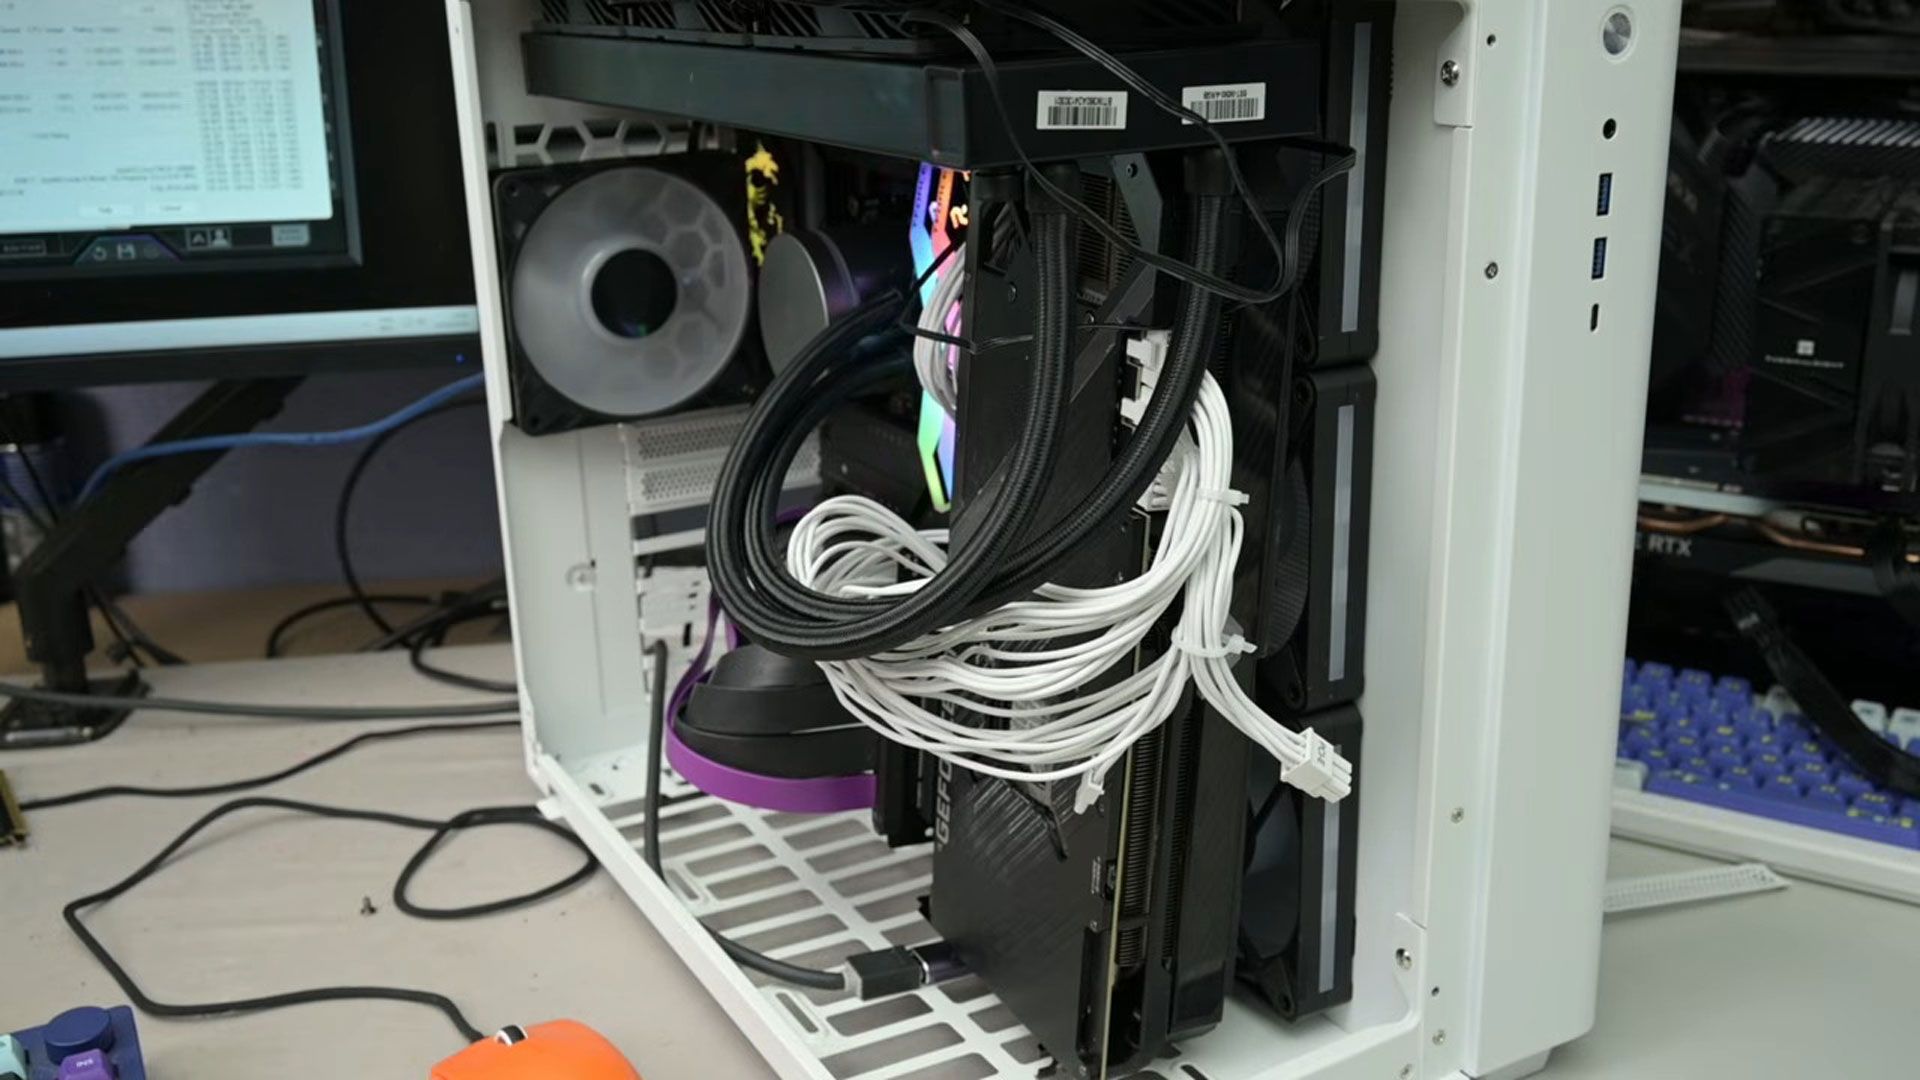
Il risultato sembra controintuitivo: una scheda video montata dove normalmente non andrebbe registra una temperatura di hotspot più bassa di 19 gradi. Non è un dettaglio da appassionati di case modding. In un'epoca in cui l'inference di modelli linguistici e altre workload intensive si spostano su hardware locale, la temperatura dell'hotspot è uno dei parametri che decide se un sistema mantiene le frequenze di boost o scende in throttling.
Il dato da solo non basta a riscrivere i manuali, ma obbliga a ragionare su un punto strutturale: il raffreddamento di una GPU non dipende solo dalla qualità del dissipatore o dal numero di ventole. La posizione fisica rispetto ad altre schede, alla parete del case e al flusso d'aria può creare sacche di calore che i sensori medi non sempre evidenziano. Qui sta il valore del rilievo: l'hotspot, che misura il punto più caldo del die, è un indicatore più severo della temperatura media.
Per chi assembla o sceglie macchine self-hosted per LLM, le implicazioni sono immediate. I carichi di inference e fine-tuning tendono a saturare la GPU per periodi prolungati. Se il layout dello chassis lascia una scheda in una zona stagnante, il sistema può apparire stabile nei primi minuti e poi perdere colpi dopo ore di utilizzo. Una differenza di 19 gradi sull'hotspot non è solo comfort acustico: può determinare se la GPU resta dentro la finestra di boost o se il firmware riduce le frequenze.
Vale la pena guardare alla questione in ottica TCO. Un sistema on-premise per inference di modelli locali non si valuta solo con i benchmark di picco. Contano il consumo energetico sotto carico sostenuto, la longevità dell'hardware e la prevedibilità delle prestazioni. Una progettazione termica che lascia margine evita interventi successivi, riduce la rumorosità e mantiene i componenti in condizioni di lavoro meno stressanti. Non è una questione estetica: è un fattore che incide sul costo operativo. Per chi valuta questi trade-off, AI-RADAR dedica spazio ai framework di analisi on-premise su /llm-onpremise.
Il caso del modder segnala un'abitudine progettuale da mettere in discussione. Molti chassis e molte schede madri nascono con una disposizione standard degli slot PCIe che favorisce la compatibilità, non necessariamente il raffreddamento ottimale. Quando si montano più GPU per aumentare la VRAM aggregata o per parallelizzare l'inference, lo spazio tra le schede diventa una risorsa scarsa. Le soluzioni con riser o posizionamenti non convenzionali vengono spesso liquidate come scelte da modding, ma possono offrire vantaggi termici concreti.
C'è anche un effetto di secondo ordine per chi vende sistemi pronti. I fornitori di macchine per AI on-premise hanno un incentivo a differenziarsi non solo con le specifiche dei modelli supportati, ma con la qualità termica del progetto. Un cliente enterprise che valuta un parco di macchine per LLM non sempre ha modo di testare il comportamento sotto carico per settimane. La reputazione di chi progetta layout efficienti diventa un asset, soprattutto quando i carichi sono continui e il rumore in ufficio o in laboratorio è un vincolo.
Non serve esagerare la portata di un singolo esperimento, e il dato riportato non include dettagli sulla configurazione esatta. Ma è sufficiente per ricordare che nel deployment locale di carichi AI la parte meccanica non è ancillare. È il fondamento su cui poggiano le decisioni di acquisto, il dimensionamento dei rack e la stima dei costi energetici. Se una modifica apparentemente irrazionale produce un hotspot più freddo di 19 gradi, la domanda da porsi non è solo 'quanto vale in benchmark', ma 'quanto stiamo perdendo per via di disposizioni standard che nessuno ha messo in discussione'.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!