Digest Settimanale

📖 AI-Radar · 2026-W39

21 September – 27 September 2026  ·  60 articoli pubblicati

📁 LLM 13

Sicurezza, ad hominem e controllo locale: il vero costo degli LLM addomesticati

Sicurezza, ad hominem e controllo locale: il vero costo degli LLM addomesticati

Il fine-tuning di sicurezza non è neutro: riduce lo spazio strategico degli LLM nei dibattiti reali. Per i deployment on-premise conta il controllo dei pesi, delle pipeline e del TCO. L'analisi AI-Radar mette a fuoco il trade-off tra modelli pronti via API e sistemi self-hosted capaci di ridefinire il comportamento conversazionale.

25 Sep
SMILESGNN: tossicità clinica spiegabile con un modello da 0,4M parametri

SMILESGNN: tossicità clinica spiegabile con un modello da 0,4M parametri

Un modello multimodale da 0,4 milioni di parametri combina transformer SMILES e grafi GATv2 via cross-attention, ottenendo su ClinTox AUC-ROC 0,987 e F1 0,906. La variante con backbone ChemBERTa-2 su Tox21 raggiunge AUC-ROC medio 0,750, paragonabile a baseline più grandi. Il ramo grafico esplicito supporta spiegazioni GNNExplainer, segnalando che performance e interpretabilità possono coesistere in modelli compatti adatti anche a deployment on-premise.

25 Sep #Hardware #LLM On-Premise #Fine-Tuning
Agenti di previsione, il ragionamento non è sempre la scelta giusta

Agenti di previsione, il ragionamento non è sempre la scelta giusta

Un gruppo di ricerca ha sottoposto gli agenti di previsione a stress test comportamentali per capire quando retrieval, ragionamento, prior di mercato o analoghi storici meritano fiducia. La scelta del meccanismo dipende dalla fonte. ReliabilityRoute indirizza il comportamento con caratteristiche di affidabilità e una regola walk-forward ottiene il miglior punteggio Brier medio tra i sistemi deterministici su 16 vintage LLM. Il guadagno è modesto: più ragionamento non è sempre migliore.

25 Sep #LLM On-Premise #DevOps
Quando i LLM non sono d'accordo: così gli esperti intervengono solo dove serve

Quando i LLM non sono d'accordo: così gli esperti intervengono solo dove serve

Uno studio su migliaia di trascrizioni di sessioni di tutoraggio mostra che usare il disaccordo tra più LLM per indirizzare l'attenzione degli esperti accorcia la revisione dei codebook da mesi a giorni. Tra tre metodi, la Rationale Labeling raggiunge il 64,9% di accuratezza contro il 57,8% del codebook rivisto dagli esperti. Il risultato segnala un cambio di incentivi: meno potenza di calcolo, più orchestrazione mirata del lavoro umano.

24 Sep #Hardware #LLM On-Premise #DevOps
Il template chat accende i disclaimer dei LLM: le auto-descrizioni non vanno prese alla lettera

Il template chat accende i disclaimer dei LLM: le auto-descrizioni non vanno prese alla lettera

Uno studio su otto modelli instruct open-source fino a 9B parametri mostra che il template della chat agisce come un interruttore: quando è presente aumenta i disclaimer "sono solo un'AI" e riduce le espressioni esperienziali, e viceversa. Nei layer di attivazione di tre modelli esiste una direzione che controlla questa voce. Per chi valuta LLM self-hosted, il risultato segnala che le auto-descrizioni non sono proprietà intrinseche del modello.

23 Sep #LLM On-Premise #Fine-Tuning #DevOps
Dati didattici o casi clinici: come cambia il profilo degli LLM medici

Dati didattici o casi clinici: come cambia il profilo degli LLM medici

Uno studio con esperimenti a parità di token mostra che i dati didattici e quelli clinici influenzano in modo asimmetrico i Large Language Models medici: i dati clinici migliorano i task orientati alla clinica e restano competitivi su quelli di conoscenza, mentre i dati didattici spingono soprattutto la teoria. L'analisi degli errori rivela un divario tra sapere e fare, indicando una curatela dei dati guidata dal caso d'uso.

23 Sep #Hardware #LLM On-Premise #Fine-Tuning
Open weight: i download cinesi doppiano quelli USA e l'inference locale cambia

Open weight: i download cinesi doppiano quelli USA e l'inference locale cambia

La testimonianza scritta di Nathan Lambert al Congresso fotografa un sorpasso strutturale: da agosto 2025, i modelli open-weight cinesi contano 3,2 miliardi di download su Hugging Face contro 1,6 miliardi americani. Su OpenRouter il traffico aperto è passato da circa mille miliardi a 80mila miliardi di token settimanali, con oltre l'80% da modelli cinesi. Il ritardo stimato dalla frontiera chiusa è di 2-5 mesi per i cinesi, 6-9 per gli americani, con il divario minore nell'agentic coding.

23 Sep #Hardware #LLM On-Premise #Fine-Tuning

📁 Altro 14

Qwen 27B genera motion graphics su una RTX 4090: il confine locale si sposta

Qwen 27B genera motion graphics su una RTX 4090: il confine locale si sposta

Un utente ha usato Qwen 27B su una RTX 4090 per produrre motion graphics ispirate ai recenti post con Opus 5.5. Il progetto, costruito con il framework Accuretta, mostra che la generazione creativa locale comincia a coprire casi d'uso finora riservati a modelli proprietari nel cloud. Nessuna metrica prestazionale è stata pubblicata, ma il segnale per chi valuta deployment self-hosted è chiaro: la barriera non è più soltanto il modello, ma l'orchestrazione.

27 Sep #Hardware #LLM On-Premise #DevOps
Come aggiungere AI al software legacy senza riscriverlo

Come aggiungere AI al software legacy senza riscriverlo

La convinzione che l’intelligenza artificiale imponga di riscrivere i sistemi legacy è spesso sbagliata. Esistono pattern di integrazione che trattano l’AI come un nuovo strato, non come una nuova fondazione: middleware, RAG, integrazione event-driven e Strangler Fig. La partita vera si gioca sul governo degli accessi e sui costi operativi, non sulla sostituzione del core.

25 Sep #LLM On-Premise #Fine-Tuning #DevOps
Project Suncatcher: il primo test orbitale di Google parte il 1° ottobre

Project Suncatcher: il primo test orbitale di Google parte il 1° ottobre

Google lancia il 1° ottobre il satellite MVP, grande quanto un frigorifero, con quattro acceleratori TPU custom e pannelli solari da circa un kilowatt. Il test, parte del progetto Suncatcher, valida l'idea di costellazioni di satelliti per training e inference di modelli AI, riducendo il consumo energetico a terra. Il satellite usa un bus di Planet Labs, non costruito da zero.

24 Sep #Hardware #LLM On-Premise #Fine-Tuning
KDE, la proposta AI-native infiamma la comunità open source

KDE, la proposta AI-native infiamma la comunità open source

La presentazione di una KDE 'AI-native' all'Akademy ha scatenato un conflitto aspro: thread cancellati, ban e una campagna per vietare del tutto l'uso degli LLM. Nate Graham ha chiesto scusa per il caos, mentre GNOME discute una policy simile. I nuovi obiettivi di KDE non citano l'IA, ma il nodo resta aperto: come governare contributi generati con LLM senza erodere fiducia e controllo.

24 Sep #LLM On-Premise #DevOps
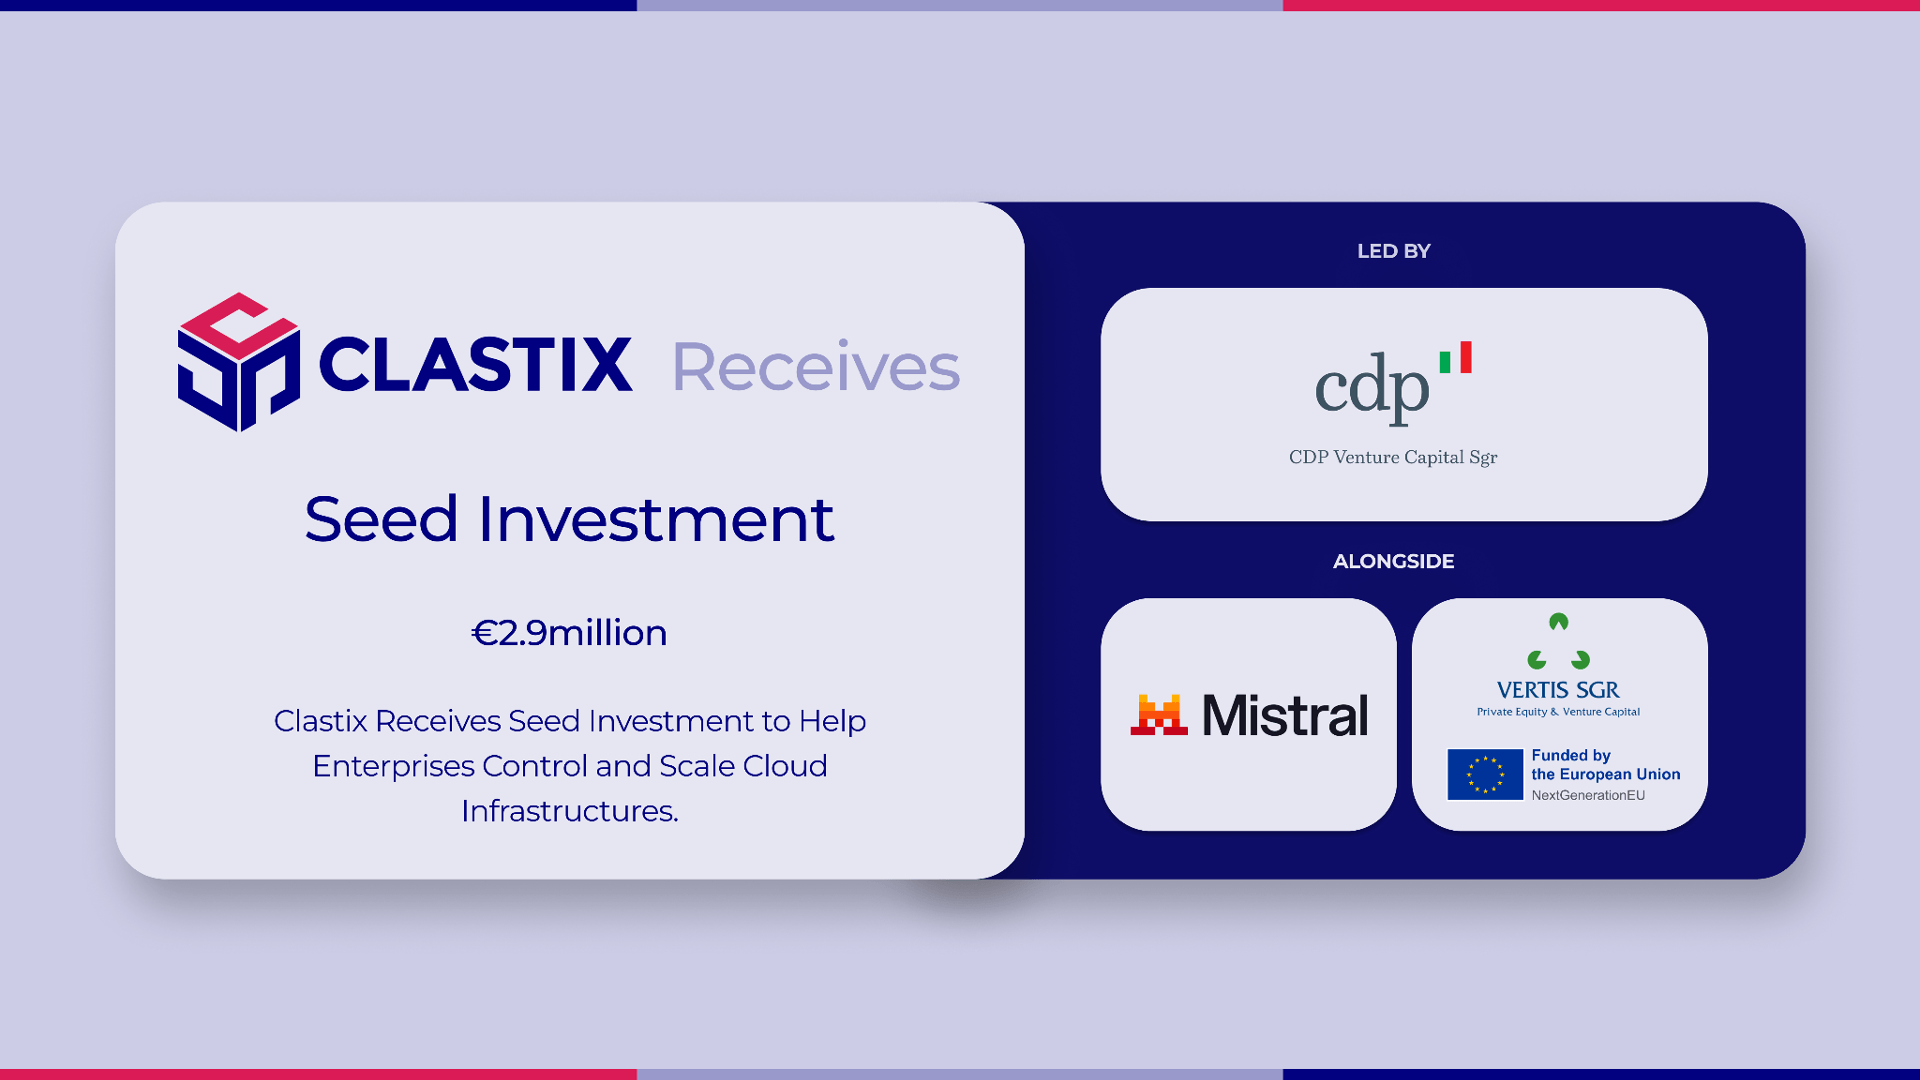
Clastix chiude un round da 2,9 milioni e punta a semplificare Kubernetes su larga scala

Clastix chiude un round da 2,9 milioni e punta a semplificare Kubernetes su larga scala

Clastix, società italiana attiva nella gestione di Kubernetes, ha chiuso un seed da 2,9 milioni di euro guidato da CDP Venture Capital Sgr. Il round coinvolge Mistral e VERTIS SGR. Con Kamaji, motore open source per control plane ospitati, e kMetal, piattaforma commerciale, sposta i control plane su infrastruttura condivisa per ridurre overhead e semplificare le operazioni su larga scala. Mistral conferma l'uso in produzione per training e inference.

24 Sep #LLM On-Premise #Fine-Tuning #DevOps
L’hack dell’FBI smaschera l’unità di hacking remota: dati su case e familiari

L’hack dell’FBI smaschera l’unità di hacking remota: dati su case e familiari

La violazione dei dati personali di migliaia di funzionari FBI include membri della Remote Operations Unit, con indirizzi, telefoni e nomi dei coniugi. 404 Media ha verificato parte dei 5.000 record attribuiti a ShinyHunters. La sensibilità del leak sta nella mappatura organizzativa che espone: ruoli, unità e relazioni personali. Un colpo alla sicurezza e alla sovranità dei dati anche per chi gestisce stack self-hosted.

23 Sep #LLM On-Premise #DevOps
DiffuseDrive riempie i vuoti di dati che bloccano l'AI fisica

DiffuseDrive riempie i vuoti di dati che bloccano l'AI fisica

La startup ungherese DiffuseDrive genera dati sintetici per addestrare sistemi di AI fisica in difesa, mining, aerospace e veicoli autonomi. La piattaforma individua i casi limite assenti nei dataset, li produce controllando posizione e dimensione degli oggetti e alimenta il retraining. Funziona anche in modalità air-gapped su infrastruttura del cliente; con cluster GPU i dati si generano in ore. DiffuseDrive riporta miglioramenti superiori al 10% combinando sintetico e reale.

23 Sep #Hardware #LLM On-Premise #Fine-Tuning
ShinyHunters rivendica la violazione dell’FBI: dati su agenti e candidati

ShinyHunters rivendica la violazione dell’FBI: dati su agenti e candidati

Il gruppo ShinyHunters sostiene di aver violato servizi collegati all’FBI e di detenere dati su tutti i dipendenti e candidati. Ha fornito un campione di 5.000 persone con nomi, indirizzi, telefoni e dettagli sui coniugi, verificati in parte con strumenti OSINT. L’attacco sarebbe passato da una vulnerabilità zero-day in Oracle PeopleSoft e da AWS GovCloud. Il gruppo nega motivazioni finanziarie e parla di coercizione.

22 Sep #LLM On-Premise
AstroForge mette un piccolo transformer al comando della prossima sonda

AstroForge mette un piccolo transformer al comando della prossima sonda

AstroForge affiderà alla prossima sonda Autonomy-1 un modello transformer di piccole dimensioni con il compito di prendere decisioni a bordo. L’inference locale diventa necessaria per gestire l’assenza di connettività e i vincoli fisici dello spazio. Il passaggio da software deterministico a policy appresa cambia i criteri di validazione e sposta gli incentivi verso chi comprime e verifica modelli per edge estremo.

22 Sep #Hardware #LLM On-Premise #DevOps
systemd 262 porta un canary AI/LLM nel cuore di Linux

systemd 262 porta un canary AI/LLM nel cuore di Linux

systemd 262 introduce un canary AI/LLM per codice non revisionato e l'integrazione LUO. L'aggiornamento del sistema di init Linux segna un passaggio strutturale: l'analisi assistita da LLM entra nella base dell'infrastruttura, con implicazioni per fiducia, sovranità e deployment self-hosted. L'articolo analizza chi guadagna e chi perde quando un componente deterministico incorpora logiche probabilistiche.

22 Sep #LLM On-Premise #DevOps

📁 Frameworks 18

KoboldCpp integra un agente locale: 9 tool, prompt ridotto e 12 GB di VRAM

KoboldCpp integra un agente locale: 9 tool, prompt ridotto e 12 GB di VRAM

KoboldCpp ora include un harness agente integrato, attivabile con una spunta o con --agent. L'agente offre nove strumenti integrati, un prompt di sistema da circa 2.000 token e punta a sostituire tool esterni come Opencode, Codex e Claude Code. Richiede almeno 28k di contesto, 8k di generazione e 12 GB di VRAM raccomandati. Concedo segnala anche un sito phishing che sfrutta blackhat SEO.

26 Sep #Hardware #LLM On-Premise #DevOps
JAZ: un solo primitive invoke sfida i framework specializzati per agenti LLM

JAZ: un solo primitive invoke sfida i framework specializzati per agenti LLM

Un team di ricerca ha presentato JAZ, un framework per agenti LLM che riduce l'harness a un unico primitive, invoke, capace di eseguire codice arbitrario e di esporre all'LLM input e cronologia come variabili. Senza tool manuali né sistemi esterni, invoke supera Letta dell'8% su StuLife a metà costo e ACE del 4% su AppWorld. Una sfida alle architetture specializzate nella memoria e nell'auto-miglioramento.

24 Sep #LLM On-Premise #DevOps
GGUF nativi in Transformers: il punto per il deployment locale

GGUF nativi in Transformers: il punto per il deployment locale

Hugging Face ha aggiunto il supporto nativo ai file GGUF in Transformers. Basta indicare il percorso del file quantizzato per caricare il modello e usare le API standard. Su Apple Silicon vengono riutilizzati i kernel ggml, con benchmark su M2 Max vicini a llama.cpp. Non si tratta di sostituire llama.cpp, ma di offrire un ambiente più flessibile per debugging e valutazione, abbassando la barriera per chi lavora su hardware locale.

23 Sep #Hardware #LLM On-Premise #DevOps
Cellule 3D da immagini 2D: un framework sfrutta le statistiche di popolazione

Cellule 3D da immagini 2D: un framework sfrutta le statistiche di popolazione

Un framework a supervisione di popolazione collega immagini 2D di globuli rossi a quantità biofisiche latenti, aggregandole in volume corpuscolare medio, ampiezza di distribuzione eritrocitaria ed emoglobina corpuscolare media. Combina inference locale condivisa, decoder strutturato, pesature apprese e calibrazione per dispositivo. Su 390 campioni e 1.105 acquisizioni da sei dispositivi riporta correlazioni di Pearson 0,86–0,98 con un analizzatore Sysmex, senza rivendicare ricostruzione 3D esplicita.

23 Sep #LLM On-Premise #Fine-Tuning #DevOps

📁 Hardware 12

Mac Studio M5 Ultra: 256 GB di RAM, ma la GPU frena l'AI locale

Mac Studio M5 Ultra: 256 GB di RAM, ma la GPU frena l'AI locale

Un utente ha testato un Mac Studio con M5 Ultra, 256 GB di RAM e GPU a 80 core per inference agentica con GLM-5.3-Flash. I risultati lo soddisfano, ma segnala che la GPU sembra sottodimensionata rispetto alla memoria, sollevando dubbi sull'utilità di un modello da 512 GB. Il caso evidenzia il trade-off tra capacità di memoria e potenza di calcolo nelle macchine locali per LLM.

25 Sep #Hardware #LLM On-Premise
Qwen3.8-Flash-Next su RTX 5070: 65 token/s con un motore dedicato

Qwen3.8-Flash-Next su RTX 5070: 65 token/s con un motore dedicato

Una RTX 5070 da 12 GB esegue Qwen3.8-Flash-Next a 65,1 token/s con un motore di inference dedicato. Il progetto Strata mostra come un runtime specializzato possa battere llama.cpp sulla stessa precisione numerica, portando l'elaborazione del prompt a 543 token/s su contesti da 128K. Un segnale per il deployment locale: hardware consumer, riduzione aggressiva della precisione e software ad hoc cambiano i termini del self-hosted.

24 Sep #Hardware #LLM On-Premise #DevOps
Mac M5 Ultra 256GB: il silenzio dei benchmark penalizza l’on-premise

Mac M5 Ultra 256GB: il silenzio dei benchmark penalizza l’on-premise

Il Mac M5 Ultra con 256 GB è sul mercato ma mancano benchmark seri: solo influencer che testano modelli da 8b. Questo vuoto informativo penalizza chi valuta l'hardware Apple per LLM self-hosted, favorendo di fatto l'ecosistema Nvidia. Senza dati ripetibili su inference, quantization e TCO, il potenziale della memoria unificata resta non verificato, con implicazioni per la sovranità dei dati e la diversificazione dell'offerta on-premise.

24 Sep #Hardware #LLM On-Premise #DevOps
AMD e GDDR7 su Linux: il segnale infrastrutturale per chi fa inference on-premise

AMD e GDDR7 su Linux: il segnale infrastrutturale per chi fa inference on-premise

L'avvio del supporto GDDR7 nei driver Linux di AMD segnala un cambiamento per chi gestisce infrastrutture AI on-premise. La notizia, apparentemente tecnica, anticipa l'importanza della banda di memoria per l'inference LLM e riduce l'attrito di integrazione per ambienti self-hosted. Un segnale da leggere in ottica TCO e sovranità dei dati, più che come annuncio di prodotto.

24 Sep
AMD inizia ad aggiungere il supporto GDDR7 ai driver GPU Linux

AMD inizia ad aggiungere il supporto GDDR7 ai driver GPU Linux

AMD ha iniziato ad aggiungere il supporto a GDDR7 nei driver GPU per Linux. Il lavoro di bring-up anticipa l'arrivo delle schede e tocca direttamente la banda di memoria, una variabile chiave per l'inference LLM su hardware locale. Per chi gestisce infrastrutture self-hosted su Linux, il supporto precoce nel driver aperto riduce l'attrito di integrazione e segnala una direzione precisa, anche se non ci sono ancora dettagli di prodotto.

23 Sep #Hardware #LLM On-Premise #Fine-Tuning

📁 OnPremise 1

Qwengram-0.8B: memoria esterna e gate dinamica cambiano i conti del self-hosted

Qwengram-0.8B: memoria esterna e gate dinamica cambiano i conti del self-hosted

Qwengram-0.8B congela Qwen3.5-0.8B e aggiunge una memoria n-gram da 51 miliardi di parametri fuori dal GGUF. La perplexity scende del 5,05%, ma il dato rilevante è l'architettura: iniezione tardiva governata da una gate per token, sidecar quantizzato Q8_0 e nessun fine-tuning del backbone. Per chi gestisce LLM locali, il segnale è la separazione tra pesi e conoscenza: aggiornare la memoria senza toccare il modello apre scenari nuovi, ma impone vincoli severi ai runtime.

26 Sep

📁 Market 2

← 2026-W38 Tutte le notizie 2026-W40 →