Digest Settimanale Questa settimana

📖 AI-Radar · 2026-W42

12 October – 18 October 2026  ·  60 articoli pubblicati

📁 OnPremise 8

Una Radeon da 16 GB esegue un LLM da 27B con 262k token: il segnale

Una Radeon da 16 GB esegue un LLM da 27B con 262k token: il segnale

Un homelab, non un vendor, ha documentato un LLM da 27 miliardi di parametri con 262.000 token di contesto su una singola Radeon RX 9060 XT da 16 GB di VRAM, usando quantization, streaming della cache KV e fix software. Il segnale: il costo d'ingresso per self-hosted ad alto contesto si sposta dalle GPU alla gestione del compromesso memoria-precisione-throughput. Resta il costo nascosto di integrazione e supporto.

18 Oct
Il 4B BF16 di NVIDIA e il conto della VRAM nell'inference locale

Il 4B BF16 di NVIDIA e il conto della VRAM nell'inference locale

La pubblicazione di Dory1.0-4B-BF16 mostra come la precisione BF16 ridefinisca il deployment locale. Non è solo un modello piccolo: circa 8 GB di pesi spostano l'attenzione su VRAM, TCO e quantization. Per team con workstation e piccoli server, il segnale è chiaro: cresce la fascia intermedia tra cloud ed edge, con implicazioni per vendor GPU e fornitori cloud. Un'analisi del trade-off tra controllo e infrastruttura.

17 Oct
Mesa porta YOLOX su NPU: il driver aperto ridefinisce l'inference locale

Mesa porta YOLOX su NPU: il driver aperto ridefinisce l'inference locale

Mesa estende il supporto alle NPU e dimostra YOLOX via PyTorch, spostando l'accesso all'accelerazione fuori dai toolchain proprietari. Per edge e on-premise, il driver aperto riduce lock-in e costi di porting, cambiando il calcolo del TCO. AI-Radar legge il segnale strutturale: l'accelerazione AI segue la traiettoria delle GPU, dove il valore si sposta dal semplice accesso hardware all'orchestrazione con framework condivisi e pipeline riproducibili.

14 Oct
Reverse engineering CUDA con AI: il sintomo di un lock-in che pesa sull'on-premise

Reverse engineering CUDA con AI: il sintomo di un lock-in che pesa sull'on-premise

Un post Reddit rilancia l'idea di usare LLM per ricreare CUDA open source e liberare le GPU AMD. Il segnale non è la fattibilità tecnica immediata, ma la tensione strutturale tra controllo dello stack, compatibilità software e TCO nelle infrastrutture self-hosted. Per chi valuta deployment on-premise, il dibattito mostra come la scelta hardware sia inseparabile da ecosistemi, framework e vincoli di migrazione.

13 Oct
Scontrini on-device: il segnale per chi controlla l'inference locale

Scontrini on-device: il segnale per chi controlla l'inference locale

Un modello da 0,8B che legge scontrini sul telefono mostra l'inference on-device come opzione concreta per documenti personali. Il progetto intreccia fine-tuning su dati donati, output JSON e una valvola self-hosted via server OpenAI-compatibile. Il segnale per chi valuta deployment locali è il trade-off tra memoria, qualità dei dati e TCO, con la sovranità come vincolo e non preferenza.

12 Oct

📁 Hardware 15

ORL spinge i diffusion LLM a 2.788 token/s su una RTX 5090

ORL spinge i diffusion LLM a 2.788 token/s su una RTX 5090

Il progetto ORL (On-Policy Residual Learning) promette di accelerare i diffusion LLM senza sacrificare la qualità. Su una singola RTX 5090 il team segnala 2.788 token/s con LLaDA-2.1-mini in NVFP4; il motore di inference dlmrt, open source, sfrutta CUDA graph e supporta le GPU Blackwell. Numeri di picco in modalità single-request, ma il valore sta nel cambio di prospettiva per chi valuta deployment self-hosted.

16 Oct #Hardware #LLM On-Premise #Fine-Tuning
Bolt Graphics cerca 100 milioni di dollari per sfidare Nvidia e AMD con la GPU Zeus

Bolt Graphics cerca 100 milioni di dollari per sfidare Nvidia e AMD con la GPU Zeus

Bolt Graphics cerca 100 milioni di dollari per sviluppare Zeus, una GPU che punta a sfidare Nvidia e AMD oltre i soli carichi AI. La fonte non riporta specifiche tecniche, ma la mossa segnala un tentativo di creare un terzo polo hardware. Il successo dipenderà meno dal silicio e più dall'ecosistema software, dal TCO e dalla capacità di convincere chi gestisce pipeline self-hosted.

16 Oct #Hardware #LLM On-Premise #Fine-Tuning
Una PS5 jailbroken esegue Qwen 27B a 20 token/s: segnale per il self-hosting

Una PS5 jailbroken esegue Qwen 27B a 20 token/s: segnale per il self-hosting

Una PS5 sbloccata esegue Qwen 27B a circa 20 token/s sulla GPU della console. L'esperimento, emerso su Reddit, mostra come hardware consumer con memoria unificata possa sostenere inference self-hosted su modelli da 27 miliardi di parametri, abbassando la soglia d'ingresso per prototipi on-prem. Non è un server di produzione, ma segnala una pressione sui costi e nuovi spazi per la sovranità dei dati.

13 Oct #Hardware #LLM On-Premise #DevOps
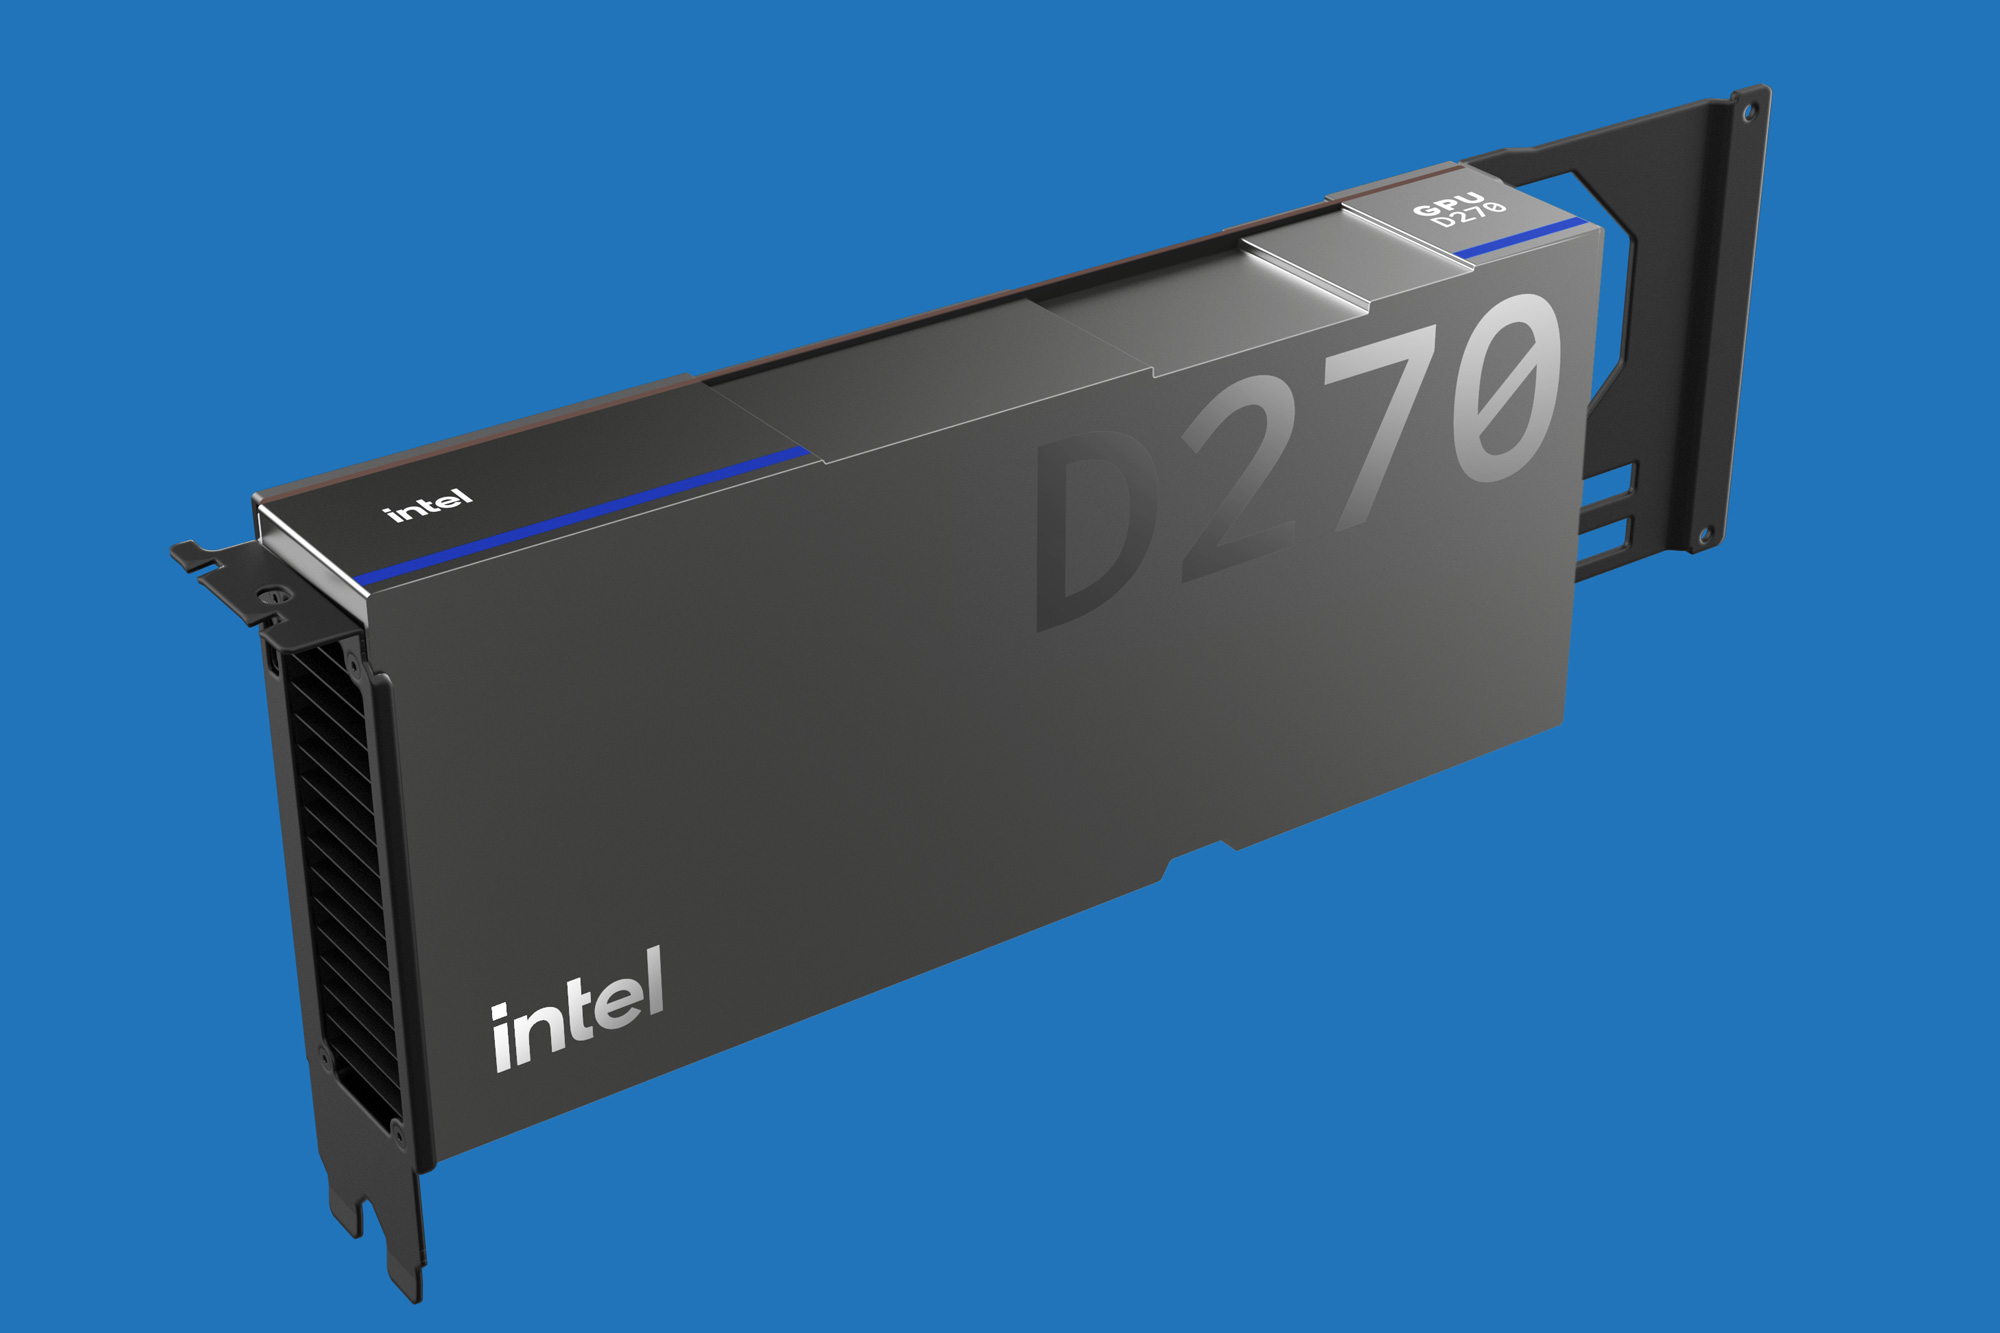
Da Crescent Island alla serie D: Intel punta sull’inference aziendale

Da Crescent Island alla serie D: Intel punta sull’inference aziendale

Intel ha annunciato la serie GPU D, erede dei prodotti noti come Crescent Island e pensata per l’inference in ambito enterprise. L’annuncio non include specifiche su VRAM o prestazioni, ma il cambio di denominazione segnala un posizionamento più diretto nel mercato degli acceleratori per LLM on-premise. Per chi valuta deployment locali, il punto non è il confronto prestazionale immediato, ma capire come Intel intende competere su TCO e integrazione.

12 Oct #Hardware #LLM On-Premise #Fine-Tuning
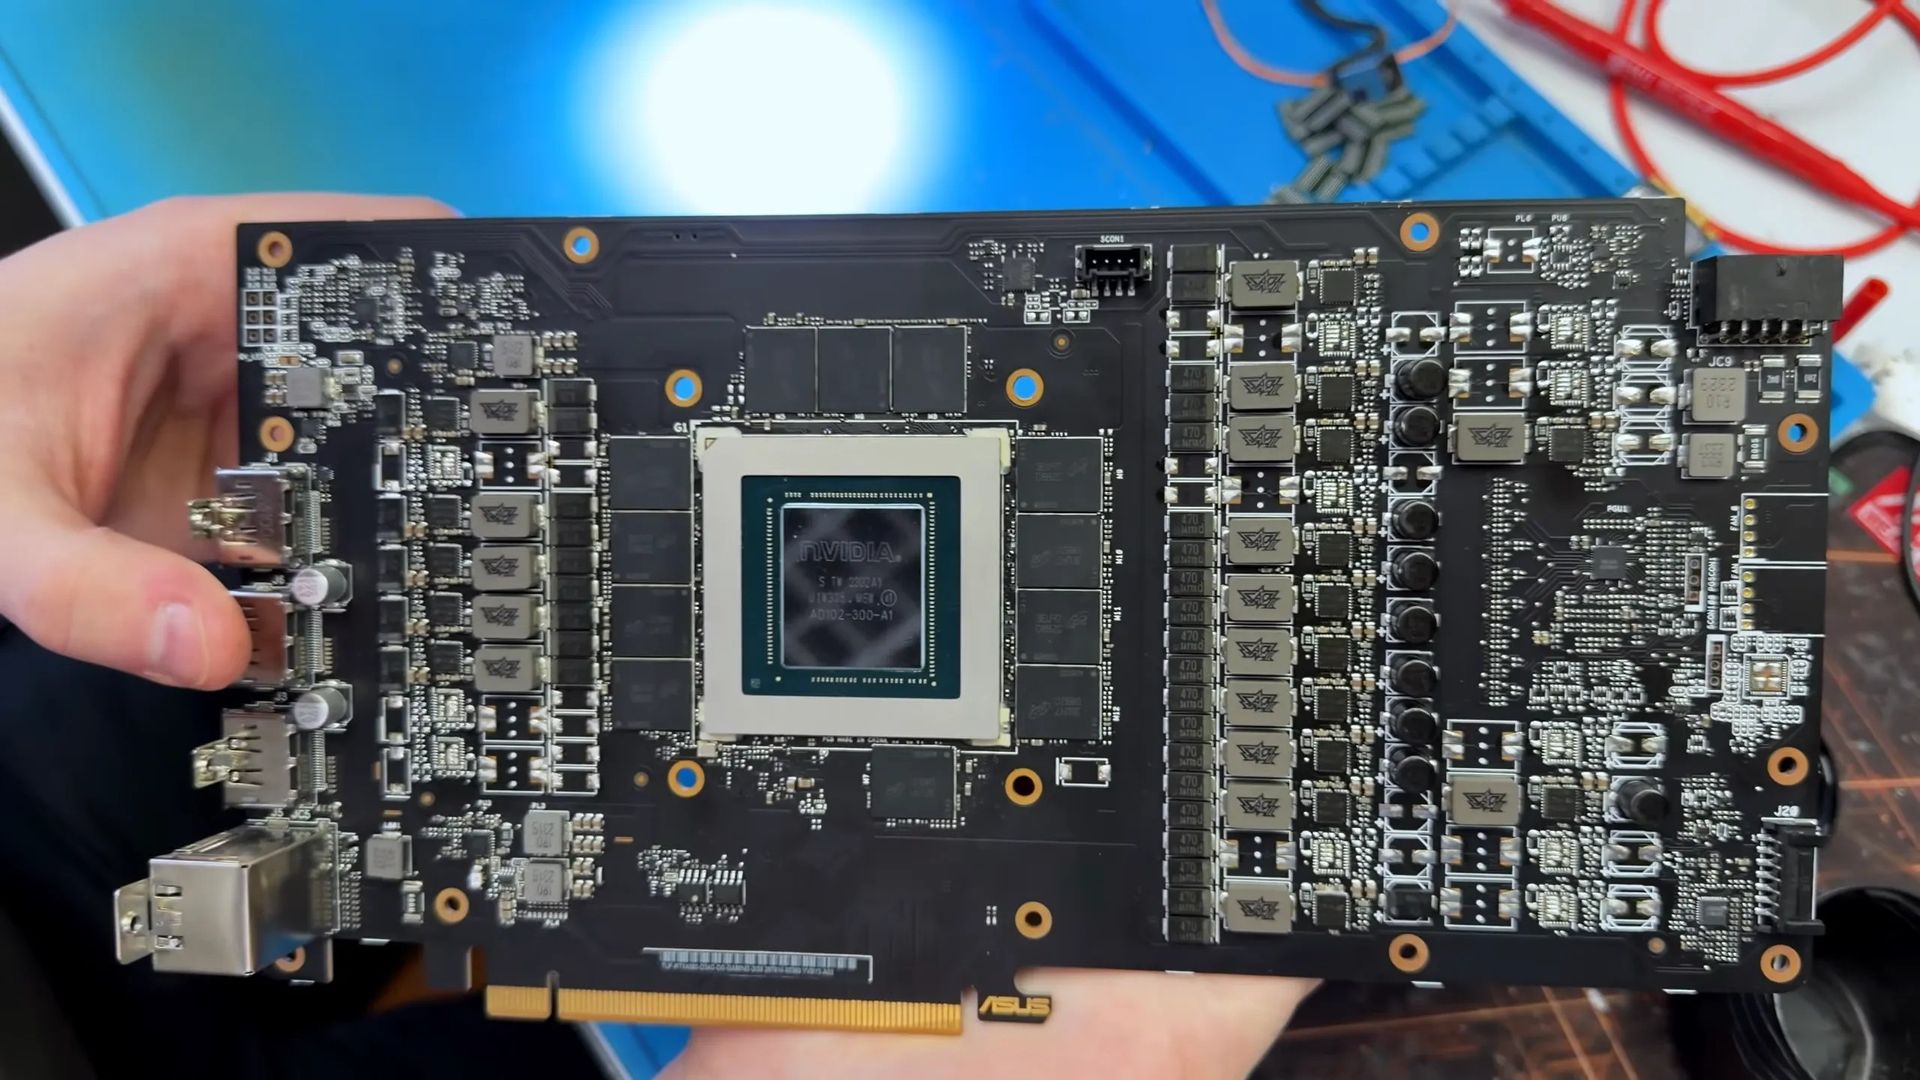
RTX 4090 'rotta' a 350 dollari: dentro una GPU falsa e memoria sostituita

RTX 4090 'rotta' a 350 dollari: dentro una GPU falsa e memoria sostituita

Un acquirente ha pagato 350 dollari per una RTX 4090 rotta, ma il tecnico ha scoperto una GPU falsa e memorie sostituite. La truffa, documentata da un riparatore russo, usa PCB dummy sofisticati. Per chi costruisce infrastrutture LLM on-premise, l'episodio mostra quanto il mercato secondario delle GPU ad alte prestazioni sia ormai un bersaglio per contraffattori, con ripercussioni su TCO, affidabilità delle pipeline e fiducia nei canali di approvvigionamento.

12 Oct #Hardware #LLM On-Premise #Fine-Tuning

📁 LLM 25

Beam di Reflection: ragionamento a token ridotti, memoria da 501 miliardi

Beam di Reflection: ragionamento a token ridotti, memoria da 501 miliardi

Reflection ha rilasciato Beam, LLM aperto con architettura MoE da 501 miliardi di parametri totali e 23 miliardi attivi. Supporta contesto da 1 milione di token e precisioni BF16, FP8 e NVFP4. La tesi è il ragionamento token-efficiente: circa un terzo dei token di inference rispetto ai modelli aperti leader. I benchmark mostrano risultati forti su coding e matematica, ma la memoria resta il nodo per il self-hosted.

16 Oct #Hardware #LLM On-Premise #DevOps
Ragionamento nascosto: l’approccio ibrido che dimezza i token degli LLM

Ragionamento nascosto: l’approccio ibrido che dimezza i token degli LLM

Un preprint di Stanford, Together AI, UIUC e Meta introduce i Hybrid Reasoning Agents: modelli che ragionano in modo interno e producono testo solo per tool e risposta finale. Nei test segnalati guadagnano circa il 10%, usano metà token, girano due volte più veloci e costano meno. Il vero cambiamento è strutturale: il ragionamento esce dal flusso testuale, con effetti su verificabilità, fiducia e TCO dell’inference.

16 Oct #Hardware #LLM On-Premise #DevOps
Tencent Hy-Memory-30B-A3B: perché 3B attivi contano più di 30B totali

Tencent Hy-Memory-30B-A3B: perché 3B attivi contano più di 30B totali

La scheda del modello Tencent Hy-Memory-30B-A3B accende il dibattito su un dato sfuggente: un'architettura con 3 miliardi di parametri attivi su 30 miliardi totali supererebbe Opus 5 in un test di memoria non specificato. Il punto non è il benchmark, ma il segnale strutturale per chi valuta deployment self-hosted: meno parametri attivi possono ridurre VRAM e costi di inference, senza rendere il modello più semplice da valutare.

16 Oct #Hardware #LLM On-Premise #DevOps
Qwen Flash Next: il quant Q2 GYRO-M sfida i team di ISTA Lab

Qwen Flash Next: il quant Q2 GYRO-M sfida i team di ISTA Lab

Un test empirico di tre giorni su GYRO-M, quantization Q2 del modello Qwen Flash Next, segnala stabilità paragonabile al q3 ISTA con dimensioni ridotte. Il progetto nasce da un singolo contributore e mostra tenuta su contesti lunghi, ma evidenzia criticità sui testi cirillici. Una novità che riapre il confronto su quantization, loop resistance e metriche di qualità per deployment locali.

16 Oct #Hardware #LLM On-Premise #DevOps
Benchmark saturi: nei transcript resta segnale utile

Benchmark saturi: nei transcript resta segnale utile

Quando più modelli raggiungono punteggi quasi perfetti, i benchmark perdono capacità di distinguerli. Uno studio mostra che le trascrizioni complete dei task, anche da benchmark saturi, conservano informazioni predittive. Il pairwise judging riduce l'errore di predizione di 5,3 volte rispetto ai soli punteggi. Il segnale però non sempre regge ai cambi di distribuzione: i primi modelli di reasoning del 2025 sono stati sottostimati.

16 Oct #LLM On-Premise #DevOps
Il bengalese smonta le certezze dei benchmark LLM in inglese

Il bengalese smonta le certezze dei benchmark LLM in inglese

Un benchmark zero-shot su otto LLM mostra che la qualità della summarization non si trasferisce dall'inglese al bengalese. GPT-5.6 Luna domina alcune metriche lessicali inglesi, ma LLaMA 3.3 70B ottiene i migliori ROUGE e BLEU bengalesi; Gemini 2.5 Flash primeggia in factuality. I ranking cambiano con la metrica: per le lingue a basse risorse serve un evaluation framework multilingue.

15 Oct #Hardware #LLM On-Premise #Fine-Tuning
Modello inverso: addestrare LLM al ragionamento senza CoT

Modello inverso: addestrare LLM al ragionamento senza CoT

Un gruppo di ricercatori usa un LLM 'inverso' per ricostruire le tracce di ragionamento partendo dalle sole risposte. Il modello, addestrato una volta, genera in modo offline i passaggi intermedi per dati prompt-risposta, evitando i rollout multipli del reinforcement learning. Su Qwen3-0.6B una singola distillazione raddoppia pass@1 sui prompt difficili; lo stesso modello inverso fa da verificatore e porta la selezione best-of-n su Countdown da 0.753 a 0.969.

15 Oct #Hardware #LLM On-Premise #Fine-Tuning
Il primo esame dell’artificialità: un C-test basato su LLM per la sovraintelligenza

Il primo esame dell’artificialità: un C-test basato su LLM per la sovraintelligenza

Un nuovo test usa Levin's Kt e i modelli linguistici come macchine di rappresentazione per generare item di difficoltà misurabile in bit, prima che umani o modelli di frontiera riescano a risolverli. Dodici LLM sono stati valutati su una prima batteria certificata, mostrando curve caratteristiche che declinano con la difficoltà fino a una regione di sovraintelligenza non ancora esplorata.

15 Oct #LLM On-Premise #DevOps
LiquidAI LFM2.5-24-A2B: performance robuste su AMD W7900 per LLM on-premise

LiquidAI LFM2.5-24-A2B: performance robuste su AMD W7900 per LLM on-premise

Un utente ha condiviso un'esperienza positiva con il modello LiquidAI LFM2.5-24-A2B (24B parametri), evidenziando performance elevate (~95 tps) su GPU AMD W7900. Il modello, che richiede 30GB di VRAM per la quantization Q8 con un contesto di 128k token, si dimostra affidabile per carichi di lavoro locali, suggerendo un potenziale significativo per deployment on-premise e una maggiore diversificazione hardware nell'inference LLM.

15 Oct #Hardware #LLM On-Premise #DevOps
Ling-3.1-flash: 560 miliardi di parametri, 25B attivi e contesto da 1 milione di token

Ling-3.1-flash: 560 miliardi di parametri, 25B attivi e contesto da 1 milione di token

Il modello inclusionAI Ling-3.1-flash appare su Hugging Face con 560 miliardi di parametri totali, 25 miliardi attivi per token e una context window da 1 milione di token. Una configurazione MoE che riduce il costo computazionale per token, ma sposta l'attenzione su memoria, VRAM e gestione della cache KV. Per deployment on-premise, il divario tra parametri totali e attivi impone scelte precise su quantization e distribuzione del carico.

14 Oct #Hardware #LLM On-Premise #DevOps
NVIDIA Nemotron Bolt 3.5 74B: MoE in 24 GB grazie alla quantization a 2 bit

NVIDIA Nemotron Bolt 3.5 74B: MoE in 24 GB grazie alla quantization a 2 bit

NVIDIA annuncia per il 15 ottobre Nemotron Bolt 3.5 74B A9B, un MoE da 74 miliardi di parametri (9 miliardi attivi) compresso in 24 GB con quantization a 2 bit e addestramento consapevole della quantization. L'obiettivo dichiarato è bilanciare velocità e intelligenza: più veloce dei modelli dense più diffusi e più brillante dei MoE con ingombro simile. Il 23 ottobre arriva Nemotron 3.5 Bolt E4B da 4 GB.

14 Oct #Hardware #LLM On-Premise
Open-weight cinesi a 7 mesi dai modelli USA: la trasparenza dei dati conta più del gap

Open-weight cinesi a 7 mesi dai modelli USA: la trasparenza dei dati conta più del gap

Un leaderboard open source aggrega 22.113 benchmark e mostra che i modelli open-weight cinesi sono a circa sette mesi dai modelli chiusi USA. La metodologia distingue 14.436 valutazioni indipendenti da 7.677 dichiarate dai laboratori. Per chi valuta deployment on-premise, il dato rilevante non è solo il gap prestazionale: open-weight significa possibilità di self-hosted, ma con costi di VRAM, quantization e TCO da valutare.

14 Oct #Hardware #LLM On-Premise #Fine-Tuning
DeepMind ha un filosofo residente: l’etica degli LLM diventa empirica

DeepMind ha un filosofo residente: l’etica degli LLM diventa empirica

Henry Shevlin resta a Cambridge ma ora passa l’80% del tempo in Google DeepMind come filosofo. In un colloquio con IEEE Spectrum, Shevlin lega creatività, slop, autonomia, relazioni e coscienza in un unico filo: il comportamento degli LLM cambia con contesto, prompt e temperatura. Per chi valuta deployment on-premise, il punto non è una checklist statica ma una valutazione comportamentale continua.

13 Oct #LLM On-Premise #DevOps
MiniCPM-V 4.7: il primo MoE open source con inference fluida on-device

MiniCPM-V 4.7: il primo MoE open source con inference fluida on-device

OpenBMB ha rilasciato MiniCPM-V 4.7, modello multimodale 35B-A3B e primo MoE della serie a girare fluidamente on-device. Con Lookahead Expert Scheduling, quantization layer-wise e speculative sampling, dichiara 13+ token/s su iPhone 17 Pro Max. Supporta iOS, Android, HarmonyOS e chip Rockchip, Houmo, Intel, AMD, Arm. Offre varianti GGUF, AWQ, GPTQ e FP8, oltre a framework come vLLM, llama.cpp e Ollama.

12 Oct #Hardware #LLM On-Premise #Fine-Tuning
Boole-1.7B: la quantization a 1 bit diventa un'opzione concreta per l'on-premise

Boole-1.7B: la quantization a 1 bit diventa un'opzione concreta per l'on-premise

Precision Numerics debutta con Boole-1.7B, versione a 1 bit di Qwen3-1.7B da 247 MB, 13,9 volte più piccola del BF16. Conserva l'85,9% del punteggio medio su dieci task, supera Bonsai-1.7B a 1 bit e quasi eguaglia la versione a 1,58 bit. Disponibile per demo locale nel browser e per serving con vLLM o llama.cpp. Un segnale per chi valuta deployment on-premise a basso footprint.

12 Oct #Hardware #LLM On-Premise #DevOps

📁 Frameworks 5

PRISM insegna ai sistemi multi-agente a scegliere la topologia giusta per ogni query

PRISM insegna ai sistemi multi-agente a scegliere la topologia giusta per ogni query

PRISM recupera un segnale per-query da corpora di grafi verificati che non hanno ranking. Un teacher legge un grafo sibling tramite un ramo low-rank zero-initialized; lo studente allinea i target decisionali su traiettorie auto-campionate. Su sei benchmark il metodo supera le baseline di progettazione topologica. L'effetto più interessante è sui costi di inference: meno interazioni superflue tra agenti, un vantaggio concreto per chi gestisce infrastrutture self-hosted.

16 Oct #Hardware #LLM On-Premise #Fine-Tuning
DeepUnfolding Agent: il controllo adattivo diventa un servizio esterno

DeepUnfolding Agent: il controllo adattivo diventa un servizio esterno

La piattaforma FastAPI proposta da DeepUnfolding Agent separa il controller adattivo dall'esecuzione di dominio. Gli executor registrano uno schema, inviano diagnostiche di round e ricevono azioni di controllo vincolate, con persistenza SQLite, deploy Docker e percorsi classici, quantistici e ibridi. I test citati coprono finanza, sanità, genomica, trasporti, simulazione quantistica rumorosa ed esecuzione su hardware IBM Quantum. Il risultato è un layer di controllo riutilizzabile, tracciabile e validabile a livello API.

16 Oct #Hardware #LLM On-Premise #Fine-Tuning
Mesa porta YOLOX con PyTorch sulle NPU: il driver open source avanza

Mesa porta YOLOX con PyTorch sulle NPU: il driver open source avanza

Lo stack open source Mesa estende il supporto NPU: il lavoro di Tomeu Vizoso introduce YOLOX via PyTorch, portando modelli di object detection su acceleratori neurali senza SDK proprietari. Il segnale strutturale è un driver condiviso che riduce lock-in, semplifica il deployment locale e sposta l’attenzione su TCO e sovranità dei dati. Per chi valuta edge e on-premise, la notizia conta più per il cambio di incentivi che per il singolo framework.

14 Oct #Hardware #LLM On-Premise #DevOps

📁 Market 1

📁 Altro 6

La scansione scontrini diventa on-device: un modello 0,8B sul telefono

La scansione scontrini diventa on-device: un modello 0,8B sul telefono

Uno sviluppatore ha creato un'app Android gratuita che usa un modello di visione da 0,8 miliardi di parametri per leggere foto di scontrini ed estrarre negozio, data, totale e voci singole in JSON. Il modello, sottoposto a fine-tuning su ricevute, gira sul telefono senza inviare dati a terzi. I modelli saranno open source e utilizzabili con un server OpenAI-compatibile. Un caso di inference on-device pensata per la sovranità dei dati.

12 Oct #LLM On-Premise #Fine-Tuning #DevOps
← 2026-W41 Tutte le notizie