Digest Settimanale

📖 AI-Radar · 2026-W40

28 September – 04 October 2026  ·  60 articoli pubblicati

📁 Altro 10

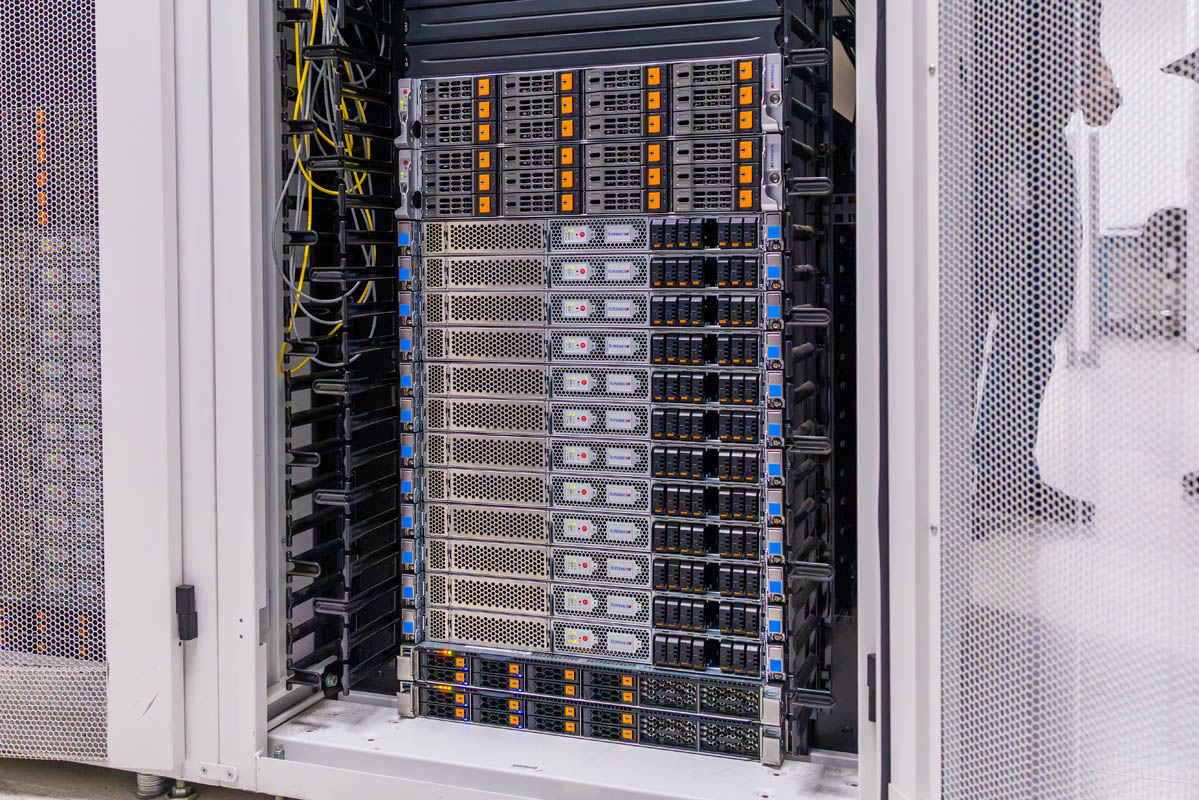
Due DGX Spark in casa: GLM 5.3 Flash gira in locale a velocità interattive

Due DGX Spark in casa: GLM 5.3 Flash gira in locale a velocità interattive

Un utente ha assemblato un setup di inference interamente locale con GLM 5.3 Flash su due DGX Spark, usando vLLM con parallelismo tensoriale a due vie. I numeri dichiarati: prefill a circa 1.500 token/s e decode a circa 40 token/s con 100mila token di contesto. Claude Code fa da scheletro con 260mila token. Coding, visione e comprensione 3D convincono; per l'autore il livello è ormai 'abbastanza buono' a casa.

04 Oct #Hardware #LLM On-Premise #DevOps
Google congela il bug bounty open source per l'ondata di segnalazioni AI

Google congela il bug bounty open source per l'ondata di segnalazioni AI

La decisione di Google di sospendere il programma di bug bounty per l'open source mette a nudo un problema strutturale: le segnalazioni generate da LLM aumentano il rumore e i costi di verifica, erodendo la fiducia nel processo. I ricercatori umani perdono visibilità e i manutentori ricevono meno segnalazioni utili. Per chi gestisce stack self-hosted su componenti open source, la vicenda segnala un rischio concreto nella capacità di individuare vulnerabilità reali.

04 Oct #LLM On-Premise #DevOps
Una nonprofit californiana porta OpenAI in tribunale per l'hack di Hugging Face

Una nonprofit californiana porta OpenAI in tribunale per l'hack di Hugging Face

Una nonprofit californiana ha citato in giudizio OpenAI per chiedere conto delle azioni dei suoi agenti dopo l'attacco a Hugging Face, un passo che la piattaforma colpita non ha compiuto. La vicenda sposta il confronto dalla risposta tecnica a un incidente alla responsabilità legale dei sistemi autonomi, con riflessi per chi valuta deployment on-premise e governance degli agenti.

29 Sep #Hardware #LLM On-Premise #DevOps

📁 LLM 14

AliceAI-80B-A3B: il fine-tuning locale inciampa sui dati, non sulle V100

AliceAI-80B-A3B: il fine-tuning locale inciampa sui dati, non sulle V100

Un progetto di fine-tuning locale di AliceAI-80B-A3B mostra i limiti del training on-premise: 5 milioni di token sintetici non bastano per un modello conversazionale generale. Su tre V100 da 32 GB, il checkpoint 1.0 alpha risponde ma è sottoadattato; il creatore accelera il generatore sintetico da 80 a 240 token/s e prepara un secondo dataset più ampio. Nessun rilascio del primo checkpoint, ma sftmill è open source.

04 Oct #Hardware #LLM On-Premise #Fine-Tuning
Apex-2: un MoE da 3,87B addestrato da zero con 86,5 miliardi di token

Apex-2: un MoE da 3,87B addestrato da zero con 86,5 miliardi di token

Un ricercatore ha addestrato Apex-2, un modello MoE decoder-only da 3,87 miliardi di parametri totali e 1,45 miliardi attivi per token, usando 86,5 miliardi di token e passando da uno a due GH200 con DiLoCo. Il checkpoint base raggiunge in HumanEval+ risultati paragonabili a Qwen2.5-1.5B nonostante un divario di dati enorme. Restano forti limiti su conoscenza, matematica e contesto.

04 Oct #Hardware #LLM On-Premise #Fine-Tuning
FrogNano-4B: il modello agentico per chi ha poche GPU

FrogNano-4B: il modello agentico per chi ha poche GPU

Microsoft ha rilasciato un modello da 4 miliardi di parametri derivato da Qwen3.5-4B, addestrato con reinforcement learning su ambienti SWE sintetici per il software engineering agentico. L'approccio senza distillazione comportamentale punta a ridurre la dipendenza da hardware costoso, ma introduce rischi concreti: patch errate o insicure anche quando i test passano.

03 Oct #Hardware #LLM On-Premise #DevOps
Qwen3.8-27B-Humanlike-Chat 2.0: il tono umano ora convive con tool call e istruzioni

Qwen3.8-27B-Humanlike-Chat 2.0: il tono umano ora convive con tool call e istruzioni

La seconda versione della LoRA Qwen3.8-27B-Humanlike-Chat corregge i limiti della v1: ora le tool call funzionano, il modello chiede dettagli mancanti e segue le istruzioni senza perdere il tono da messaggistica umana. L'addestramento usa distillation on-policy con due teacher. I benchmark mostrano progressi su When2Call e BFCL, ma calano leggermente le conoscenze. GGUFs quantizzati disponibili.

02 Oct #Hardware #LLM On-Premise #Fine-Tuning
Memoria a coda pesante negli agenti LLM: il segnale che riduce i token

Memoria a coda pesante negli agenti LLM: il segnale che riduce i token

Un audit mostra che gli agenti LLM concentrano i retrieval su un nucleo ristretto e lasciano gli stati rari in una coda lunga, dove gli errori di previsione si accumulano. Il controller CTWM assegna il budget del prompt con un solo esponente e riduce i token del 24,48% su LongMemEval a parità di accuratezza aggregata. Il risultato sposta l'attenzione dai soli costi per token alla distribuzione dell'uso della memoria.

02 Oct #LLM On-Premise #DevOps
AREX-2: agenti LLM che migliorano da soli, round dopo round

AREX-2: agenti LLM che migliorano da soli, round dopo round

AREX-2 esplora l'automiglioramento degli agenti LLM tramite riflessione e iterazioni a lungo orizzonte. Addestrato su traiettorie sintetiche di compiti di machine learning e programmazione algoritmica, basato su Qwen3.8-27B, ottiene 81.8 su MLE-bench Lite e 70.7 su Frontier-CS, con trasferimento a benchmark di ricerca come BrowseComp, HLE, GAIA e DeepSearchQA. I risultati migliorano con il budget di round.

01 Oct #Hardware #LLM On-Premise #DevOps
Google svela Gemini 4 Argon: benchmark da primato, ma accesso esterno rinviato

Google svela Gemini 4 Argon: benchmark da primato, ma accesso esterno rinviato

Google annuncia Gemini 4 Argon, modello di frontiera con prestazioni di vertice in coding, knowledge work e cybersecurity. Ma l'accesso esterno non è ancora disponibile: Argon è già in uso internamente, dove avrebbe fatto risparmiare 300 TiB di memoria e sta migrando oltre 800.000 righe di codice C/C++ a Rust nel kernel Zircon. Il benchmark DeepSWE v1.1 tocca il 77,9%, superando GPT-6 Astra, Fable 5.1 e Opus 5.5.

30 Sep #LLM On-Premise #DevOps
Ling-3.1-flash: 560B parametri, 25B attivi, contesto da 1M token

Ling-3.1-flash: 560B parametri, 25B attivi, contesto da 1M token

Secondo la segnalazione, Ling-3.1-flash combina 560 miliardi di parametri totali, 25 miliardi attivi per token e una finestra di contesto fino a un milione di token, con due settimane di prova gratuita e poi rilascio open source. Il profilo suggerisce un'architettura sparsa: calcolo ridotto per token, ma memoria ancora legata all'intero checkpoint. Un vincolo chiave per chi valuta deployment self-hosted e sovranità dei dati.

30 Sep #Hardware #LLM On-Premise #DevOps
Fine-tuning oltre il testo: DASA trasforma il gradiente nel dataset

Fine-tuning oltre il testo: DASA trasforma il gradiente nel dataset

DASA genera embedding sintetici dai gradienti di attivazione di un modello congelato, addestrando LLM senza passare da testo leggibile. I test su Llama e Qwen mostrano prestazioni simili o superiori ai dati testuali, con speedup fino a 4,9 volte rispetto a GRADMM. Per i deployment self-hosted cambia l'equilibrio tra cura dei dati, calcolo, portabilità e audit.

30 Sep

📁 Hardware 10

Driver open-source Intel Iris: indirizzamento a 64 bit più efficiente

Driver open-source Intel Iris: indirizzamento a 64 bit più efficiente

Il driver open-source Intel Iris Gallium3D per OpenGL ha ricevuto il supporto per una modalità di indirizzamento a 64 bit efficiente. La modifica arriva dopo l'annuncio della nuova modalità GPU a 64 bit per la grafica Nova Lake P. Per chi usa GPU Intel in contesti locali, il lavoro nel driver Mesa segnala una maturazione del supporto a lungo termine, con potenziali benefici per carichi che gestiscono buffer e memoria condivisa.

02 Oct #Hardware #LLM On-Premise #DevOps
Linux 7.4 abiliterà la NPU dei Ryzen AI Max 400: cosa cambia per l'on-premise

Linux 7.4 abiliterà la NPU dei Ryzen AI Max 400: cosa cambia per l'on-premise

La serie Ryzen AI Max 400 'Gorgon Halo' sta per arrivare sul mercato, ma il supporto Linux alla NPU era rimasto indietro. Una patch di enablement dovrebbe entrare nel kernel 7.4. Per chi valuta inference locale e self-hosted, il ritardo segnala un problema strutturale: hardware pronto, stack software upstream in affanno. L'analisi guarda a vincoli, incentivi e a chi beneficia della NPU su Linux.

30 Sep #Hardware #LLM On-Premise #DevOps
AMD spinge l'inference LLM in locale: Radeon iGPU fino al 23% più veloci con Linux 7.4

AMD spinge l'inference LLM in locale: Radeon iGPU fino al 23% più veloci con Linux 7.4

AMD introduce PerfOpt in Linux 7.4 per migliorare le prestazioni AI/LLM sulle Radeon integrate. I benchmark mostrano incrementi del 18-23% su hardware Ryzen, soprattutto entry-level. Un segnale per chi valuta l'inference locale: le iGPU diventano un'opzione più credibile per carichi leggeri, riducendo la dipendenza dal cloud e spostando il calcolo del TCO verso il self-hosted.

29 Sep #Hardware #LLM On-Premise #Fine-Tuning

📁 Frameworks 22

llama.cpp dimezza la memoria dell'indice per Qwen Flash Next

llama.cpp dimezza la memoria dell'indice per Qwen Flash Next

Una pull request nel repository llama.cpp introduce un'ottimizzazione che dimezza la memoria dell'indice di scoring per Qwen Flash Next. Il cambiamento, segnalato su Reddit, si traduce in un minore uso di VRAM durante l'inference. Per i deployment on-premise e self-hosted, dove la memoria GPU è spesso il vincolo principale, interventi di questo tipo abbassano la barriera hardware e rendono più sostenibile l'esecuzione locale dei modelli.

03 Oct #Hardware #LLM On-Premise
Helion in vLLM: il tuning dei GEMM diventa ricerca, non artigianato GPU

Helion in vLLM: il tuning dei GEMM diventa ricerca, non artigianato GPU

L'integrazione di Helion nel backend lineare di vLLM mostra che un solo kernel GEMM con autotuner ahead-of-time può coprire varianti specializzate e migliorare l'inference fino al 10% su Qwen3. Per chi gestisce LLM self-hosted, il segnale è duplice: si riduce la dipendenza da competenze CUDA profonde, ma si sposta il costo sul tuning offline e sulla governance delle configurazioni.

03 Oct
Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%

Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%

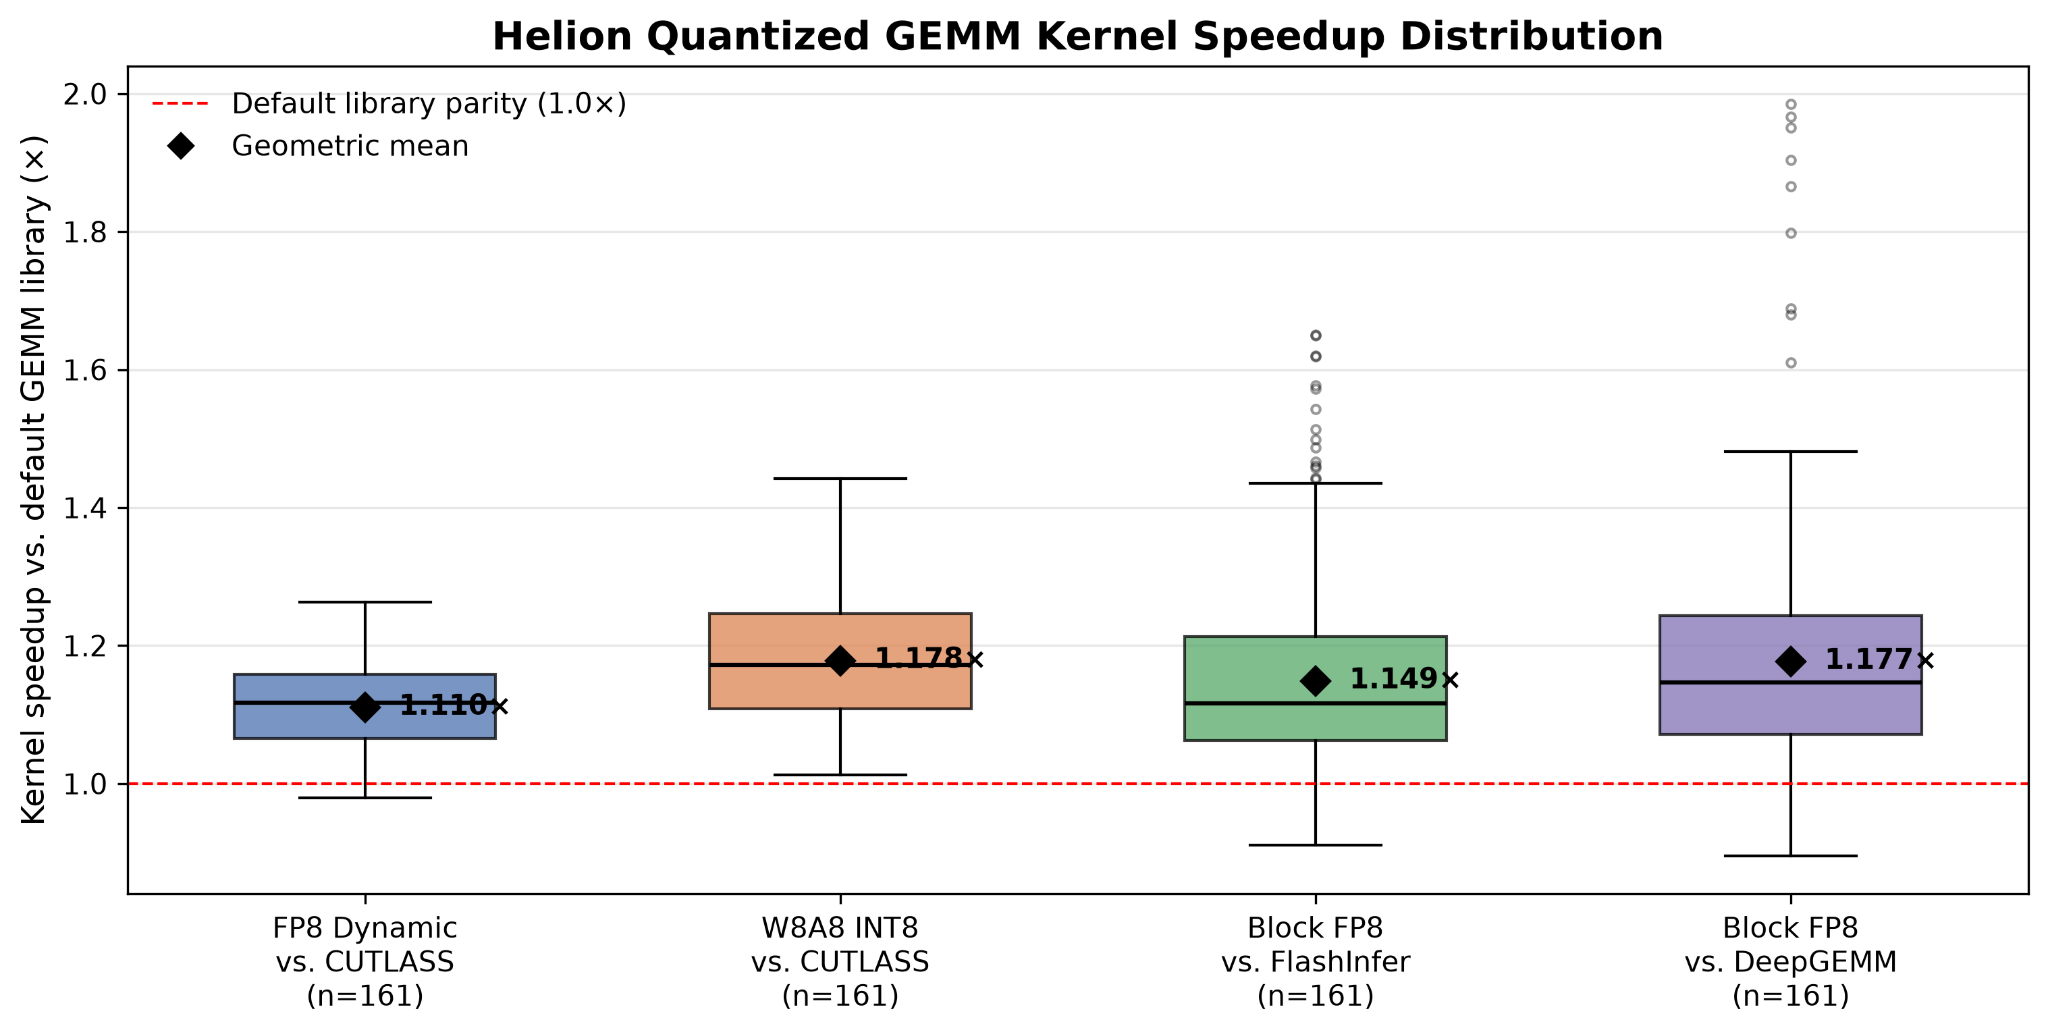
Red Hat e Meta hanno integrato Helion nel backend lineare di vLLM. Un'unica implementazione GEMM copre Standard, Split-K e Swap-AB, con autotuning per forma su GPU Hopper. Nei test su H100, i kernel superano CUTLASS, FlashInfer e DeepGEMM, con miglioramenti end-to-end oltre il 10% in alcuni workload. Il prezzo è il tuning ahead-of-time e la gestione dei config, che spingono verso un modello ibrido.

02 Oct #Hardware #LLM On-Premise #Fine-Tuning
La certificazione PyTorch diventa un percorso strutturato e operativo

La certificazione PyTorch diventa un percorso strutturato e operativo

Linux Foundation Education lancia un percorso che unisce quattro moduli self-paced all'esame PyTorch Certified Associate. Il programma, stimato in 15–17 ore, copre tensori e dispositivi, gestione dati, sviluppo di reti neurali e ottimizzazione con torch.compile, Automatic Mixed Precision e PyTorch Profiler. È pensato per chi ha esperienza iniziale in Python e machine learning e vuole una base strutturata prima di lavorare in produzione.

02 Oct #Hardware #LLM On-Premise #Fine-Tuning
llama.cpp aggiunge i Decision Models: l'inference locale cambia passo

llama.cpp aggiunge i Decision Models: l'inference locale cambia passo

Il progetto llama.cpp ha annunciato una nuova funzionalità denominata Decision Models, segnalando un ampliamento oltre la generazione testuale pura. Per chi gestisce Large Language Models in locale, la mossa suggerisce una maturazione verso output più azionabili, con ricadute su autonomia operativa, sovranità dei dati e TCO. L'articolo analizza cosa significa per gli stack self-hosted e perché il framework C++ resta un riferimento per l'inference on-premise.

02 Oct #Hardware #LLM On-Premise #DevOps
Causal world model per agenti LLM modulari: il grafo non basta

Causal world model per agenti LLM modulari: il grafo non basta

I world model osservazionali non bastano agli agenti LLM modulari: una sequenza non dice se il pagamento autorizza la spedizione o se un fattore nascosto spiega entrambi. Il framework FedCausalCompose mostra che l'errore interventistico si riduce con risposte a intervento e che le interfacce causali aiutano soprattutto con API strutturate; dialoghi e narrazioni le ignorano senza un'ancora di attenzione. Segnale: l'identificabilità statistica da sola non serve, serve una forma usabile al momento dell'azione.

02 Oct #LLM On-Premise #DevOps
RAG su FRAMES: 18 pipeline battute da un loop agentico. Reranker sotto accusa

RAG su FRAMES: 18 pipeline battute da un loop agentico. Reranker sotto accusa

Un benchmark su 824 domande multi-hop di FRAMES mette a confronto 18 pipeline RAG e un loop agentico. La migliore pipeline arriva al 78,9%, l’agente al 92,7%. Il dato più scomodo riguarda il reranking: un modello piccolo fa perdere 9 punti di accuratezza, uno grande non aiuta quasi. I modelli inoltre riempiono i vuoti dalla memoria, citando documenti mai letti. Per chi progetta stack RAG, serve una verifica end-to-end e un controllo sulle citazioni.

01 Oct #LLM On-Premise #Fine-Tuning #RAG
Qt Creator 21 beta accende l’AI di default: cosa cambia per chi sviluppa in locale

Qt Creator 21 beta accende l’AI di default: cosa cambia per chi sviluppa in locale

Qt Creator 21 beta rende più visibile l’integrazione AI nell’IDE per C++, Python e JavaScript. Il passaggio a funzionalità abilitate di default segnala una normalizzazione dell’assistenza automatica nel ciclo di sviluppo. Per team che operano in ambienti self-hosted, la novità sposta l’attenzione dal se aggiungere l’AI al come governarla. Nessun dettaglio nella fonte su modelli o endpoint, ma il default è già un segnale strutturale.

01 Oct #LLM On-Premise
KDE Plasma 6.8 spegne X11: a trent'anni il desktop Linux si divide

KDE Plasma 6.8 spegne X11: a trent'anni il desktop Linux si divide

Plasma 6.8, atteso per il 14 ottobre, è il primo KDE senza sessione desktop X11 nativa: si gira su Wayland e lascia le app X11 a XWayland. La beta porta avanti il tema Oxygen e il motore Union, mentre Klassik ricrea KDE 3 su Qt 6. Intanto Trinity, Sonic, MiDesktop e Katana presidiano versioni storiche, segno di una domanda di controllo e compatibilità che va oltre la nostalgia.

30 Sep #LLM On-Premise #DevOps
Sieve e Sage: distinguere il rumore dall’assenza di prove nei RALM

Sieve e Sage: distinguere il rumore dall’assenza di prove nei RALM

Un framework scompone i fallimenti del retrieval in due stati: non rispondibile e distratto. Un modulo leggero, Sieve, filtra i documenti rumorosi prima di chiamare il LLM costoso, Sage. Nei test, l’accuratezza sale fino a 69,4 punti percentuali e il Macro-F1 di 55,2 punti rispetto alle baseline a singolo stadio, con speedup fino a 1,99x. Per pipeline on-premise, meno chiamate di inference costose e maggiore controllo sul TCO.

30 Sep #LLM On-Premise #DevOps #RAG

📁 Market 2

Contrabbando di chip Nvidia in Cina da 300 milioni: arrestato un CEO tech

Contrabbando di chip Nvidia in Cina da 300 milioni: arrestato un CEO tech

Il Dipartimento di Giustizia Usa ha arrestato il CEO di Earthmade Computer, Greg Lui, accusato di aver contrabbandato in Cina server con chip Nvidia A100 e H100 per oltre 300 milioni di dollari, usando documenti falsi e transiti da Malesia e Singapore. I chip, pur non essendo i più recenti, possono addestrare Large Language Models. Il caso segnala come i controlli all'esportazione spingano il calcolo AI verso catene opache.

02 Oct #Hardware #LLM On-Premise #DevOps
Open LLM, il ritardo americano e l'ossessione per gli azionisti

Open LLM, il ritardo americano e l'ossessione per gli azionisti

Un post su Reddit accende il dibattito sul ritardo americano negli LLM aperti. La tesi dell'autore: negli Stati Uniti il capitale conta più della tecnicia, come sintetizza il commento più votato sul valore per gli azionisti. Per chi valuta stack locali e sovranità dei dati, il confronto tra ecosistemi aperti cinesi e offerta API chiusa americana ridisegna incentivi, TCO e lock-in.

02 Oct #Hardware #LLM On-Premise #DevOps

📁 OnPremise 1

BIG-IP Next per Kubernetes: l'efficienza AI si sposta dalla GPU alla rete

BIG-IP Next per Kubernetes: l'efficienza AI si sposta dalla GPU alla rete

Il test F5 su BIG-IP Next for Kubernetes mostra che lo stesso cluster GPU può rendere più del triplo agendo su bilanciamento e instradamento del traffico. Per i deployment on-premise l'efficienza per nodo diventa centrale per il TCO; il rischio è legare l'ottimizzazione a uno stack proprietario. AI-RADAR analizza le implicazioni per chi valuta infrastrutture locali, tra capacità inutilizzata e dipendenza tecnica.

02 Oct

📁 General 1

← 2026-W39 Tutte le notizie 2026-W41 →