Hardware per LLM Locali
Benchmark, guide alle GPU e build workstation per la sovranità dei dati.
Due numeri decidono quasi tutto nell'hardware per LLM locali: la VRAM (se il modello entra)
e la banda di memoria (i tuoi token/sec — la generazione single-user fa scorrere l'intero modello nella GPU
a ogni token, quindi i GB/s contano più dei TFLOPS). La regola pratica:
VRAM ≈ parametri(B) × 0,55 × 1,15 a 4-bit — un 34B entra in una scheda da 24GB, un 70B vuole 48GB.
I contesti lunghi aggiungono la KV-cache, che a 100k+ token può rivaleggiare coi pesi.
Le fasce pratiche: 24GB (RTX 3090 usata / 4090 — il punto di valore, esegue 7–34B), 32GB (RTX 5090 — l'inferenza consumer più veloce), 48GB (classe RTX A6000 o doppia 24GB — la fascia dei 70B), 80GB+ (schede datacenter — contesto lungo, 8-bit, training). Apple Silicon gioca un'altra partita: un'enorme memoria unificata contiene modelli che nessuna GPU consumer regge, a velocità inferiori.
Riferimenti approfonditi: guida all'acquisto GPU · matematica del sizing VRAM · Hardware Matrix · quantizzazione. Qui sotto: l'ultima intelligence hardware dal radar.

NVIDIA e il 4B BF16: il peso specifico dell'inference locale
Un modello da 4 miliardi di parametri in precisione BF16 firmato NVIDIA Nemotron Labs appare su Hugging Face. Non è la dimensione a contare, ma il...

ORL spinge i diffusion LLM a 2.788 token/s su una RTX 5090
Il progetto ORL (On-Policy Residual Learning) promette di accelerare i diffusion LLM senza sacrificare la qualità. Su una singola RTX 5090 il team...

Beam di Reflection: ragionamento a token ridotti, memoria da 501 miliardi
Reflection ha rilasciato Beam, LLM aperto con architettura MoE da 501 miliardi di parametri totali e 23 miliardi attivi. Supporta contesto da 1...

Ragionamento nascosto: l’approccio ibrido che dimezza i token degli LLM
Un preprint di Stanford, Together AI, UIUC e Meta introduce i Hybrid Reasoning Agents: modelli che ragionano in modo interno e producono testo...

Tencent Hy-Memory-30B-A3B: perché 3B attivi contano più di 30B totali
La scheda del modello Tencent Hy-Memory-30B-A3B accende il dibattito su un dato sfuggente: un'architettura con 3 miliardi di parametri attivi su...
Qwen Flash Next: il quant Q2 GYRO-M sfida i team di ISTA Lab
Un test empirico di tre giorni su GYRO-M, quantization Q2 del modello Qwen Flash Next, segnala stabilità paragonabile al q3 ISTA con dimensioni...
Intel pubblica LLM-Scaler-vLLM PV 1.5: stack Docker per LLM su GPU Arc
Gli ingegneri software di Intel hanno rilasciato LLM-Scaler-vLLM PV 1.5, uno stack Docker pensato per semplificare l'inference di LLM su hardware...
Sovranità open source: il lavoro noioso che la rende concreta
Al Summit Europe l'attenzione va a GPU e AI, ma la parte più concreta viene dai piani di conformità CRA, metriche OSPO e obiettivi di migrazione...
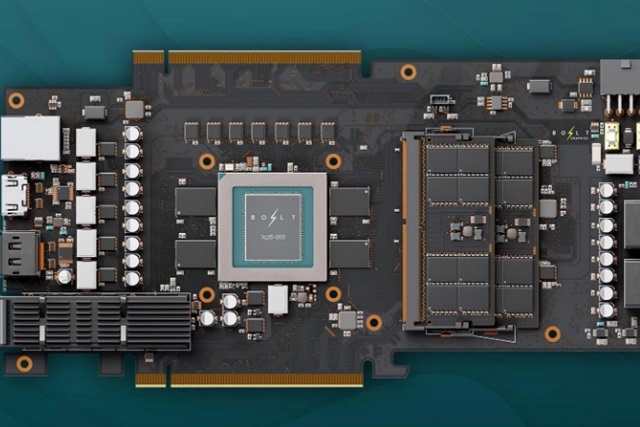
Bolt Graphics cerca 100 milioni di dollari per sfidare Nvidia e AMD con la GPU Zeus
Bolt Graphics cerca 100 milioni di dollari per sviluppare Zeus, una GPU che punta a sfidare Nvidia e AMD oltre i soli carichi AI. La fonte non...

PRISM insegna ai sistemi multi-agente a scegliere la topologia giusta per ogni query
PRISM recupera un segnale per-query da corpora di grafi verificati che non hanno ranking. Un teacher legge un grafo sibling tramite un ramo...
DeepUnfolding Agent: il controllo adattivo diventa un servizio esterno
La piattaforma FastAPI proposta da DeepUnfolding Agent separa il controller adattivo dall'esecuzione di dominio. Gli executor registrano uno...
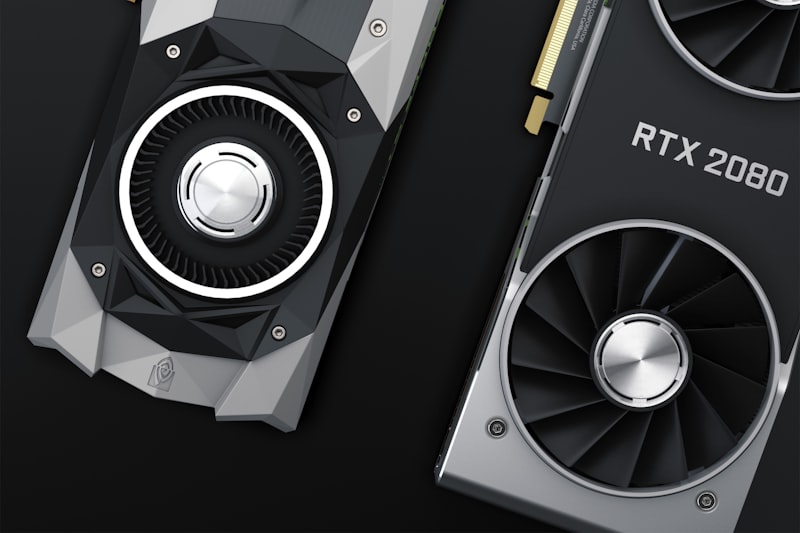
DeepSeek-V4-Flash su 4 Radeon AI PRO R9700: la modalità da 79 tok/s funziona
Un test con quattro Radeon AI PRO R9700 reali mostra che il motore affinity gestisce la configurazione multi-GPU senza output degeneri. La...

Meta apre i pesi di Muse Spark Open: 816B parametri e contesto da 1M token
Meta rilascia i pesi di Muse Spark Open, modello da 816 miliardi di parametri totali e 42 miliardi attivi con finestra da 1M token. L'annuncio...

Nemotron 3.5 Bolt: un VLM da 74B compresso in 24 GB per l'on-premise
NVIDIA descrive Nemotron 3.5 Bolt come modello vision-language per task agentici locali: 74B parametri totali, 9B attivi, quantization nativa a 2...
RTX 5060 Ti a $1.292 in Giappone: il Black Friday delle GPU è già un test
La RTX 5060 Ti da 16 GB tocca 1.292 dollari in Giappone con aumenti fino al 144%; la RTX 5080 supera i 2.400. Più che un problema di gaming, è il...
GNOME Mutter migliora il damage tracking per le GPU secondarie
Un ritocco nel compositor di GNOME 52 limita le copie inutili tra le GPU nei portatili ibridi. Meno spreco di banda e batteria, con un effetto...
Microsoft e il modello locale da 137 miliardi di parametri: la mossa per il codice on-premise
Microsoft AI ha sviluppato una versione locale di MAI Code 1.1 Flash, modello di coding ottimizzato con architettura mixture-of-experts: 137...
Mr.Chatterbox-2.7B-Chat: un LLM addestrato da zero sui testi vittoriani
Presentato nella community da u/centerstate, Mr.Chatterbox-2.7B-Chat è un checkpoint pre-addestrato e rifinito con fine-tuning su testi vittoriani...

Il bengalese smonta le certezze dei benchmark LLM in inglese
Un benchmark zero-shot su otto LLM mostra che la qualità della summarization non si trasferisce dall'inglese al bengalese. GPT-5.6 Luna domina...
Modello inverso: addestrare LLM al ragionamento senza CoT
Un gruppo di ricercatori usa un LLM 'inverso' per ricostruire le tracce di ragionamento partendo dalle sole risposte. Il modello, addestrato una...
LiquidAI LFM2.5-24-A2B: performance robuste su AMD W7900 per LLM on-premise
Un utente ha condiviso un'esperienza positiva con il modello LiquidAI LFM2.5-24-A2B (24B parametri), evidenziando performance elevate (~95 tps) su...
Ling-3.1-flash: 560 miliardi di parametri, 25B attivi e contesto da 1 milione di token
Il modello inclusionAI Ling-3.1-flash appare su Hugging Face con 560 miliardi di parametri totali, 25 miliardi attivi per token e una context...
NVIDIA Nemotron Bolt 3.5 74B: MoE in 24 GB grazie alla quantization a 2 bit
NVIDIA annuncia per il 15 ottobre Nemotron Bolt 3.5 74B A9B, un MoE da 74 miliardi di parametri (9 miliardi attivi) compresso in 24 GB con...
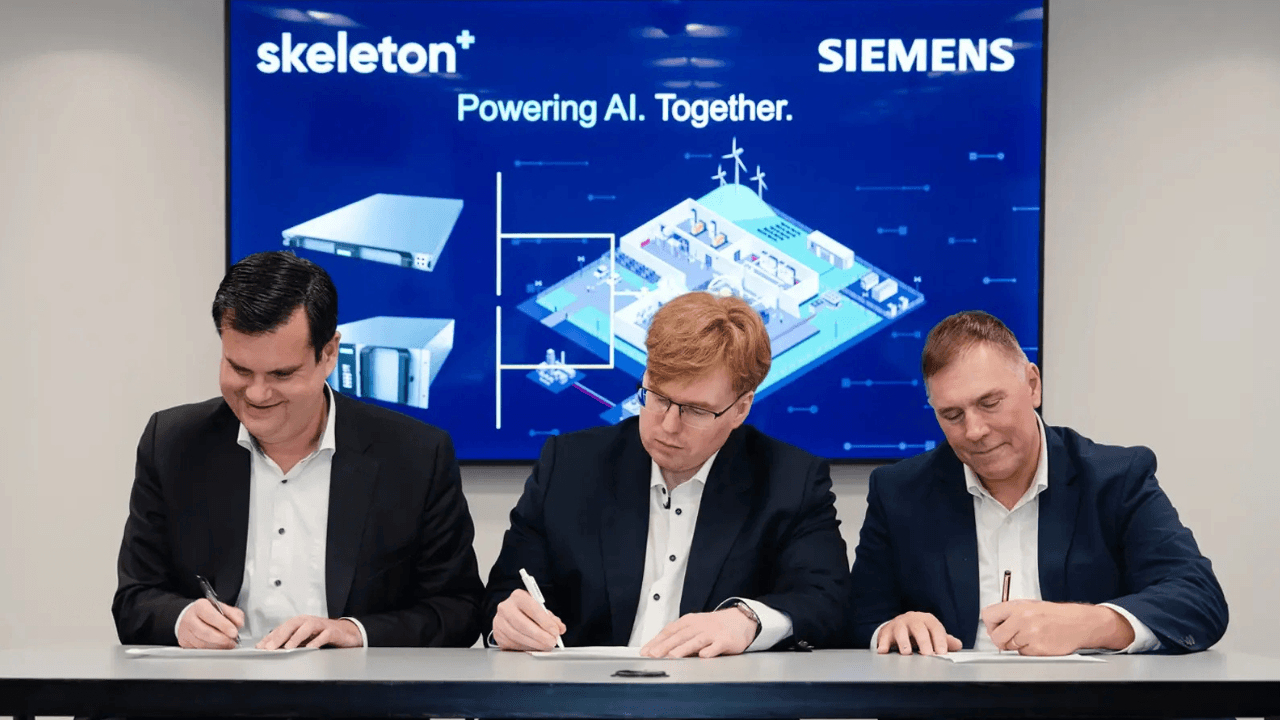
Skeleton supera 1 miliardo con Siemens: l'energia diventa il collo di bottiglia AI
Siemens investe in Skeleton, portando la valutazione sopra il miliardo. Obiettivo: produzione USA e R&D in Silicon Valley per sistemi di...
Open-weight cinesi a 7 mesi dai modelli USA: la trasparenza dei dati conta più del gap
Un leaderboard open source aggrega 22.113 benchmark e mostra che i modelli open-weight cinesi sono a circa sette mesi dai modelli chiusi USA. La...
Apple studia come trasformare i Mac inattivi in una cloud GPU virtuale con 'Minions'
Secondo il titolo della fonte, un gruppo di ricercatori Apple ha lavorato a un progetto chiamato Minions per aggregare Mac inattivi in una cloud...
51 lab offline per imparare l'AI dai neuroni agli agenti
Un'app offline propone 51 laboratori pratici per capire come funziona l'AI: dai neuroni e la discesa del gradiente fino a RAG, agenti,...
Mesa porta YOLOX con PyTorch sulle NPU: il driver open source avanza
Lo stack open source Mesa estende il supporto NPU: il lavoro di Tomeu Vizoso introduce YOLOX via PyTorch, portando modelli di object detection su...

Una PS5 jailbroken esegue Qwen 27B a 20 token/s: segnale per il self-hosting
Una PS5 sbloccata esegue Qwen 27B a circa 20 token/s sulla GPU della console. L'esperimento, emerso su Reddit, mostra come hardware consumer con...
LiquidAI LFM2.5-24B-A2B: 24B di parametri, 2B attivi per l'on-device
LiquidAI ha presentato LFM2.5-24B-A2B, un modello di ragionamento da 24 miliardi di parametri totali e 2,45 miliardi attivi. Pensato per agenti...
Cerchi notizie generali sull'AI?
< AI-RADAR MAIN