🏷️ LLM On-Premise
60 articoli con questo tag · tutti i tag

LLM
Qwen 3.8 Flash Next: il PLE in FP8 cambia le carte in locale
2026-10-17

LLM
DeepSeek V4.1 Flash su Hugging Face: il self-hosting torna sotto i riflettori
2026-10-17

LLM
NVIDIA e il 4B BF16: il peso specifico dell'inference locale
2026-10-17

Hardware
ORL spinge i diffusion LLM a 2.788 token/s su una RTX 5090
2026-10-16

LLM
Beam di Reflection: ragionamento a token ridotti, memoria da 501 miliardi
2026-10-16
LLM
Ragionamento nascosto: l’approccio ibrido che dimezza i token degli LLM
2026-10-16

LLM
Tencent Hy-Memory-30B-A3B: perché 3B attivi contano più di 30B totali
2026-10-16
LLM
Qwen Flash Next: il quant Q2 GYRO-M sfida i team di ISTA Lab
2026-10-16
Frameworks
Intel pubblica LLM-Scaler-vLLM PV 1.5: stack Docker per LLM su GPU Arc
2026-10-16
Hardware
Sovranità open source: il lavoro noioso che la rende concreta
2026-10-16
Hardware
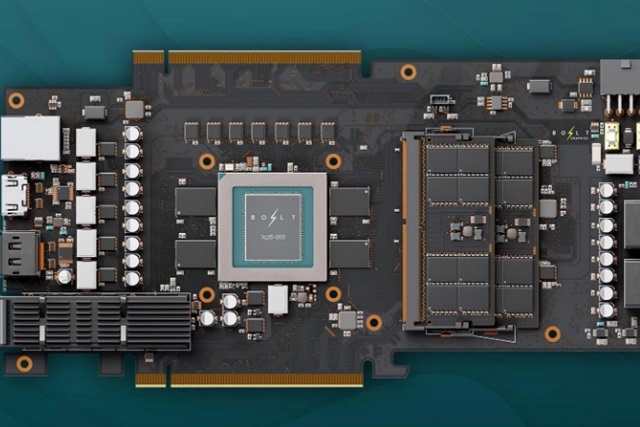
Bolt Graphics cerca 100 milioni di dollari per sfidare Nvidia e AMD con la GPU Zeus
2026-10-16

Frameworks
PRISM insegna ai sistemi multi-agente a scegliere la topologia giusta per ogni query
2026-10-16
Frameworks
DeepUnfolding Agent: il controllo adattivo diventa un servizio esterno
2026-10-16

LLM
Benchmark saturi: nei transcript resta segnale utile
2026-10-16
Hardware
DeepSeek-V4-Flash su 4 Radeon AI PRO R9700: la modalità da 79 tok/s funziona
2026-10-16

LLM
Meta apre i pesi di Muse Spark Open: 816B parametri e contesto da 1M token
2026-10-15
LLM
Nemotron 3.5 Bolt: un VLM da 74B compresso in 24 GB per l'on-premise
2026-10-15
Market
RTX 5060 Ti a $1.292 in Giappone: il Black Friday delle GPU è già un test
2026-10-15
Hardware
GNOME Mutter migliora il damage tracking per le GPU secondarie
2026-10-15
LLM
Microsoft e il modello locale da 137 miliardi di parametri: la mossa per il codice on-premise
2026-10-15
LLM
Mr.Chatterbox-2.7B-Chat: un LLM addestrato da zero sui testi vittoriani
2026-10-15

LLM
Il bengalese smonta le certezze dei benchmark LLM in inglese
2026-10-15
OnPremise
Voice agent e recupero crediti: la conformità diventa una specifica
2026-10-15
LLM
Modello inverso: addestrare LLM al ragionamento senza CoT
2026-10-15
LLM
Lotus: prevedere il futuro per comprendere le serie temporali
2026-10-15
LLM
Il primo esame dell’artificialità: un C-test basato su LLM per la sovraintelligenza
2026-10-15
LLM
LiquidAI LFM2.5-24-A2B: performance robuste su AMD W7900 per LLM on-premise
2026-10-15
LLM
Ling-3.1-flash: 560 miliardi di parametri, 25B attivi e contesto da 1 milione di token
2026-10-14
LLM
NVIDIA Nemotron Bolt 3.5 74B: MoE in 24 GB grazie alla quantization a 2 bit
2026-10-14
Altro
Skeleton supera 1 miliardo con Siemens: l'energia diventa il collo di bottiglia AI
2026-10-14
LLM
Open-weight cinesi a 7 mesi dai modelli USA: la trasparenza dei dati conta più del gap
2026-10-14
Altro
Apple studia come trasformare i Mac inattivi in una cloud GPU virtuale con 'Minions'
2026-10-14
LLM
51 lab offline per imparare l'AI dai neuroni agli agenti
2026-10-14
Frameworks
Mesa porta YOLOX con PyTorch sulle NPU: il driver open source avanza
2026-10-14

Hardware
Una PS5 jailbroken esegue Qwen 27B a 20 token/s: segnale per il self-hosting
2026-10-13
Altro
Il kernel Linux valuta di eliminare il tag Assisted-by per le patch AI/LLM
2026-10-13

LLM
DeepMind ha un filosofo residente: l’etica degli LLM diventa empirica
2026-10-13
Hardware
Reverse engineering CUDA, la sfida ironica di un utente AMD
2026-10-13
Hardware
Intel Crescent Island diventa D-Series: fino a 480 GB di LPDDR5X
2026-10-12
Hardware
Da Crescent Island alla serie D: Intel punta sull’inference aziendale
2026-10-12
Altro
Nel 2030 il cluster GPU in casa sarà come un'arma: la provocazione che dice molto
2026-10-12
Hardware
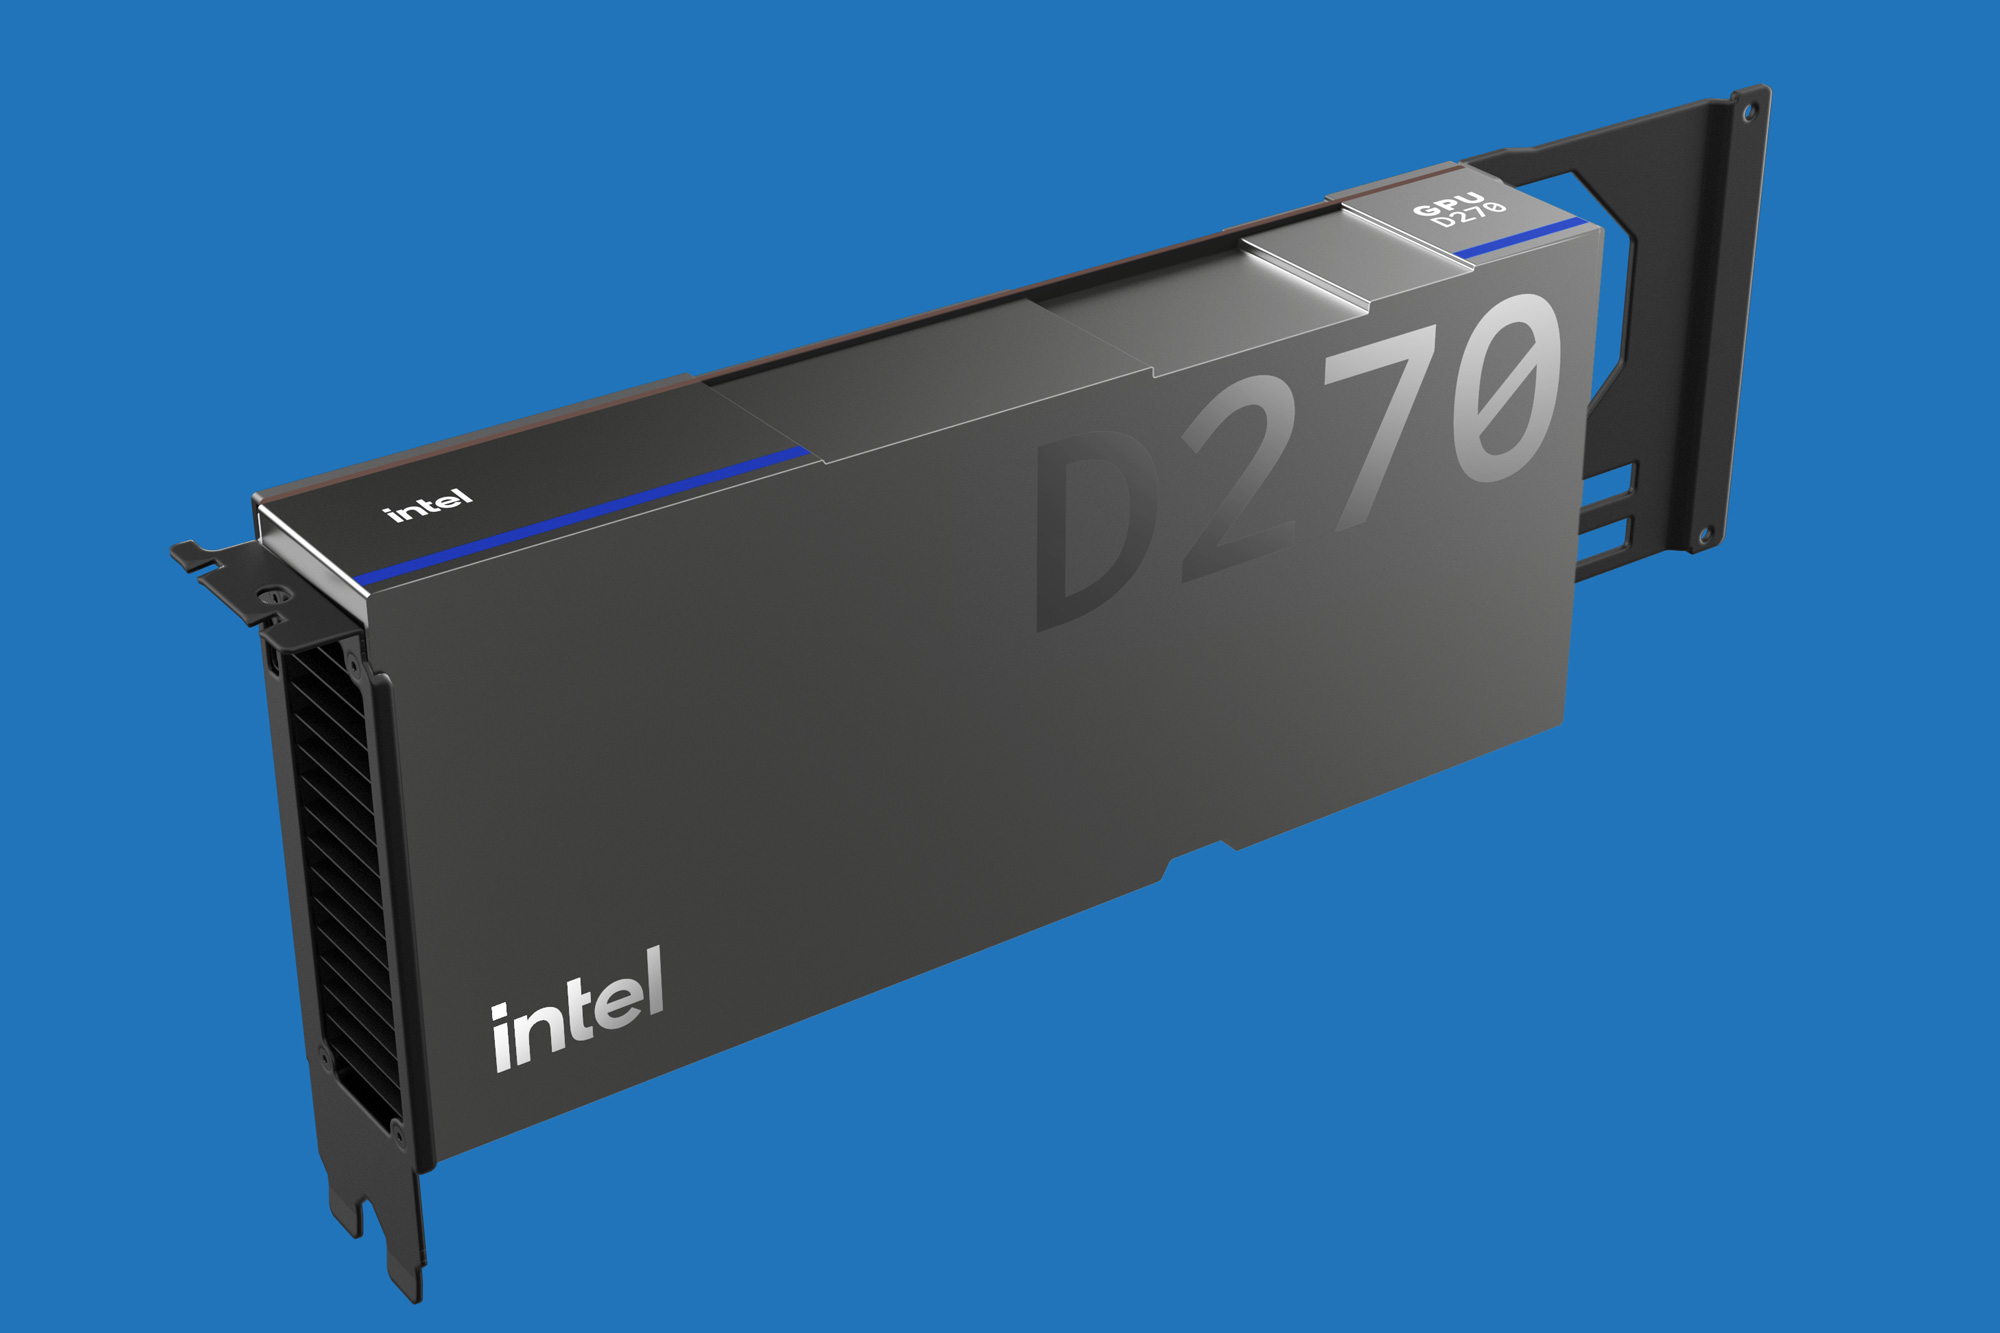
Intel D-Series: la D270 sceglie l’inference con FP8 e 1,5 TB/s
2026-10-12
LLM
MiniCPM-V 4.7: il primo MoE open source con inference fluida on-device
2026-10-12
LLM
Boole-1.7B: la quantization a 1 bit diventa un'opzione concreta per l'on-premise
2026-10-12
Frameworks
ROCm 10 contro Rusticl su Strix Halo: la partita open source dei driver
2026-10-12
Hardware
RTX 5080 da 24 GB: un rumor del 2027 che sposta gli equilibri on-premise
2026-10-12
Hardware
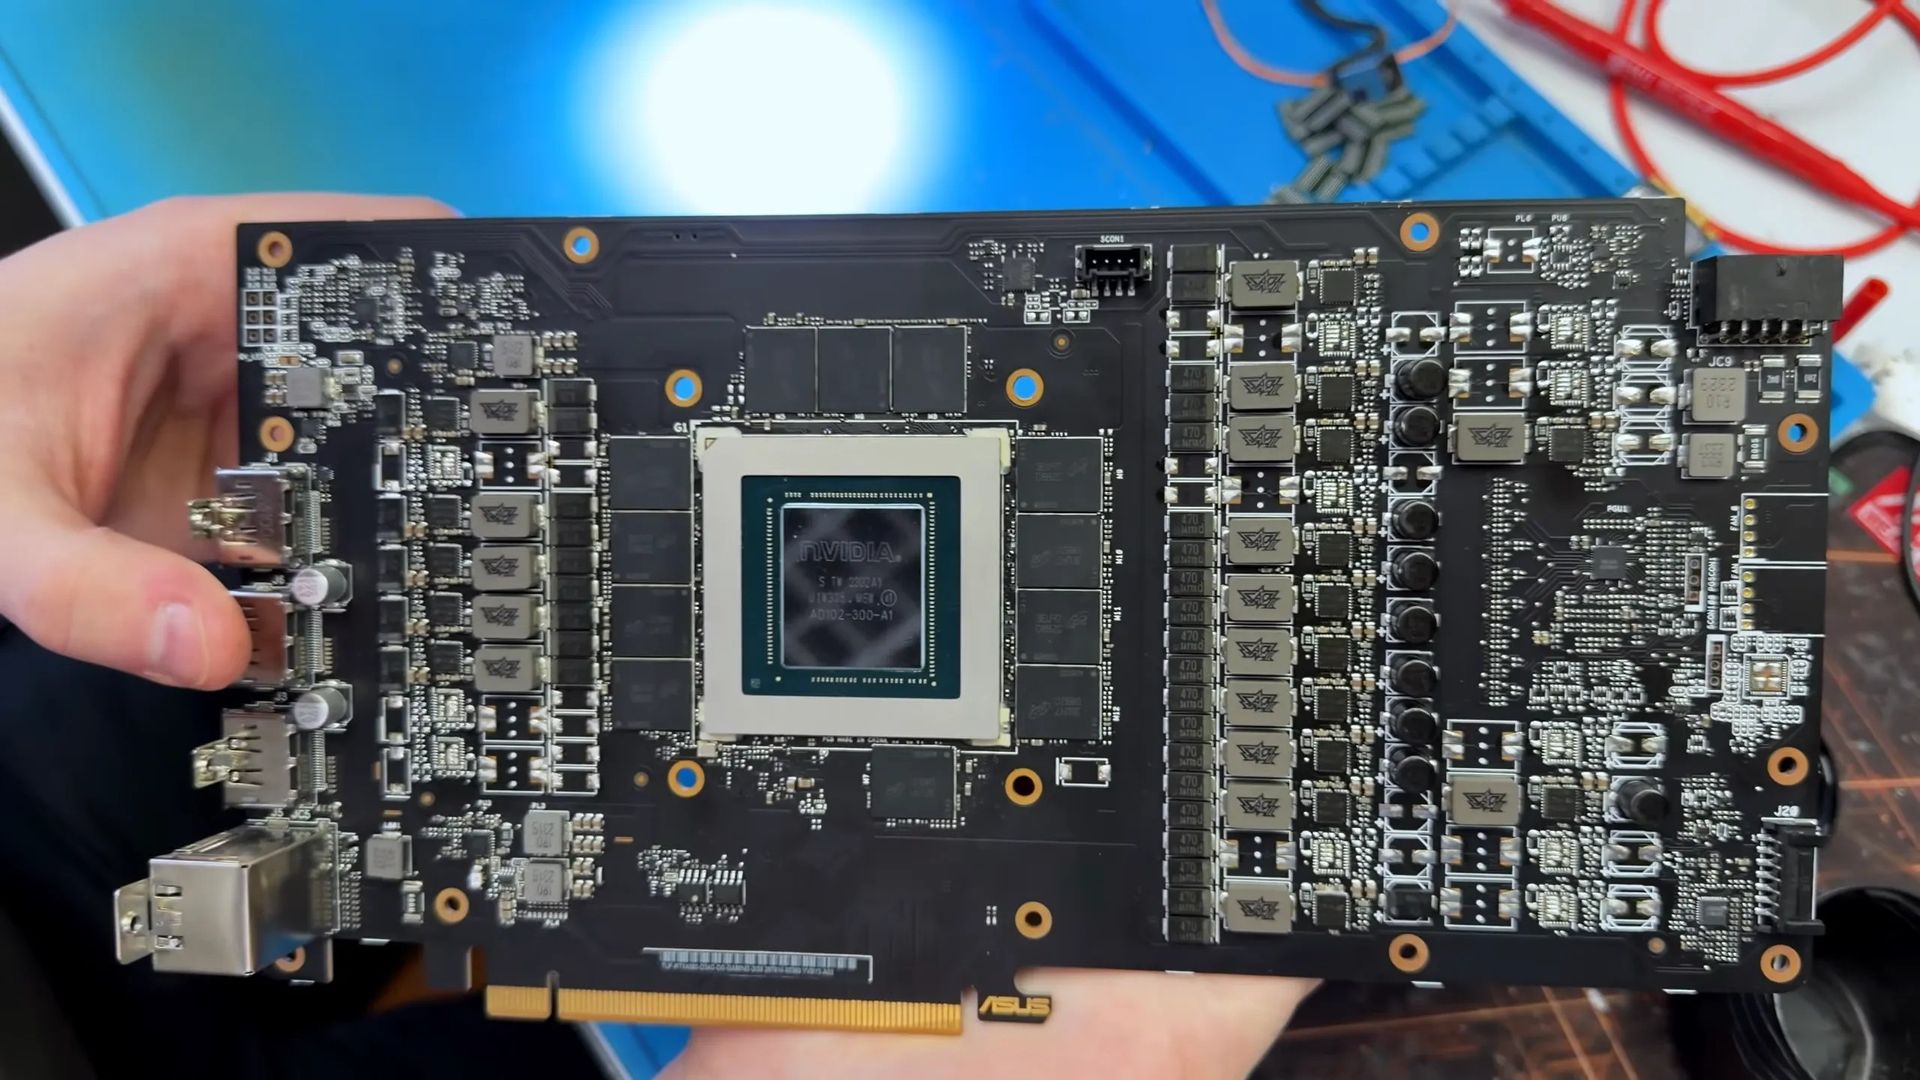
RTX 4090 'rotta' a 350 dollari: dentro una GPU falsa e memoria sostituita
2026-10-12
Altro
Strata: build from source e l'enigma della documentazione mancante
2026-10-12
Hardware
Biren BR20X: sistemi AI da 1.024 chip, ma le restrizioni USA colpiscono il cloud
2026-10-12
Altro
La scansione scontrini diventa on-device: un modello 0,8B sul telefono
2026-10-12
LLM
AutoIndexer: quando il modello riscrive il proprio output come in un editor
2026-10-12
LLM
Kairos: ottimizzazione locale di un modello byte-level, ma la generalizzazione resta aperta
2026-10-12
LLM
AIQ, quando la compressione degli LLM cambia base matematica
2026-10-12
Altro
OpenMed 3.0: AI clinica on-premise che blinda la sovranità dei dati sanitari
2026-10-12
LLM
LLM locali su 10-16GB di VRAM: la classifica e i compromessi reali
2026-10-11

LLM
AesCode 8B e 32B: Microsoft punta sul codice per la grafica generativa
2026-10-11
Hardware
Una GPU nel posto sbagliato? Hotspot più freddo di 19 gradi
2026-10-11
Hardware
RTX 4090 contraffatte: il rischio nascosto per l'inference on-premise
2026-10-11
Altro
DigUp porta EmbeddingGemma 2 in locale sul Mac
2026-10-10
Hardware
Nvidia fermerebbe la RTX 5090 per dare priorità alle GPU AI
2026-10-10