Digest Settimanale

📖 AI-Radar · 2026-W41

05 October – 11 October 2026  ·  60 articoli pubblicati

📁 LLM 17

LLM locali su 10-16GB di VRAM: la classifica e i compromessi reali

LLM locali su 10-16GB di VRAM: la classifica e i compromessi reali

Una classifica dal basso mette in fila i modelli eseguibili su GPU consumer con 10-16GB di VRAM e 26-32GB di RAM. L'attenzione è su velocità di almeno 10 token/s, coerenza, gestione di prompt complessi e presenza di pattern ripetitivi. Emergono vincoli concreti per chi valuta inference self-hosted: non solo dimensioni dei pesi, ma architetture MoE, quantization e limiti dei loader come Kobold e llama.cpp.

11 Oct #Hardware #LLM On-Premise #DevOps
Vega, il modello decisionale open-source da 800M parametri con 73k token

Vega, il modello decisionale open-source da 800M parametri con 73k token

Nandakishor M. ha rilasciato Vega, modello decisionale tipizzato basato su fisica con 800 milioni di parametri (variante 4B disponibile), supporto per 73.000 token e immagini, e risultati single-shot che superano molti benchmark JEV. L'architettura Test-Time Training estrae vettori dagli strati nascosti e simula una palla che rotola tra valli di esito, offrendo decisioni interpretabili su compiti come il rilevamento di injection.

10 Oct #Hardware #LLM On-Premise #Fine-Tuning
Freeze del decoder, healing dell'encoder: il tranello del learning rate condiviso

Freeze del decoder, healing dell'encoder: il tranello del learning rate condiviso

Un learning rate condiviso può fabbricare vantaggi inesistenti quando si confrontano ricette di fine-tuning con numeri di parametri diversi. Nella compressione SVD della KV-cache, l'healing solo dell'encoder sembrava superiore, ma con learning rate dedicati raggiunge la parità, mantenendo 3 volte meno parametri addestrabili e 3 volte meno memoria per l'ottimizzatore. Il risultato è un avvertimento metodologico per chi valuta metodi parameter-efficient.

09 Oct #Hardware #LLM On-Premise #Fine-Tuning
LittleBit e la corsa alla quantization ultra-low-bit per modelli minuscoli

LittleBit e la corsa alla quantization ultra-low-bit per modelli minuscoli

Un preprint su arXiv descrive LittleBit, un approccio di quantization ultra-low-bit basato su fattorizzazione latente e quantization aware training per modelli molto piccoli. La notizia interessa chi gestisce LLM on-premise: non si tratta solo di risparmiare spazio, ma di spostare l'inference su hardware con meno VRAM. Restano aperti i problemi di tooling e runtime, perché la compressione spinta richiede formati e operatori non sempre disponibili nei framework locali.

08 Oct #Hardware #LLM On-Premise #Fine-Tuning
Hirundo rimuove l'allineamento CCP da Qwen: censura al 2,8%

Hirundo rimuove l'allineamento CCP da Qwen: censura al 2,8%

Hirundo ha rilasciato versioni Westernized di Qwen3.6-35B-A3B e Qwen3.5-4B, usando il machine unlearning per rimuovere l'allineamento politico CCP dai pesi. Sul benchmark interno CCPC-500, la censura scende dall'89,8% al 2,8% per il 35B; i benchmark indipendenti DECCP e ChinaBench mostrano cali simili. Le capacità generali variano in media di 0,72 punti. Restano limiti: il 2,8% non è zero e CCPC-500 non è ancora pubblico.

08 Oct #LLM On-Premise #Fine-Tuning #DevOps
ASR per bambini: adattare il modello senza dimenticare gli adulti

ASR per bambini: adattare il modello senza dimenticare gli adulti

Uno studio su arabo e inglese confronta full fine-tuning, LoRA e weight-space merging per adattare i riconoscitori vocali al parlato infantile. L'adattamento è necessario, ma il fine-tuning diretto degrada le prestazioni sugli adulti. L'adattamento bilingue è più stabile e il merging pesa meglio il compromesso, con LERP per la retention e TIES per i guadagni sui bambini.

08 Oct #LLM On-Premise #Fine-Tuning
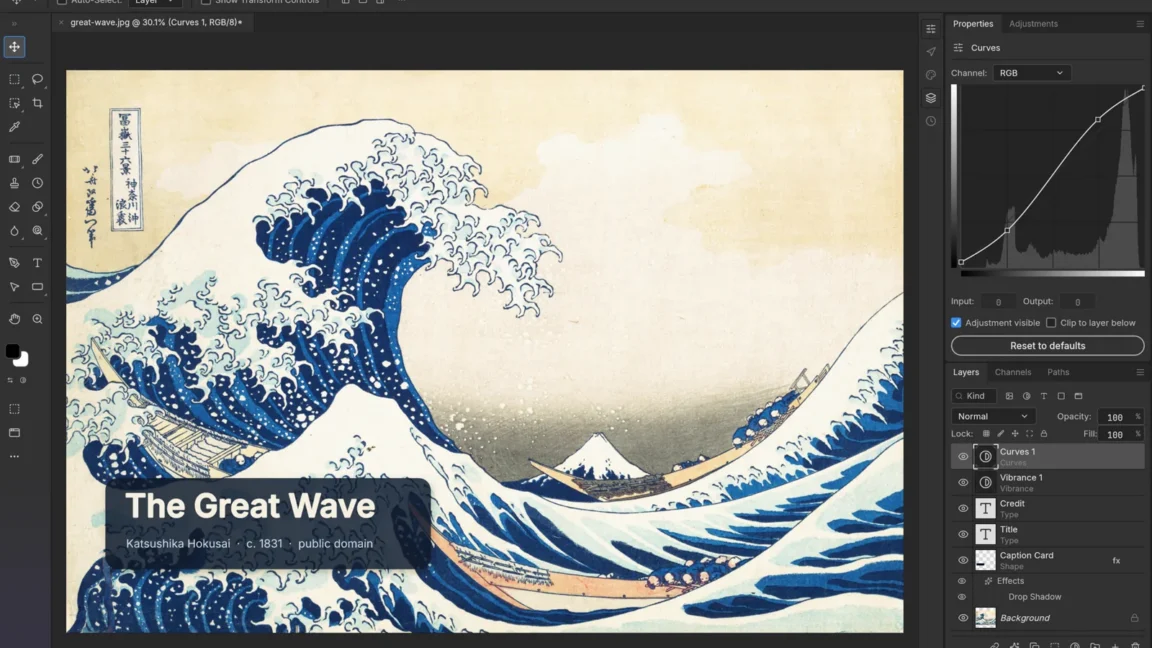
L'IA riscrive Photoshop e Premiere in Rust: il progetto ArtCraft sfida Adobe

L'IA riscrive Photoshop e Premiere in Rust: il progetto ArtCraft sfida Adobe

Il progetto ArtCraft ha usato Claude Code e agenti AI per creare reimplementazioni open-source clean-room di Photoshop, Premiere e Lightroom in Rust. L'iniziativa mostra come l'AI possa generare software complesso, ma solleva interrogativi legali sulla possibile contaminazione con codice proprietario. Per chi valuta alternative locali al Creative Cloud, il progetto è un segnale da osservare, non ancora uno strumento pronto.

08 Oct #LLM On-Premise #DevOps
GPT-6.1, il calo di throughput che riapre il fronte delle architetture ricorrenti

GPT-6.1, il calo di throughput che riapre il fronte delle architetture ricorrenti

Valori di throughput non ufficiali attribuiti ad Azure Foundry suggeriscono che GPT-6.1 Sol emetterebbe un token con due passaggi di inference invece di tre. I dati raccolti su artificialanalysis.com alimentano l'ipotesi di un'architettura ricorrente e di modelli annidati. Per chi valuta stack self-hosted, il nodo è metrico: il token/s non basta a stimare il costo computazionale reale.

06 Oct #Hardware #LLM On-Premise #DevOps
Mirror Particle costruisce una world model contro i limiti del roleplay LLM

Mirror Particle costruisce una world model contro i limiti del roleplay LLM

Mirror Particle si presenta al TechCrunch Disrupt Startup Battlefield con una world model costruita da zero per prevedere il comportamento umano. L'azienda sostiene che il roleplay dei Large Language Models non basta per ricerca di mercato e strategie di brand. L'analisi AI-RADAR collega questa mossa alla crescente necessità di modelli specializzati su dati proprietari e alle tensioni infrastrutturali tra cloud e deployment locale.

06 Oct #LLM On-Premise #DevOps

📁 Hardware 9

RTX 4090 contraffatte: la falla hardware dell'inference self-hosted

RTX 4090 contraffatte: la falla hardware dell'inference self-hosted

La circolazione di RTX 4090 contraffatte, quasi indistinguibili all'ispezione visiva e ai primi test software, trasforma l'acquisto di GPU consumer per LLM on-premise in un rischio strutturale. Il danno non si limita alla sostituzione: include instabilità sotto carico, benchmark inaffidabili e TCO più alto. Per chi punta su self-hosted e sovranità dei dati, la provenienza hardware diventa competenza infrastrutturale, non solo logistica.

11 Oct
Nvidia fermerebbe la RTX 5090 per dare priorità alle GPU AI

Nvidia fermerebbe la RTX 5090 per dare priorità alle GPU AI

Secondo indiscrezioni, Nvidia avrebbe sospeso la produzione della GeForce RTX 5090 per concentrare la capacità sulle GPU per data center AI e workstation professionali. La scelta segnala una priorità industriale netta: i margini del calcolo accelerato superano quelli del gaming. Per chi fa inference LLM self-hosted, la riduzione di schede consumer ad alta VRAM restringe le opzioni economiche e spinge verso hardware enterprise, con implicazioni su TCO e disponibilità.

10 Oct #Hardware #LLM On-Premise #Fine-Tuning
Vulkan e driver RADV: Valve allunga la vita delle GPU AMD Polaris su Linux

Vulkan e driver RADV: Valve allunga la vita delle GPU AMD Polaris su Linux

Il team Linux graphics di Valve, con Timur Kristóf, prosegue il lavoro sui driver open source per vecchie GPU AMD. Dopo la migrazione delle architetture GCN 1.0/1.1 al driver AMDGPU, ora migliora il supporto Vulkan RADV per le Radeon RX 400/500 Polaris. Un segnale per chi usa hardware locale a basso costo: la manutenzione dei driver allunga la vita operativa e riduce il TCO, pur senza trasformare queste schede in acceleratori AI moderni.

06 Oct #Hardware #LLM On-Premise #Fine-Tuning

📁 Altro 17

DigUp porta EmbeddingGemma 2 in locale sul Mac

DigUp porta EmbeddingGemma 2 in locale sul Mac

DigUp è un'app Mac gratuita e open source che esegue EmbeddingGemma 2 in locale per cercare nei file per contenuto, non per nome. Il modello GGUF Q8_0 da 865 MB gira su Apple Silicon via llama.cpp e Metal; la ricerca carica solo il text encoder da 250 MB e risponde in un decimo di secondo. Supporta testo, immagini, audio, video, codice e query in più lingue; va online solo per il download del modello e un controllo aggiornamenti disattivabile.

10 Oct #LLM On-Premise #DevOps
Qwen-Image-2.1-Turbo su Hugging Face: il nodo del self-hosting

Qwen-Image-2.1-Turbo su Hugging Face: il nodo del self-hosting

La presenza di Qwen-Image-2.1-Turbo su Hugging Face segnala un'opzione in più per chi vuole generare immagini in locale. La variante Turbo punta a ridurre la latenza, un aspetto critico per deployment self-hosted con VRAM limitata. Il repository diventa un banco di prova per valutare costi, controllo dei dati e integrazione nelle pipeline esistenti, senza dipendere da API cloud.

09 Oct #Hardware #LLM On-Premise #DevOps
Nvidia difende l’alleanza open source sull’AI: centinaia di aziende in coda

Nvidia difende l’alleanza open source sull’AI: centinaia di aziende in coda

Nvidia ha difeso l’Open Secure AI Alliance, coalizione ora gestita dalla Linux Foundation e nata pochi giorni dopo l’incidente Hugging Face. Mark Weatherford ha risposto ai dubbi sull’impegno dei membri e ha spiegato l’assenza di OpenAI: centinaia di aziende sono ancora in fase di verifica. Il pezzo analizza il peso strutturale del processo di ammissione per la governance open source e per chi valuta deployment self-hosted.

09 Oct #Hardware #LLM On-Premise #DevOps
Diffu-LoRA: il fine-tuning che decide dove allocare i parametri

Diffu-LoRA: il fine-tuning che decide dove allocare i parametri

Un nuovo metodo, Diffu-LoRA, introduce componenti low-rank con gate apprendibili nei blocchi Transformer dei modelli di diffusione. Un'ottimizzazione bilevel allena i pesi e i gate su split separati, mentre un pruning progressivo rimuove i componenti con valori più bassi. Il backbone resta congelato. Nei test con Stable Diffusion e DreamBooth, il metodo migliora fedeltà al soggetto e allineamento al prompt rispetto ai baseline di fine-tuning.

09 Oct #Hardware #LLM On-Premise #Fine-Tuning
llama.cpp sul palco: il self-hosted cambia fase

llama.cpp sul palco: il self-hosted cambia fase

Il titolo “llama.cpp on the stage” e un link bastano a segnalare un cambio di percezione. Il runtime C/C++ per inference locale non è più confinato ai repository GitHub: il suo palcoscenico pubblico legittima il deployment self-hosted come scelta strategica per TCO e sovranità dei dati. L’analisi esplora chi guadagna e chi perde quando la via locale smette di essere un compromesso.

07 Oct #Hardware #LLM On-Premise #Fine-Tuning
llama.cpp: una cache GPU per gli esperti MoE in memoria di sistema

llama.cpp: una cache GPU per gli esperti MoE in memoria di sistema

Una pull request su llama.cpp propone una cache GPU per gli esperti dei modelli MoE quando l’intero modello non entra in VRAM. L’idea mira a ridurre i trasferimenti dalla memoria di sistema, velocizzando l’inference locale su hardware con GPU modesta. Per chi valuta deployment self-hosted, la proposta tocca un punto chiave: sfruttare al meglio la RAM disponibile senza dover aumentare la VRAM.

07 Oct #Hardware #LLM On-Premise #DevOps
TEMPEST: embedding angolari per l'identificazione scalabile dei conducenti

TEMPEST: embedding angolari per l'identificazione scalabile dei conducenti

TEMPEST usa una Temporal Convolutional Network con loss ArcFace per produrre embedding angolari da finestre di guida multimodali di 60 secondi. Su 45 conducenti raggiunge il 91,71% di accuratezza Rank-1, superando il modello classico più performante di 17,9 punti e il baseline triplet-loss di 58,4. Con soli 720 mila parametri e 2,80 MB consente l'arruolamento dinamico senza riaddestramento. Il lavoro segnala un percorso concreto per l'identificazione biometrica dei conducenti in ottica edge e on-premise.

07 Oct #LLM On-Premise #Fine-Tuning #DevOps
LibreOffice e il 'no AI' come funzionalità: la privacy diventa strategia

LibreOffice e il 'no AI' come funzionalità: la privacy diventa strategia

La scelta di LibreOffice di non integrare funzioni AI nella configurazione predefinita, citando la privacy degli utenti, trasforma una rinuncia in un posizionamento di prodotto. Per chi gestisce documenti sensibili, l'assenza di elaborazione cloud è un vantaggio concreto. La mossa segnala una frattura tra suite AI-first e strumenti local-first, con riflessi su TCO, sovranità dei dati e decisioni di deployment.

06 Oct #LLM On-Premise #DevOps
Vates ottiene 30 milioni da IRIS e Bpifrance per l'espansione globale

Vates ottiene 30 milioni da IRIS e Bpifrance per l'espansione globale

Vates ha raccolto 30 milioni di euro da IRIS Growth e Bpifrance Large Venture. Il capitale accelererà la piattaforma di virtualizzazione open source, con investimenti su prestazioni, storage, sicurezza, automazione e gestione di infrastrutture su larga scala, oltre all'espansione commerciale in Nord America ed Europa. La mossa avviene mentre il mercato cerca alternative per controllo, sovranità e reversibilità.

06 Oct #LLM On-Premise #Fine-Tuning #DevOps
MCP: la fiducia tra agenti AI diventa un vettore di attacco

MCP: la fiducia tra agenti AI diventa un vettore di attacco

Google e altre quattro organizzazioni hanno riconosciuto vulnerabilità in cui un agente AI compromesso propaga istruzioni dannose ad altri agenti interni sfruttando lacune di fiducia nel Model Context Protocol. La tecnica è una forma di prompt injection che colpisce l’agente, non l’LLM, e può portare all’esfiltrazione di dati sensibili.

05 Oct #LLM On-Premise #DevOps

📁 Market 2

GLM 5.3 Flash e Mistral Large 4: il sorpasso che sposta il TCO

GLM 5.3 Flash e Mistral Large 4: il sorpasso che sposta il TCO

Due modelli aperti guidano l'Artificial Analysis Cyber Index e superano ogni singolo modello Anthropic. Il sorpasso non è solo classifica: sposta il calcolo del TCO dai canoni API all'infrastruttura on-premise, riapre il confronto su sovranità dei dati, quantization e gestione delle GPU. AI-RADAR analizza le implicazioni per chi valuta deployment locali, fine-tuning e stack self-hosted, oltre i riflessi su vendor cloud e system integrator.

10 Oct
ArtCraft riscrive Office in Rust con Claude: WordCraft gira su Surface Arm

ArtCraft riscrive Office in Rust con Claude: WordCraft gira su Surface Arm

ArtCraft aggiunge Word, Excel e PowerPoint alle sue applicazioni Rust, definite reimplementazioni clean-room. WordCraft gira su un Surface Arm ed è stimato al 62% di parità funzionale, ma resta pre-alpha e senza test di compatibilità DOCX su file reali. Lo sviluppo usa Claude in modo intensivo. La questione legale resta aperta, mentre Microsoft e Adobe non hanno commentato.

08 Oct

📁 Frameworks 12

Boro, la scommessa open source di NVIDIA sull'AI locale per il kernel Linux

Boro, la scommessa open source di NVIDIA sull'AI locale per il kernel Linux

NVIDIA sviluppa Boro, una CLI in Rust per lo sviluppo del kernel Linux assistito da AI locale. L'approccio privilegia l'esecuzione on-premise, segnando un cambio di peso verso strumenti che non dipendono dal cloud e che pongono il controllo del codice al centro. Per team che lavorano su infrastrutture critiche, la notizia ha implicazioni concrete su sovranità e flusso di lavoro.

09 Oct #Hardware #LLM On-Premise #DevOps
Synthesis Through Simulation: il framework SAP per dati enterprise senza schema

Synthesis Through Simulation: il framework SAP per dati enterprise senza schema

SAP ha reso open source Synthesis Through Simulation, un framework che genera dati enterprise sintetici tramite interazione tra agenti LLM e API in ambienti simulati. L'approccio elimina la necessità di schemi database, garantendo validità strutturale per costruzione. Il Generalist Populator raggiunge fedeltà marginale media di 0,88 e soddisfazione dei vincoli del 100% su dieci ambienti. Rilevante per chi valuta deployment on-premise e sovranità dei dati.

09 Oct #LLM On-Premise #Fine-Tuning #DevOps
llama.cpp apre a GLM 5 Flash MTP: il locale si allarga

llama.cpp apre a GLM 5 Flash MTP: il locale si allarga

Una pull request nel repository di llama.cpp introduce il supporto per GLM5Next MTP; la segnalazione su Reddit conferma la possibilità di eseguire GLM 5 Flash MTP in locale. Per chi valuta deployment self-hosted, il passaggio allarga il parco modelli utilizzabili senza cloud, con implicazioni su sovranità dei dati, TCO e pipeline di inference.

07 Oct #Hardware #LLM On-Premise #DevOps
Agent Lightning 1.0: addestrare agenti con l’harness reale, in 3.500 righe

Agent Lightning 1.0: addestrare agenti con l’harness reale, in 3.500 righe

Microsoft Research Asia ha rilasciato Agent Lightning 1.0, un framework RL di circa 3.500 righe che addestra l’agente usando direttamente l’harness di produzione, senza servizi sandbox commerciali. Gira su Kubernetes, su cluster self-managed, cloud o infrastruttura locale. Con circa 6.000 campioni, una pipeline basata su Qwen3.5-9B sale dal 41,8% al 56,4% Pass@1 su SWE-bench Verified.

07 Oct #Hardware #LLM On-Premise #Fine-Tuning
Guida esterna nei LLM: il bias non si elimina, si calibra

Guida esterna nei LLM: il bias non si elimina, si calibra

Il framework GA-GRPO formalizza la guida esterna nel fine-tuning di LLM reasoning come un operatore che introduce bias misurabile in base alla divergenza tra guida e policy. La teoria mostra che il bias è inevitabile e cresce nel tempo, ma il peso ottimale della guida diminuisce con l'avanzare dell'addestramento. Un test con Qwen2.5-Math-7B su nove benchmark mostra un risparmio del 31% di GPU-ore, con implicazioni dirette per il TCO dei deployment on-premise e self-hosted.

07 Oct
FluidPD: elasticità in-place per il serving LLM prefill-decode

FluidPD: elasticità in-place per il serving LLM prefill-decode

FluidPD affronta il disallineamento tra prefill e decode nel serving LLM senza aggiungere worker. FluidToken scarica parte del prefill sui worker di decode quando c'è margine; FluidRole riassegna i ruoli in esecuzione senza ricaricare il modello. Su tracce Azure, il raggiungimento degli SLO migliora fino a 94,6 punti percentuali rispetto a SGLang statico. Un segnale per chi gestisce capacità fissa: l'elasticità non è solo provisioning.

07 Oct #Hardware #LLM On-Premise #DevOps
ROCm 10.1: il ciclo di sei settimane diventa la vera notizia

ROCm 10.1: il ciclo di sei settimane diventa la vera notizia

AMD ha rilasciato ROCm 10.1, poche settimane dopo ROCm 10.0 di fine agosto, confermando il ciclo di aggiornamenti ogni sei settimane. La notizia rilevante non è solo il nuovo pacchetto, ma la cadenza: per chi usa GPU AMD in ambienti self-hosted, la prevedibilità degli aggiornamenti conta quanto le funzionalità. Il ritmo serrato segnala un cambio di passo nella maturità dello stack software.

05 Oct #Hardware #LLM On-Premise #Fine-Tuning
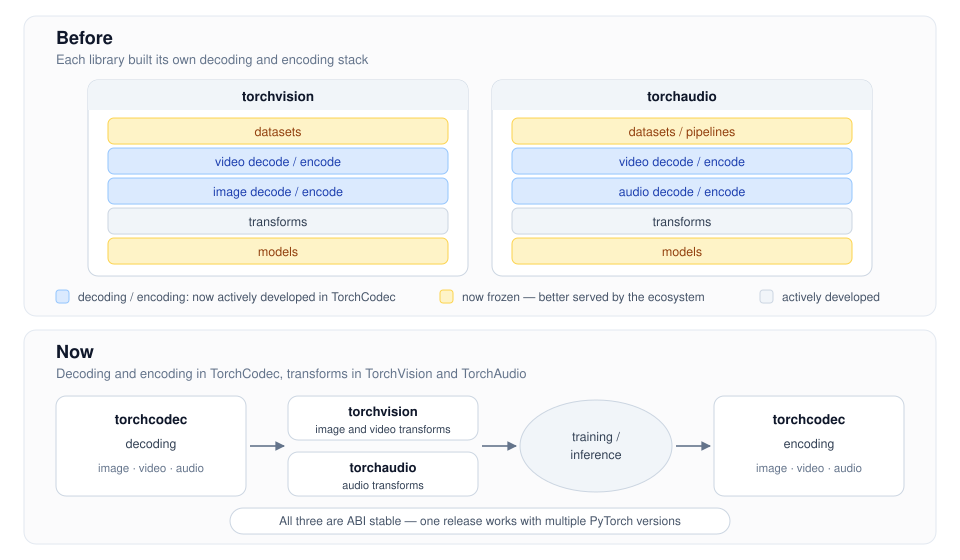
PyTorch mette ordine nello stack media: I/O in TorchCodec, il resto si specializza

PyTorch mette ordine nello stack media: I/O in TorchCodec, il resto si specializza

Il team PyTorch ha consolidato decodifica e codifica di immagini, video e audio in TorchCodec. TorchVision e TorchAudio ora si concentrano sulle trasformazioni, mentre modelli e dataset passano all'ecosistema Hugging Face. La mossa semplifica dipendenze e build, migliora le prestazioni CUDA e rende le librerie ABI stabili. Per chi deploya pipeline locali, significa uno stack multimediale più manutenibile e indipendente dal ritmo di rilascio di PyTorch.

05 Oct #Hardware #LLM On-Premise #Fine-Tuning

📁 OnPremise 3

SAP simula l'azienda: dati sintetici senza schema e il nuovo perimetro sovrano

SAP simula l'azienda: dati sintetici senza schema e il nuovo perimetro sovrano

Il framework Synthesis Through Simulation di SAP genera dati sintetici aziendali facendo operare un agente LLM contro API che applicano policy simulate, senza accedere agli schemi database. La validità strutturale nasce per costruzione, non per estrazione. Per le infrastrutture self-hosted cambia il calcolo di sovranità e TCO: la pipeline locale dalla simulazione al fine-tuning riduce dipendenza da cloud e approvazioni legali, ma sposta il rischio sulla fedeltà dell'ambiente simulato.

09 Oct
LiteBox: il sandbox locale diventa un tassello per l’AI on-premise

LiteBox: il sandbox locale diventa un tassello per l’AI on-premise

Microsoft ha pubblicato il primo rilascio taggato di LiteBox, sandbox in Rust per isolare Linux su Linux e Linux su Windows. Il segnale è la maturità: un isolamento più forte dei container, portabile cross-OS, utile per pipeline LLM self-hosted. Riduce la dipendenza da sandbox cloud e rafforza sovranità. Restano da valutare overhead, superficie d'attacco e integrazione operativa.

08 Oct
ROCm 10.1: la cadenza software che riscrive il TCO on-premise

ROCm 10.1: la cadenza software che riscrive il TCO on-premise

ROCm 10.1 conferma il ciclo di sei settimane di AMD per lo stack GPU. Più delle singole funzionalità, conta la prevedibilità: per i deployment self-hosted riduce il rischio di restare bloccati su versioni vecchie e rende il software parte governabile della pipeline. La maturità dello stack entra nel TCO accanto a VRAM e prestazioni. Restano incognite su compatibilità dei framework, SKU e qualità dei rilasci.

06 Oct
← 2026-W40 Tutte le notizie 2026-W42 →